字节笔记本
2026年10月5日 · 约 20 分钟读完
DeepSeek V4-Pro 解读:价格打到九分之一
DeepSeek 又放大招了。这次 V4 系列双发:旗舰 DeepSeek-V4-Pro 与轻量 DeepSeek-V4-Flash 同台亮相,而社区热议的 DeepSeek-V4-Pro-DSpark,其实是同一个 Pro 检查点加上推测解码加速模块的版本。它的核心数字很漂亮:1.6 万亿参数(1.6T)、每 token 激活 490 亿(49B)、100 万 token 上下文、输出价格约 $0.87/百万 token,约为 Claude Opus 4.7 的 1/9,而 DSpark 后缀还让推理更快。
这篇文章就来拆解这个「把价格打穿」的模型:架构上有什么新东西,DSpark 到底是什么,以及它对整个 AI 模型市场意味着什么。
一、先看硬规格:V4-Pro 是什么级别
DeepSeek V4 系列这次同时发了两个模型:Pro(旗舰)和 Flash(轻量):
| 规格 | V4-Pro | V4-Flash |
|---|---|---|
| 总参数 | 1.6 万亿(1.6T) | 2840 亿(284B) |
| 每 token 激活参数 | 490 亿(49B) | 130 亿(13B) |
| 上下文长度 | 100 万 token(1M) | 100 万 token |
| 精度 | FP4 + FP8 混合 | FP4 + FP8 混合 |
| 预训练数据 | 32 万亿 token(32T) | 同 |
| 协议 | MIT(完全开源) | MIT |
1.6T 总参数 + 49B 激活,这是典型的 MoE(混合专家)架构:模型有 1.6 万亿个参数,知识容量极大,但每次推理只激活其中 49B(约 3%),等于用大模型的智力,花小模型的钱。
对比参照:
- GPT-5.4:参数未公开,但价格远高于 V4-Pro
- Claude Opus 4.7:闭源,输出约 $7.6/百万 token
- DeepSeek V4-Pro:输出约 $0.87/百万 token(约 Opus 的 1/9)
DeepSeek-V4-Pro-Max(最大推理努力模式)被官方定位为「当今最强开源模型」:在编码 benchmark 上达到顶级,在推理和 agent 任务上大幅缩小了与闭源模型的差距。
二、三个架构创新:为什么又快又便宜
官方模型卡列了三个核心架构升级,每一个都是为「百万上下文 + 低成本」服务的。
1. 混合注意力架构(CSA + HCA)
这是最大的创新。V4 设计了 Compressed Sparse Attention(压缩稀疏注意力,CSA)+ Heavily Compressed Attention(重度压缩注意力,HCA) 的混合机制。
效果有多惊人?官方数据:在 100 万 token 上下文设置下,V4-Pro 只需要 V3.2 版本的:
- 27% 的单 token 推理 FLOPs,计算量降到不到三分之一
- 10% 的 KV cache,缓存内存降到十分之一
这是「百万上下文」能廉价跑起来的关键。 以前的百万上下文模型,上下文越长推理越贵越慢。V4 用混合注意力把长上下文的成本压了下来:27% FLOPs 意味着同样的算力能服务 3.7 倍的请求。
2. Manifold-Constrained Hyper-Connections(mHC)
传统 Transformer 的残差连接(residual connection)在超深、超宽模型里会出现信号传播不稳定的问题。V4 引入 mHC(流形约束超连接) 来强化残差路径,提升信号跨层传播的稳定性,同时保留模型表达能力。
简单说,就是让 1.6T 参数的超大模型训练更稳、收敛更好。这是大模型训练工程的核心难题之一。
3. Muon 优化器
训练用的优化器从 AdamW 换成了 Muon,据称收敛更快、训练更稳定。优化器是大模型训练的「引擎」,换优化器等于换发动机。
三、DSpark 是什么:不是新模型,是让推理快约 80% 的加速模块
标题里的 「DSpark」 后缀很容易让人以为是新模型,但官方模型卡明确说了:
Note: DeepSeek-V4-Pro-DSpark is not a new model. It is the same checkpoint with an additional speculative decoding module attached.
(注意:DSpark 不是新模型。它是同一个 V4-Pro 检查点,附加了一个推测解码模块。)
社区讨论给出的关键数字是:DSpark 让推理速度提升约 80%,并且已经部署在 DeepSeek-V4(Flash 和 Pro)的真实线上流量中。也就是说,你现在调用 DeepSeek 官方 API,已经在享受这个加速了。
先说 Speculative Decoding(推测解码)是什么
这是一种推理加速技术:
- 用一个小模型(draft model)快速「猜」接下来几个 token
- 用大模型(V4-Pro)并行验证这些猜测
- 猜对的直接采用,猜错的让大模型重新生成
效果是:大模型不用逐 token 串行生成,而是批量验证小模型的猜测,吞吐量大幅提升。
DSpark 的两个创新(来自论文)
DSpark 的完整论文标题透露了它的两项核心技术:《DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation》,即置信度调度的推测解码,配合半自回归生成。拆开看:
创新一:Confidence-Scheduled(置信度调度)
传统推测解码的痛点,是小模型猜的 token 经常出错,大模型要逐个验证、逐个拒绝,浪费算力。
DSpark 的解法是用置信度来调度:小模型每猜一个 token,同时输出自己对这次猜测的「自信程度」。置信度低的 draft token 直接跳过验证:既然小模型自己都不信,大模型就不用浪费时间验证了。
这等于给推测解码装了一个「质检员」,提前剔除大概率出错的猜测,只把高置信度的结果交给大模型验证。算力浪费大幅减少,有效吞吐自然就上去了。
创新二:Semi-Autoregressive(半自回归生成)
传统自回归生成是严格的「一个接一个」:token N 必须等 token N-1 算完才能开始,这种串行是速度瓶颈。
半自回归打破了「严格一个接一个」的限制,允许在某种程度上并行猜测多个 token。结合置信度调度,DSpark 能在保证质量的前提下成批生成 token,而不是逐个等待。
论文摘要给出的受控对比结论是:同等吞吐水平下,单用户生成速度提升 60% 到 85%;两项创新叠加,最终换来线上约 80% 的加速。这不是靠更快的硬件,而是靠更聪明的算法,把同样的算力压榨出近一倍的吞吐。
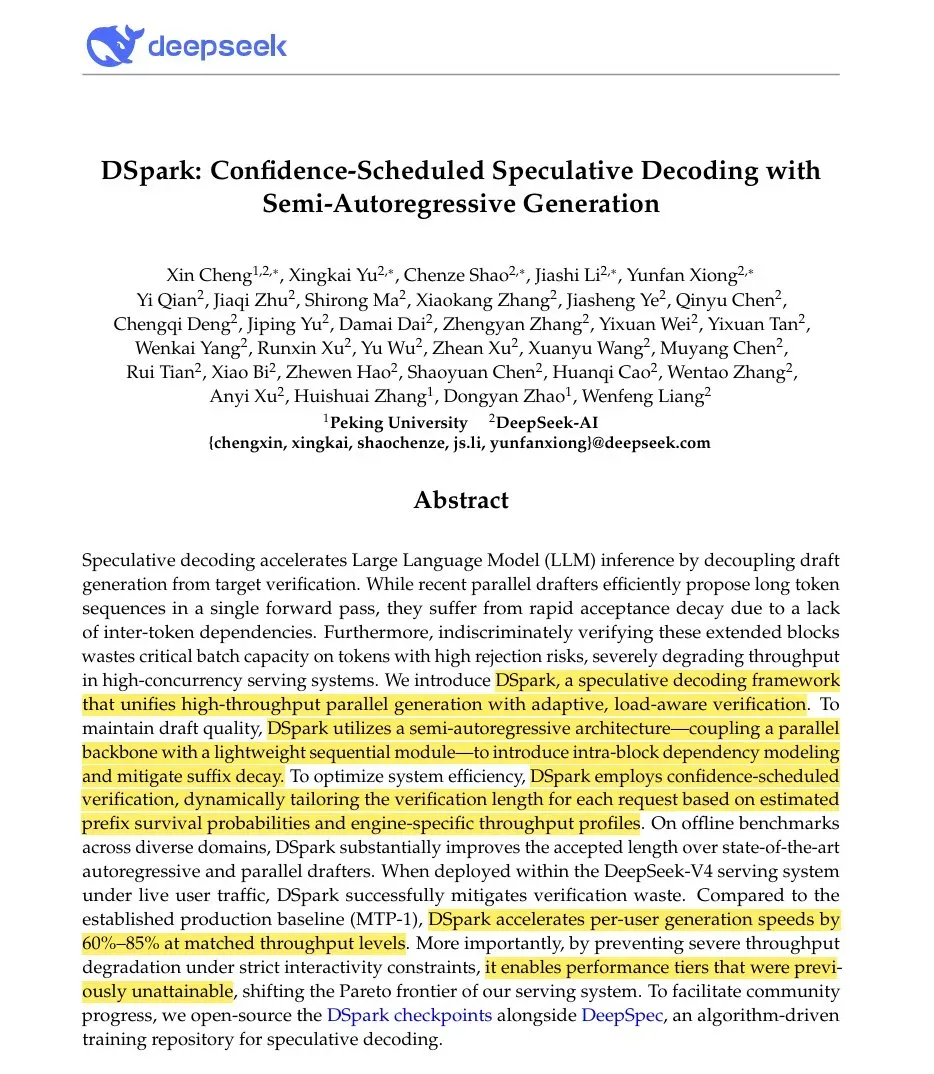
DSpark 论文首页:部署于 DeepSeek-V4 线上服务系统后,同等吞吐水平下单用户生成速度提升 60% 到 85%。
代码开源在 DeepSpec
DSpark 的实现开源在 deepseek-ai/DeepSpec 仓库,V4 的 inference/ 目录里还有最小推理示例。
所以 DSpark 的意义是:模型本身不变,质量不变,但推理速度变快约 80%。 这对 API 用户是纯利好:同样的价格,近两倍的响应速度。对自建推理的团队更是福音:同样的 GPU 集群,服务能力接近翻倍。
工程级数据:DSpark vs MTP,约 5 倍成本压缩
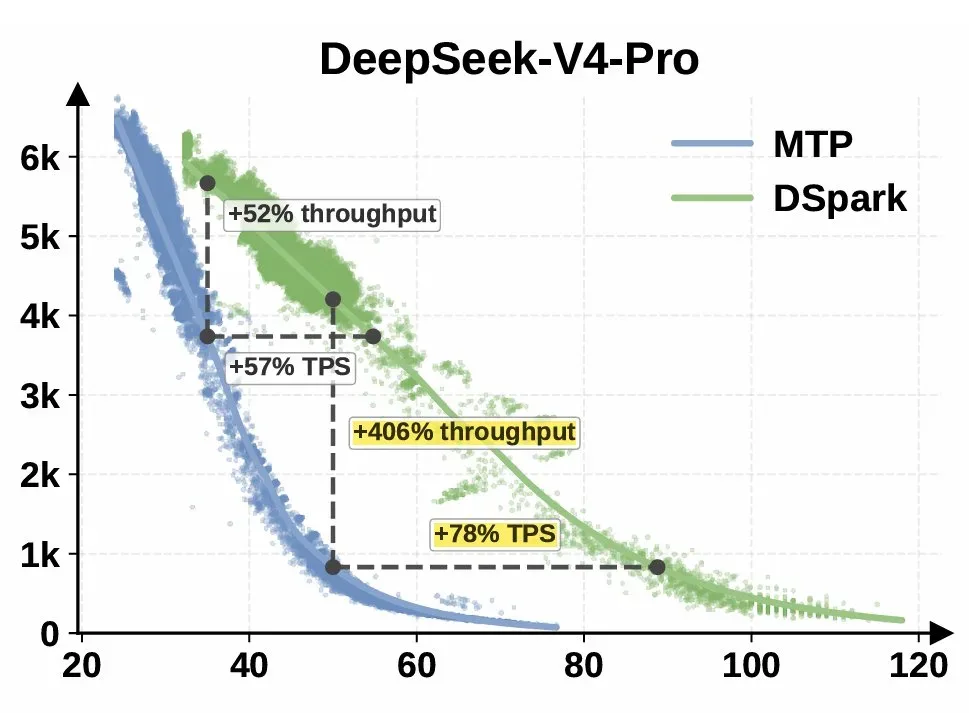
光说「快 80%」还不够具体。工程侧更硬的指标是:DeepSeek 在 50 TPS(每秒 50 个 token)的目标速度下,推理成本便宜了约 5 倍。
这个 5 倍是怎么来的?看官方那张 DSpark vs MTP 的对比图:
DeepSeek-V4-Pro 上,DSpark(绿)与 MTP(蓝)在不同并发下的吞吐/TPS 对比。
MTP(Multi-Token Prediction) 是 DeepSeek 上一代的推测解码方法,V3 就在用,DSpark 是它的升级版。图表揭示的关键数据:
| 并发场景 | DSpark 相对 MTP 的提升 |
|---|---|
| 高并发(约 40 并发) | +52% throughput,+57% TPS |
| 中并发(约 60 并发) | +406% throughput(最惊人,4 倍多) |
| 低并发(约 90 并发) | +78% TPS |
核心洞察:DSpark 不是匀速提升,而是在中并发段提升最猛(4 倍)。这个特点对生产部署极有价值:大多数线上服务跑的就是中并发,DSpark 恰好在最常用的负载区间效果最好。
为什么中并发提升最大?推测解码的本质是「用算力换吞吐」:并发太低时,每个请求的 draft 验证开销占比大;并发太高时,GPU 已经被喂饱,加速空间小。中并发是 DSpark 的甜蜜点:既能让小模型高效并行猜测,又不至于让大模型验证成为瓶颈。
对成本的实际影响:在 50 TPS 这个目标速度下,DSpark 把达到同样 TPS 所需的 GPU 算力降到约 1/5。翻译成钱:同样的预算,能服务 5 倍的流量。
这也解释了为什么 DeepSeek 能把 API 价格打到 Opus 的 1/9:不是赔本赚吆喝,而是 DSpark 让单位算力的产出翻了数倍,成本结构真真切切地降下来了。
四、V4-Flash:被低估的那个
V4-Pro 抢尽风头,但 V4-Flash 可能是更实用的那个:284B 总参、13B 激活,输出价格约 $0.28/百万 token。
官方的说法很有意思:
DeepSeek-V4-Flash-Max achieves comparable reasoning performance to the Pro version when given a larger thinking budget, though its smaller parameter scale naturally places it slightly behind on pure knowledge tasks and the most complex agentic workflows.
(Flash-Max 在给予更大思考预算时,能达到与 Pro 版相当的推理性能。但由于参数规模更小,在纯知识任务和最复杂的 agent 工作流上自然略逊。)
翻译成人话:Flash 在「推理」上能追上 Pro,只要给够思考 token;但在「知识」(参数量决定)上要差一些。这意味着:
- 简单 agent 任务、日常编程、文本处理 → 用 Flash 就够,省 3 倍钱
- 复杂推理、需要海量知识的任务 → 用 Pro
这就是经典的「模型路由」思路:不同任务交给不同的模型,V4-Pro 与 V4-Flash 一强一省,天然适合搭配使用。
五、FP4 精度:把价格打下来的另一个秘密
V4 用了 FP4 + FP8 混合精度:MoE 专家参数用 FP4(4 位浮点),其余参数用 FP8。
FP4 是什么概念? 一个参数只用 4 个比特存储。相比传统的 FP16(16 位),显存占用降到 1/4;相比 FP8,再降一半。
这是激进但聪明的选择:
- 4 位量化在大多数场景下质量损失可接受
- 显存省了,同样的 GPU 就能跑更大的模型、服务更多并发
- 省下的硬件成本直接转化为价格优势
DeepSeek 能把价格打到 Opus 的 1/9,FP4 是关键之一。 它在「精度与成本」的权衡里果断选了成本,而实测质量仍然顶级,说明 FP4 的损失在可控范围。
六、训练范式:领域专家独立培养,再统一融合
V4 的后训练有一个值得说的设计,分两阶段:
阶段一:领域专家独立培养
- 通过 SFT(监督微调)和 RL(强化学习,用 GRPO)独立训练不同领域的专家能力
- 比如 coding 专家、math 专家、reasoning 专家各自训练
阶段二:统一模型融合
- 通过 on-policy distillation(在线策略蒸馏) 把不同领域的专长融合进一个模型
- 把「多个专家」变成「一个通才」
这个范式解决了「通才与专家」的老矛盾:先专后通,既有深度又有广度。它和业界多智能体协作里「先分化专精、再统一协作」的思路异曲同工。
七、价格战的意义:DeepSeek 的战略
看这条价格线:
- DeepSeek V3:已经极便宜
- DeepSeek V4-Pro:输出 $0.87/M(Opus 4.7 的 1/9)
- DeepSeek V4-Flash:输出 $0.28/M(更便宜)
一句话,DeepSeek 在做「AI 模型的拼多多」,用价格换规模。这个战略的逻辑是:
- AI 模型的边际成本在快速下降:更好的架构、FP4、MoE,都在往同一个方向使劲
- 谁先占领开发者心智,谁就占住生态:各类 agent 框架与开发工具都优先适配 DeepSeek
- 低价是占领心智的最快方式
对消费者(开发者/企业)是巨大利好:同样质量的模型,价格只有闭源的零头。这也是为什么大量「自带模型」的工具都把 DeepSeek 列为首选平价模型。
八、MIT 协议:完全开源的分量
V4 全系列都是 MIT 协议,这是最宽松的开源协议之一。意味着:
- 商用免费:企业可以免费用 V4 做产品
- 可修改:可以微调、剪枝、改造
- 可再分发:可以打包再分发
- 无附加条件:没有「超过一定用户规模需单独授权」之类的限制
MIT 协议 + 1.6T 参数 + 顶级质量,这是开源 AI 的里程碑。它意味着任何公司都能拿 V4 自建推理服务,不被任何 API 厂商卡脖子。
这也是为什么 V4 对闭源模型(Claude/GPT)的威胁格外大:它不只是便宜,它是「你可以自己拥有」的。
九、怎么用
直接用官方 API
DeepSeek 官方入口:chat.deepseek.com 与 platform.deepseek.com。
第三方平台
- NVIDIA NIM:
deepseek-v4-pro - DeepInfra:托管 V4-Pro
- MorphLLM 等 API 聚合平台
本地/自建
模型在 HuggingFace 和 ModelScope 开放下载(MIT 协议)。但要注意,1.6T 参数的模型需要极其专业的硬件(多卡 H100/H200 集群)才能本地推理,个人跑 V4-Pro 不现实;V4-Flash(284B)在高端多卡工作站上可能可行。
在工具链里接入
DeepSeek 提供 OpenAI 兼容接口,几乎所有支持自定义 provider 的工具都能直接接:多模型编排客户端可以把它配置成主力或备用模型,按任务在 Pro 与 Flash 之间路由;翻译、转录摘要这类高频调用场景用它尤其划算;在 Claude Code/Codex 这类编码工具里,也可以通过切换器把后端模型换成 DeepSeek 来降低成本。
十、对行业意味着什么
拆完整个 V4,它对行业的冲击有几层:
1. 开源追上闭源的速度在加快
V4-Pro-Max 在编码上达到顶级,推理上大幅缩小差距。从 GPT-4 到现在不到三年,开源模型已经能和闭源旗舰掰手腕。闭源的「质量护城河」在变浅。
2. 价格战会持续
DeepSeek 把价格打到 1/9,会逼着 OpenAI/Anthropic 降价或提升性价比。这对所有 AI 用户都是利好。AI 正在从「奢侈品」变成「水电煤」。
3. MoE + FP4 成为主流配方
V4 证明了「超大 MoE + FP4 + 混合注意力」这个组合的可行性。可以预见,接下来会有很多模型跟进这个架构方向。
4. 「百万上下文」不再是奢侈品
V4 把百万 token 上下文的成本压到 V3 的 27% FLOPs / 10% KV cache。这意味着长文档分析、大型代码库理解、超长对话都不再是天价。长上下文的杀手级应用会因此爆发。
十一、小结
一句话总结:DeepSeek V4-Pro 是 1.6T 参数、49B 激活、百万上下文的开源 MoE 旗舰,FP4 混合精度把价格打到 Claude Opus 的 1/9;DSpark 后缀是推测解码加速模块(置信度调度 + 半自回归,推理快约 80%,已上线上流量),MIT 协议完全开源。
对开发者来说,你有了又一个质量顶级、价格地板价、完全开源的模型选择。无论是直接调 API、自建推理,还是在各类工具里接入,V4 都让「用得起 AI」这件事变得更容易。
而对整个行业,DeepSeek 是那条逼着鲨鱼(闭源旗舰)游得更快的鲶鱼。它存在本身,就让所有 AI 用户受益。
本文基于 DeepSeek-V4-Pro 官方模型卡、DSpark 论文与社区公开讨论整理。模型:https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro-DSpark ,DSpark 代码:https://github.com/deepseek-ai/DeepSpec 。DSpark 为推测解码模块而非新模型,线上同等吞吐下单用户生成速度提升 60% 到 85%,50 TPS 下成本压缩约 5 倍,价格以各平台实时报价为准。技术细节还可参考:DSpark 论文解读(xyzlabs)、36Kr 报道、华尔街见闻。