字节笔记本
2026年10月5日 · 约 7 分钟读完
LeetCUDA:200 道实战题练出 cuBLAS 性能
学 CUDA 最痛苦的不是「不会写」,而是「写完跑不快」。入门教程只讲到 thread 和 block 的基本概念,进阶优化技巧却散落在论文和博客里,一条技巧一篇文章,很少有人系统地带你从「能写」走到「写得又快又稳」。GitHub 上的开源项目 LeetCUDA(xlite-dev/LeetCUDA,目前约 12k stars,GPL-3.0 协议)针对的就是这个断层:200 多道循序渐进的 CUDA Kernel 实战题,一套性能达到 cuBLAS 98% 到 100% 的 HGEMM 库,外加 100 多篇高性能计算技术博客。
一、它是什么
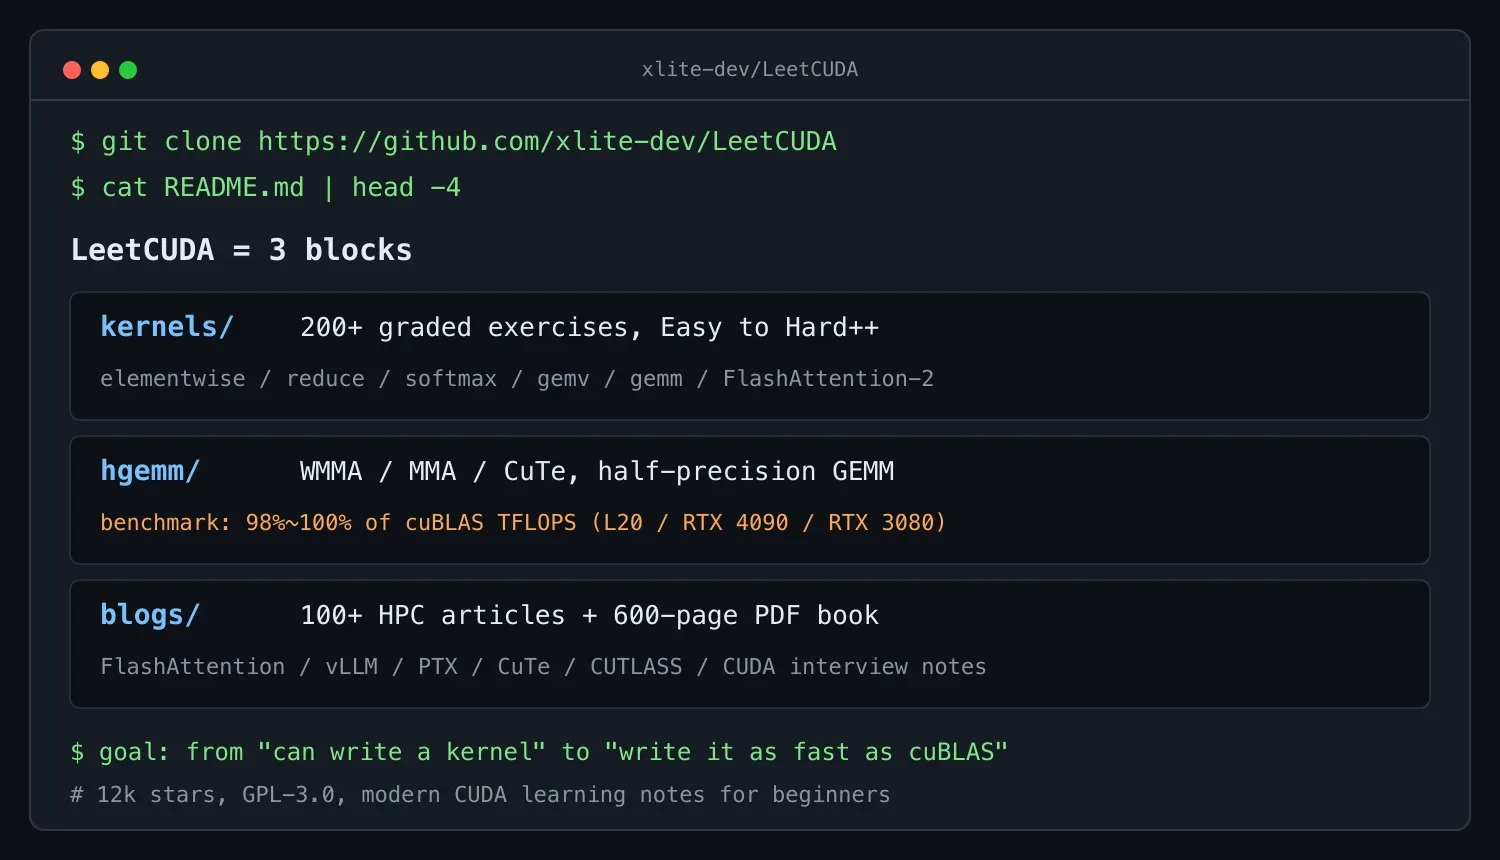
LeetCUDA 是一份系统化的 CUDA 进阶教程,作者把它定位成「面向初学者的现代 CUDA 学习笔记开源书」。整个项目由三部分组成:
- 200+ 道 Kernel 实战题:按 Easy 到 Hard++ 分级,从 elementwise(relu、gelu)、histogram 这类基础题,一直排到 FlashAttention-2 这类完整算子,另设 Triton 与 CUTLASS 专区;
- 一套 HGEMM(半精度矩阵乘)库:覆盖 WMMA、MMA、CuTe 三条实现路径,在 L20、RTX 4090、RTX 3080 Laptop 上实测达到 cuBLAS TFLOPS 的 98% 到 100%;
- 100+ 篇技术博客与一本 PDF 教材:博客覆盖 FlashAttention、vLLM、PTX 汇编、CuTe/CUTLASS 等主题,配套的 LeetCUDA.pdf 有 600 多页、40 多章。
它的定位不是教你 CUDA 语法,而是帮你跨过「能跑就行」这道坎,把代码写到生产级性能。
二、它解决什么问题
学 CUDA 有个常见的「天花板」现象:
入门阶段:能写 elementwise、reduce 这类基础 kernel,感觉学会了
进阶阶段:想优化 GEMM,才发现 tiling、shared memory、向量化访存、
         双缓冲、Tensor Core 一大堆技巧
         每个技巧都是单独一篇论文或博客
         不知道怎么系统组合,于是卡住
LeetCUDA 的解法是把优化技巧编排成 200 多道递进练习:每道题只引入一两个新概念,题目之间前后衔接,组合起来就是一条完整的 GEMM 优化路径。你不需要自己从几十篇资料里拼凑知识图谱,顺着题目做下去即可。
三、学习路径:六个阶段
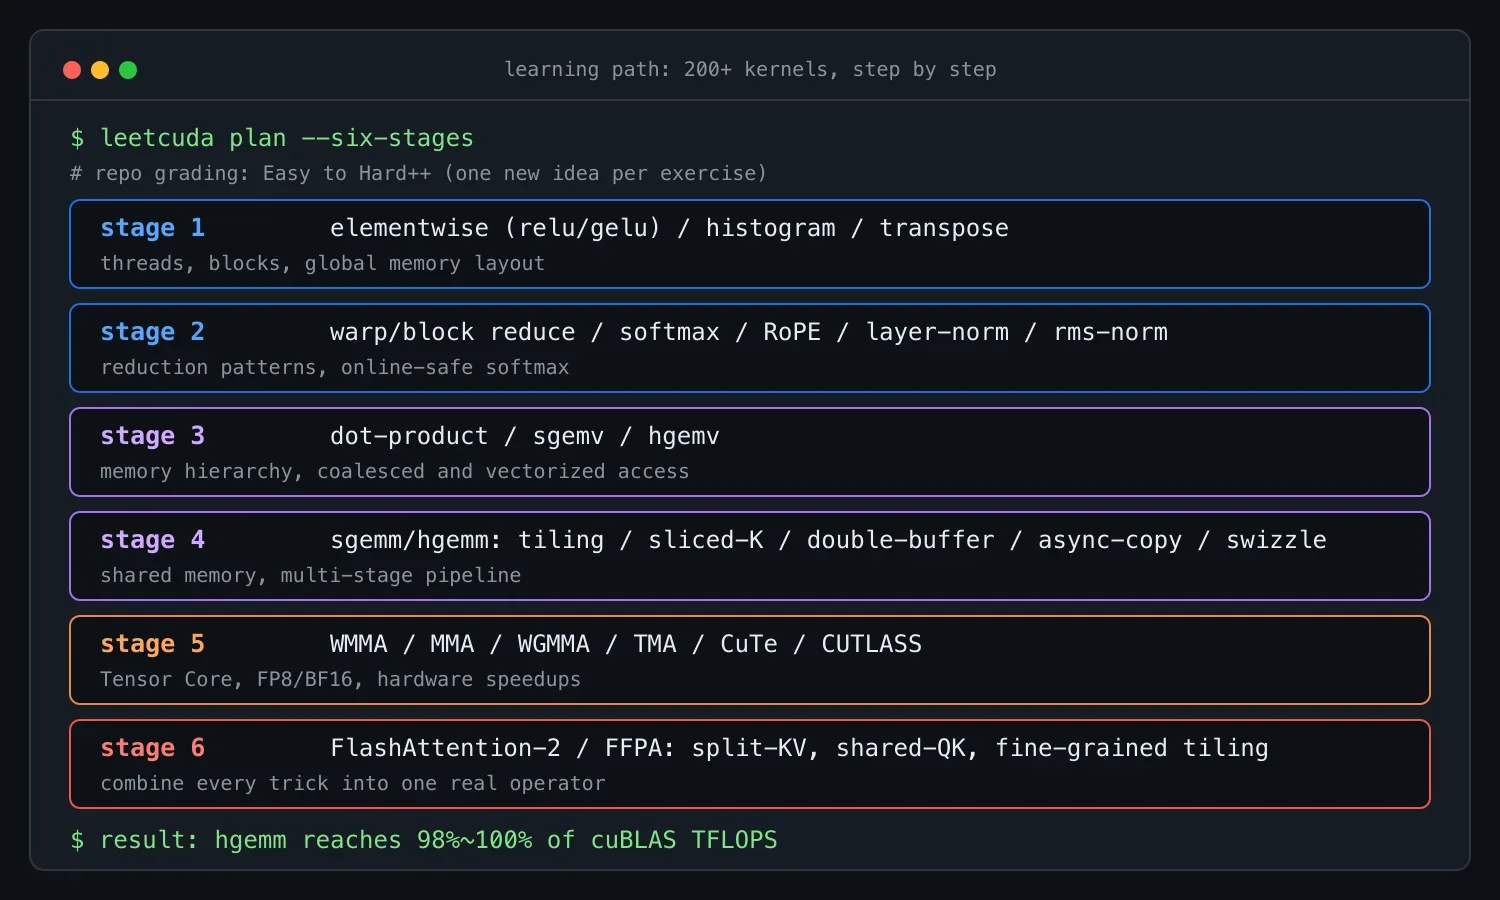
仓库把题目按 Easy 到 Hard++ 分级,下面的六阶段是按内容递进做的归纳:
| 阶段 | 代表题目 | 练什么 |
|---|---|---|
| 一 | elementwise、histogram、矩阵转置 | 熟悉 thread 组织与全局内存访问 |
| 二 | warp/block reduce、softmax、RoPE、layer norm | 掌握规约模式与数值稳定性 |
| 三 | dot product、sgemv、hgemv | 理解内存层次与带宽瓶颈 |
| 四 | sgemm/hgemm:tiling、sliced K、双缓冲、async copy、swizzle | 把带宽和流水线榨干 |
| 五 | WMMA、MMA、WGMMA、TMA、CuTe/CUTLASS | 用 Tensor Core 与异步搬运加速 |
| 六 | FlashAttention-2、FFPA | 组合全部技巧做完整注意力算子 |
每一级都建立在上一级的产出之上:到了第四阶段,前面练过的向量化访存、规约、双缓冲会全部汇入 sgemm/hgemm 的优化循环里。
四、核心成果:HGEMM 达到 cuBLAS 98% 到 100%
最有说服力的是项目最终实现的 HGEMM 性能:在 L20、RTX 4090、RTX 3080 Laptop 三块显卡上,半精度矩阵乘实测达到 NVIDIA cuBLAS TFLOPS 的 98% 到 100%。这意味着跟着做完这条路径,你手写的矩阵乘可以和官方库一样快。对一个教学向的开源项目来说,这个基准的价值在于每一步优化都有可验证的真实收益,而不是停留在演示代码的层面。
五、100 多篇博客补足理论
| 主题 | 内容 |
|---|---|
| CUDA 面试题 | 高频考点与底层原理拆解 |
| PTX 汇编 | 从指令层面理解 kernel 行为 |
| FlashAttention | 注意力算子优化逐步拆解 |
| vLLM | 推理引擎里的 CUDA 实战 |
| CuTe/CUTLASS | NVIDIA 官方抽象与模板库用法 |
| 分布式系统 | 高性能计算相关的分布式主题 |
实战题负责「练」,博客负责「懂」,二者对照着读,遇到跑不快的 kernel 时能定位到具体是访存、流水线还是 Tensor Core 利用率的问题。
六、谁适合学
- 做 AI 或深度学习,需要写自定义 Kernel 加速模型;
- 做 GPU 编程、HPC 或科学计算;
- 学过 CUDA 基础,但卡在「写不快」;
- 想弄清 cuBLAS、cuDNN 这类官方库底层是怎么优化的;
- 准备 GPU 方向面试,仓库也明确这套题目可用于刷题;
- 做 LLM 推理优化,FlashAttention、量化等环节都离不开 CUDA 功底。
七、小结
一句话:LeetCUDA 用 200 多道递进式实战题,把 CUDA 优化从入门一路带到 HGEMM 达 cuBLAS 98% 到 100% 的水平,再用 100 多篇博客和 600 多页 PDF 补足理论。如果你做 GPU 编程或 AI 基础设施,这是目前少见的把「系统性」和「性能上限」同时做高的开源教程。仓库地址:https://github.com/xlite-dev/LeetCUDA
本文基于 GitHub 开源仓库 xlite-dev/LeetCUDA 的公开 README 资料整理。