字节笔记本
2026年10月5日 · 约 15 分钟读完
别拿 NewAPI 自用了,4 个依赖的 LLM 网关更干净
如果你同时用着多个 AI 服务商,官方渠道、CodingPlan、各种中转站,大概率折腾过 NewAPI 或 One-API。它们确实强大,但有个通病:为「中转站运营」而设计。注册、邀请、令牌分组、多租户、计费体系,一套商业化的东西全部塞进来,对只想给自己的工具链搭个干净代理的个人开发者来说,太重了。
项目作者受不了这套,自己动手写了个更轻的:LLMRelayService(下文简称 LRS),一个自托管的个人 LLM 中继网关,外加可观测控制台。它的定位很明确:只有单一管理员账户,没有注册、邀请、计费这些商业化机制,MIT 协议开源。这篇文章就拆一拆这个「为自用而生」的网关,看它怎么把个人 AI 接入这件事做优雅。
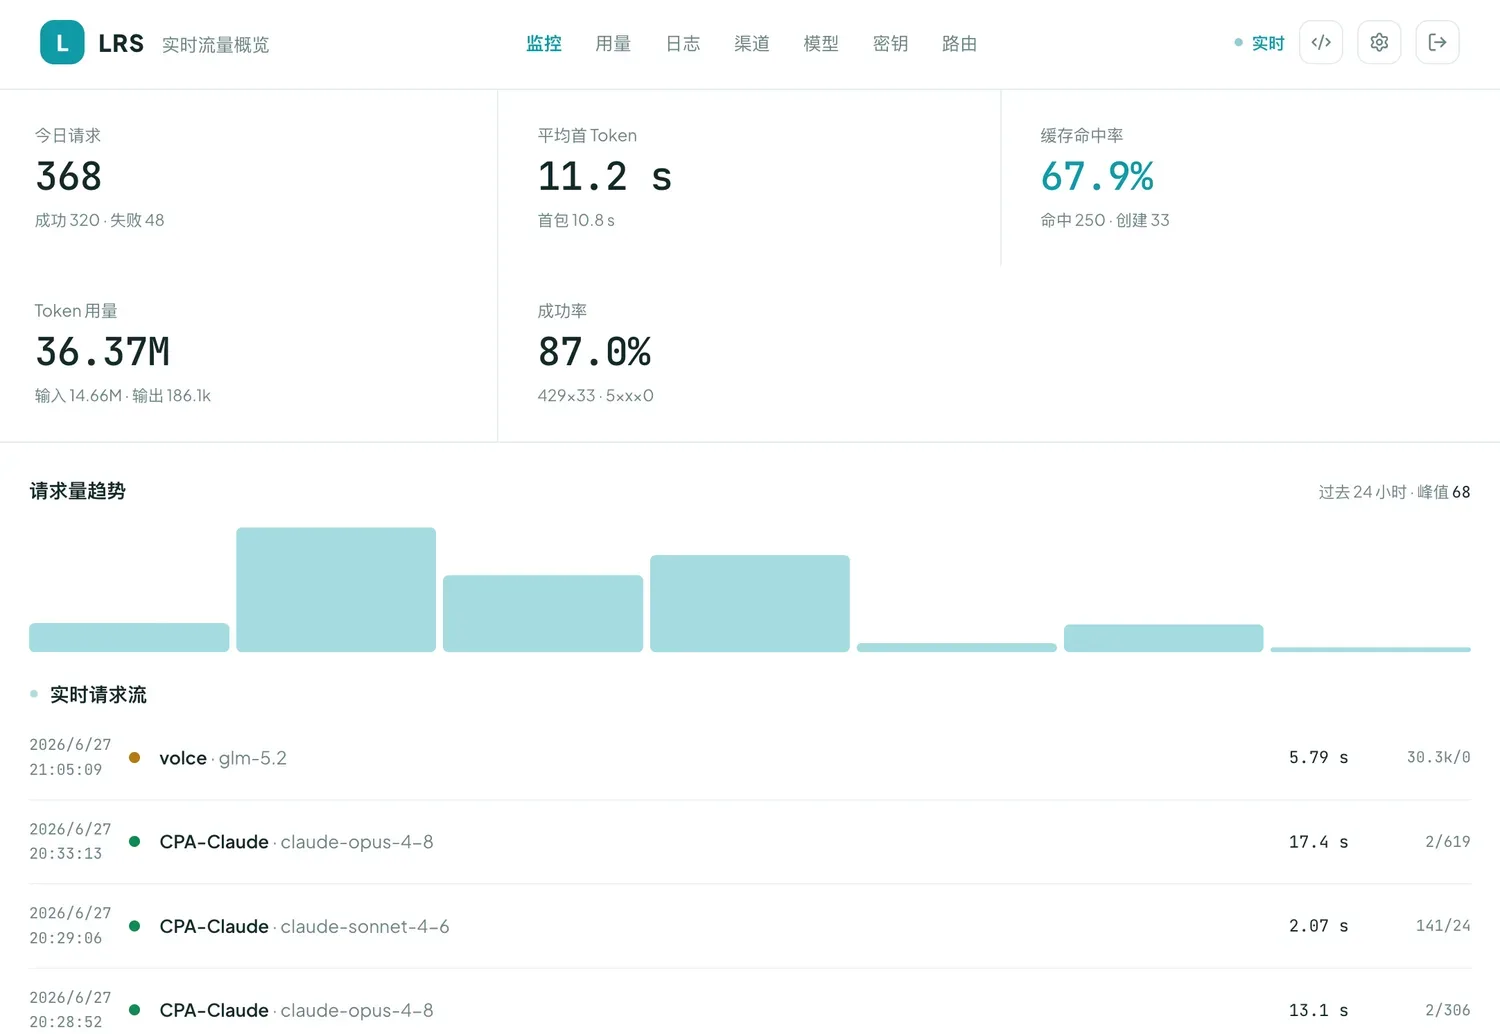
LRS 的监控面板:首 token 延迟、缓存命中率、token 用量趋势一目了然。
一、为什么个人自用不该用 NewAPI
先说清楚 NewAPI/One-API 这类方案对个人开发者的「过重」在哪:
| NewAPI 的设计 | 个人自用需要吗 |
|---|---|
| 多租户(多个用户、多个团队) | 不需要,只有一个人 |
| 注册/邀请/用户体系 | 不需要,自己就是管理员 |
| 令牌分组、配额分级 | 不需要,只想知道自己花了多少 |
| 完整的计费/充值体系 | 不需要,不卖服务给别人 |
| 复杂的角色权限 | 不需要,一个管理员够了 |
| 复杂的格式转换 | 反而经常因转换出兼容问题 |
NewAPI 是「给做中转站生意的人用的」,它的复杂度对应的是商业运营场景。而个人开发者要的其实只有几件事:把多个服务商统一到一个入口;不把真实 API key 暴露给客户端工具;看到每次请求花了多少 token、命中缓存没有;出问题时能翻日志定位。
LRS 砍掉了所有商业化机制,只保留这几件事。读完 README 你会发现,它的每一个设计决策都在回应「个人自用」这个场景。
二、四个核心特性
README 里列了四个核心特性,逐个拆开看。
特性 1:格式透传,原生兼容(最重要)
这是 LRS 最反常识也最聪明的设计:默认不做格式转换,客户端发什么就转发什么,只替换认证头。
为什么这么设计?因为格式转换是代理网关最大的兼容性雷区。README 里的 Responses API 与 Chat Completions 对比表,把「转换有多难」讲透了:
| 维度 | Chat Completions | Responses API |
|---|---|---|
| 输入 | messages[]{role, content} | input[]{role, content[]{type, text}} |
| 系统提示 | messages[0]{role:"system"} | 顶层 instructions 字段 |
| 流式事件 | choices[].delta.content | response.output_text.delta 加类型化事件信封 |
| 工具调用 | tool_calls[] 在 delta 里 | function_call_arguments.delta 事件 |
| 多轮状态 | 无状态(调用方管历史) | 有状态,靠 previous_response_id |
| 输出结构 | choices[0].message.content | 类型化的 output[] 项 |
这六个维度全都不一样,任何一次「智能转换」都可能丢字段、错位流式协议、搞坏工具调用。所以 LRS 的选择是默认原样转发,不碰这些。
但如果你必须转换,比如 Codex CLI/App 只会说 Responses API,而你接的上游只支持 Chat Completions,LRS 提供了一个可选的 chat_compat 模式做转换。把转换从「默认行为」降级成「可选能力」,是它的设计精髓。
特性 2:请求全文记录(调试神器)
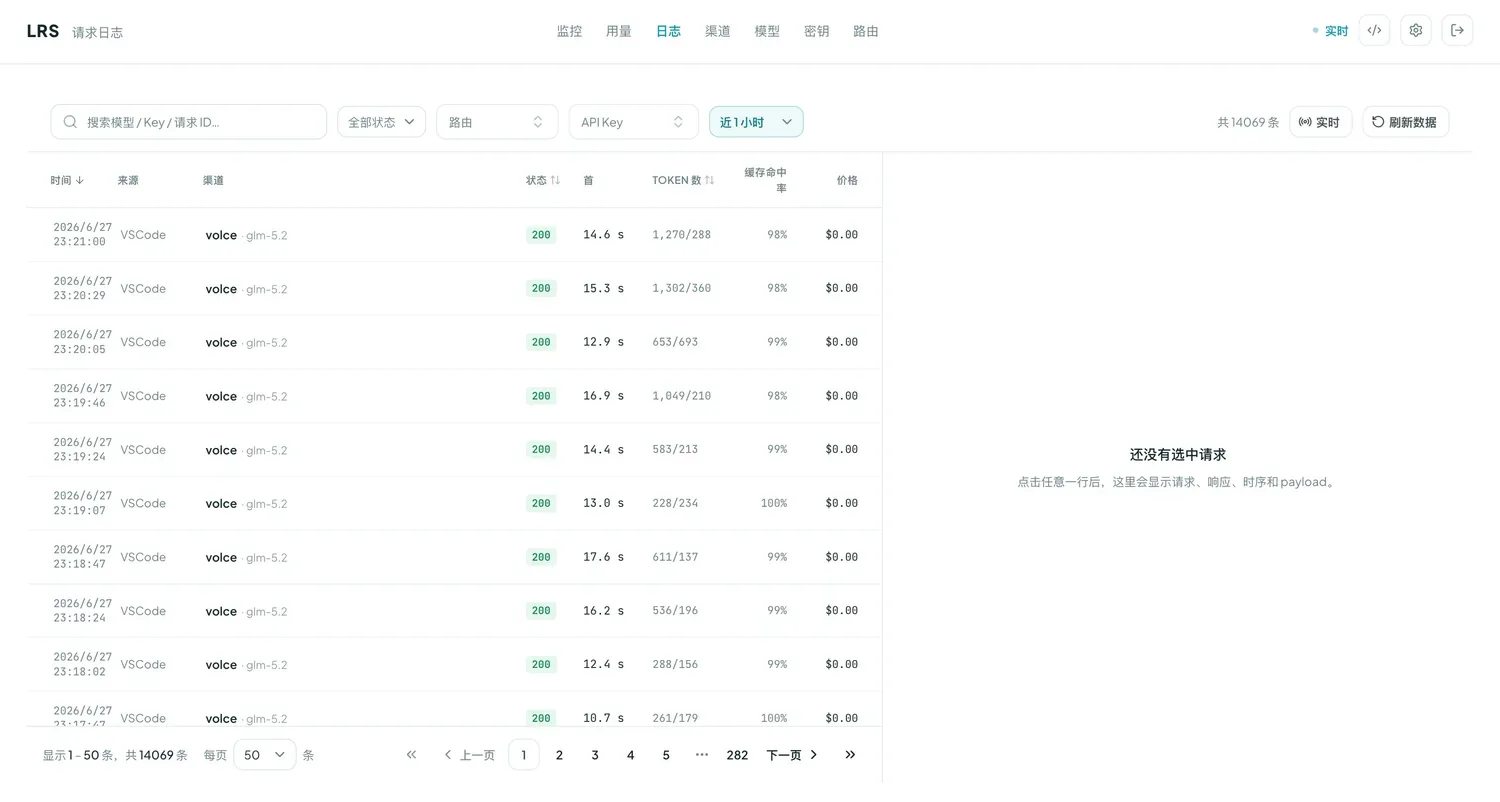
LRS 的请求日志页:每笔请求的状态、延迟、token 数、缓存命中率、价格都可直接查看。
LRS 完整保存每一笔请求的三个版本:客户端发来的原始请求体、网关转发给上游的真实请求体、上游的响应。
一个特别实用的场景,是揪出那些携带大量不必要上下文的请求。比如你用 OpenClaw 或 Hermes 这类 agent 工具,有时候它们会在请求里塞进一堆你不知道的系统提示、历史会话、工具定义,白白烧 token。有了全文日志,你能直接看到「到底发了什么」,对症下药砍掉冗余。
这种「原始 + 转发 + 响应」三段式记录,比只记一个最终响应有用得多:它能让你定位问题出在客户端、网关还是上游。
特性 3:渠道与路由分离,带智能回退
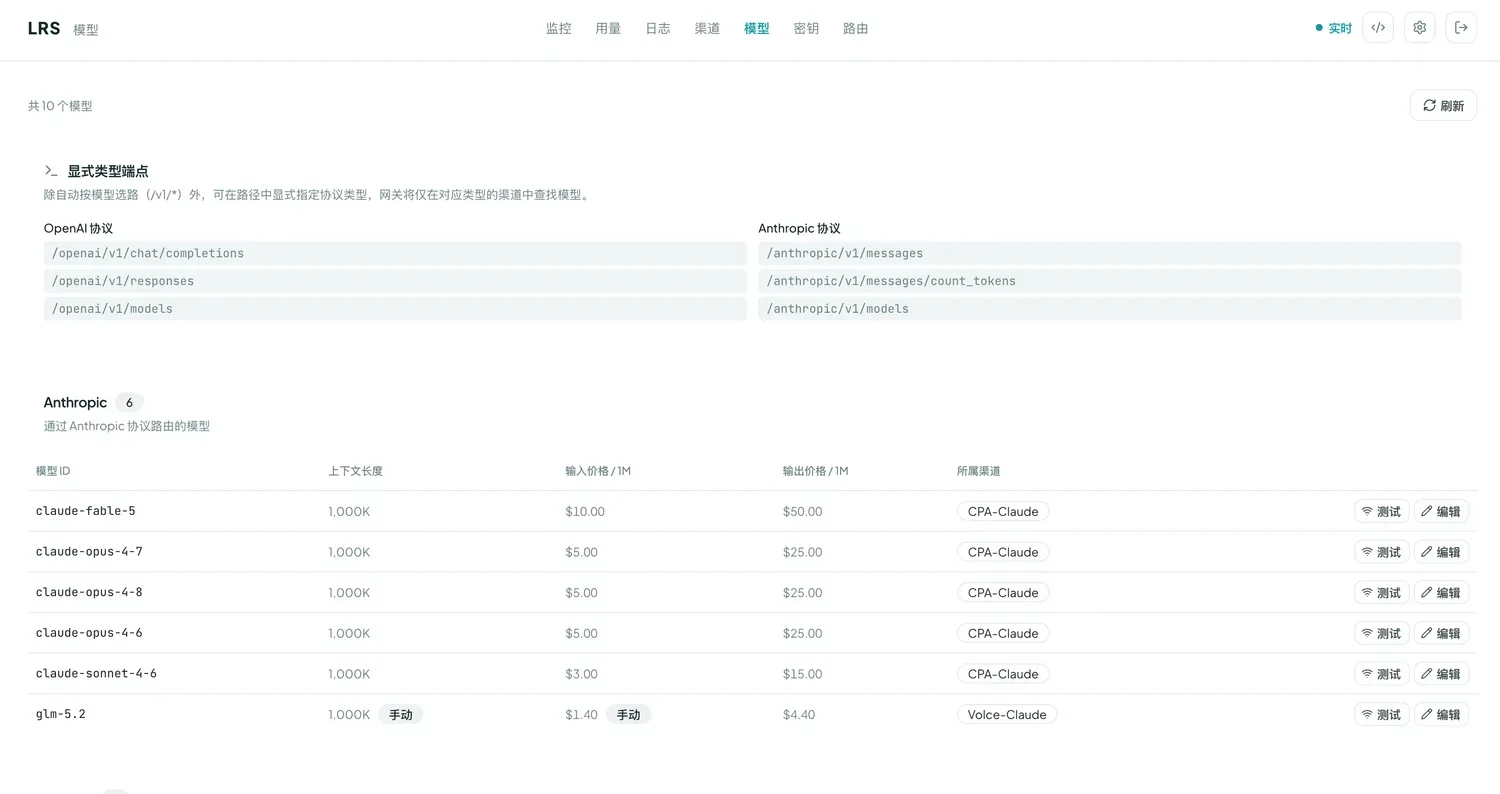
LRS 的模型页:双协议端点、上下文长度、输入输出价格、所属渠道一览。
LRS 把「渠道(Provider)」和「路由(Routing)」解耦。
渠道层定义「上游是谁、用哪个 key、什么协议、什么优先级」。同一个模型可以配多个渠道,比如官方渠道配一个、中转站再配一个,用 priority 字段控制优先级。
路由层定义「客户端的模型名怎么映射到上游真实模型」。通过模型别名(Alias)机制,对外暴露自定义模型名,内部映射到真实上游,比如对外叫 gpt-fast,内部路由到某个更便宜的小模型。
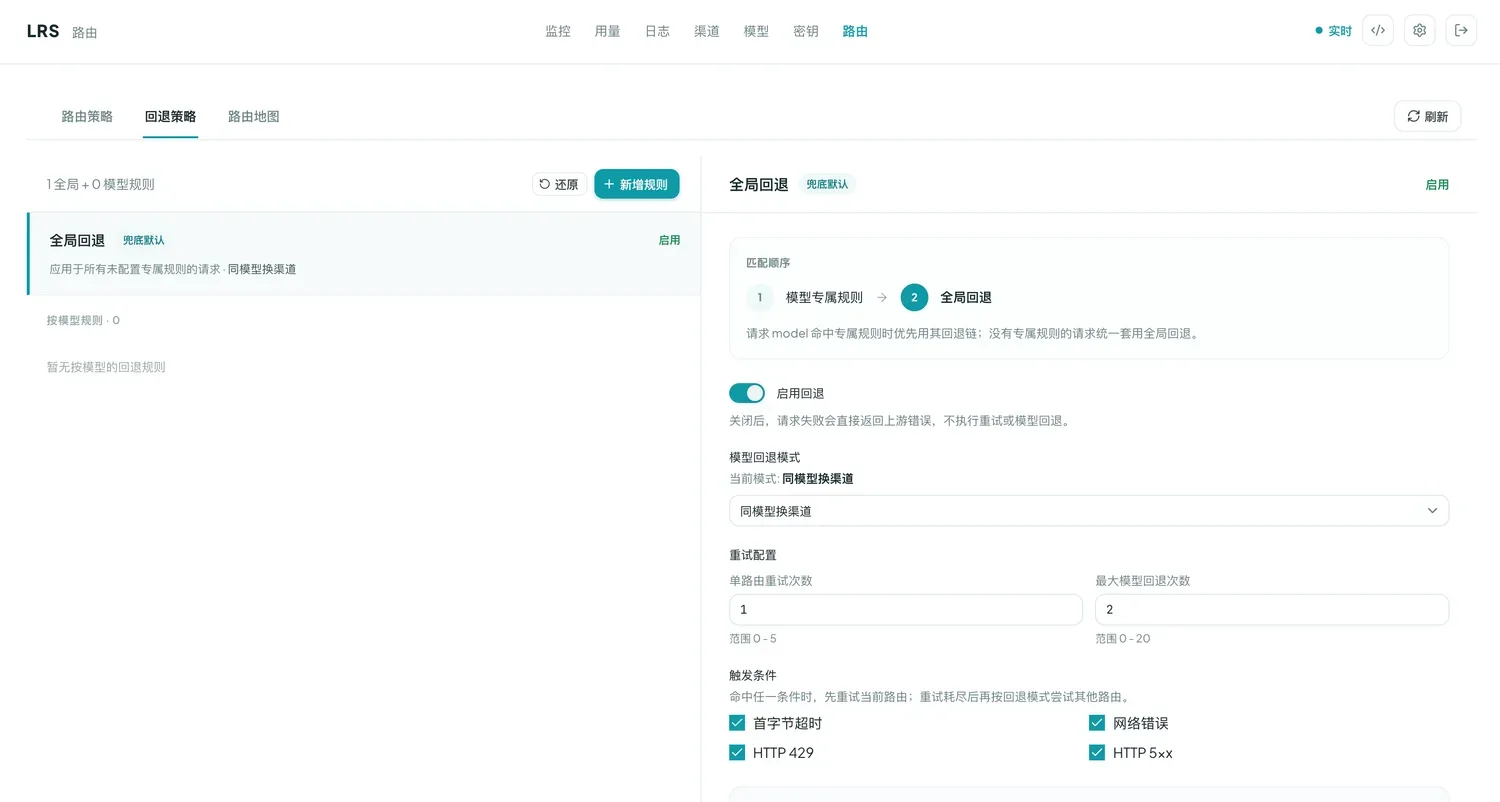
LRS 的回退策略页:可按首字节超时、网络错误、HTTP 429、HTTP 5xx 触发回退。
智能回退方面,当高优先级渠道挂了(限流、超时、余额不足),LRS 会自动切到次优先级渠道,触发条件覆盖首字节超时、网络错误、HTTP 429 与 HTTP 5xx。这对「高可用」是刚需:你不想因为官方渠道一抖动,整个工具链就瘫掉。
特性 4:内置轻量控制台
不用额外装 Grafana,LRS 自带可视化面板:
- 首 token 延迟:衡量「卡不卡」
- 缓存命中率:衡量「省没省钱」
- token 用量趋势:衡量「花了多少」
- 按 API Key 维度统计:多个应用共用网关时,分别看用量
这个面板的定位很克制:不是给运维团队用的全链路监控,是给「想知道自己花了多少钱」的个人开发者用的,刚刚好。
三、技术栈:精简到极致
LRS 的技术选型极其克制,看仓库 package.json 里的 dependencies 就知道:
| 层 | 技术 | 选型理由 |
|---|---|---|
| 运行时 | Bun | 极快的 JS 运行时,内置测试/打包/包管理 |
| Web 框架 | Hono | 超轻量,边缘/Node/Bun 通用,路由优先 |
| ORM | Drizzle ORM | TypeScript 原生,SQL-like API,类型安全 |
| 数据库 | PostgreSQL | 成熟稳定,全文日志也扛得住 |
| 前端 | Vite + React + Tailwind | 控制台,Vite dev 体验好 |
| 部署 | Docker + ghcr.io | 官方镜像 ghcr.io/gojam11/llmrelayservice |
核心后端依赖只有 4 个:hono、drizzle-orm、postgres,外加一个 tiktoken 工具包。没有 Redis、没有 Kafka、没有 nginx 反代依赖、没有庞大的监控栈。
为什么能这么精简?因为个人自用不需要横向扩展、不需要高并发、不需要分布式。Bun 单进程扛住,PostgreSQL 存数据,Hono 路由转发,够了。这种「够用就好」的克制,本身就是工程功力。
四、一个被低估的能力:Responses API 兼容层
LRS 有个能力特别值得单独说:chat_compat 模式。
背景是这样的:OpenAI 的 Codex CLI 和 Codex App 现在默认用新的 Responses API(/v1/responses),但绝大多数第三方上游(中转站、国产模型 API)只支持老的 Chat Completions(/v1/chat/completions)。结果就是,你想用 Codex 接第三方上游,协议对不上,直接报错。
LRS 的解法,是给渠道配 responsesMode: chat_compat,网关自动把 /v1/responses 请求翻译成 /v1/chat/completions 转发,响应再翻译回来,让 Codex CLI/App 能接入任何 Chat Completions 上游。本身支持 Responses API 的上游,则保持默认的 native 模式直接透传。
这个能力放在当下的工具链里位置很关键:市面上不少「模型切换器」解决的是入口切换问题,但协议层的不兼容仍然卡在网关这一层。没有 chat_compat 这样的兼容层,你很难把便宜的国产模型(DeepSeek、GLM)接进 Codex 里用。
五、和 NewAPI/One-API 的对比
| LRS | NewAPI/One-API | |
|---|---|---|
| 定位 | 个人/小团队自用 | 中转站运营 |
| 多租户 | 无,单管理员 | 有,完整用户体系 |
| 注册/邀请 | 无 | 有 |
| 计费/充值 | 简单额度控制 | 完整商业计费 |
| 格式转换 | 默认透传(可选转换) | 默认转换 |
| 全文日志 | 三段式(原始/转发/响应) | 一般只记响应 |
| 控制台 | 内置轻量 | 功能多但重 |
| 核心依赖数 | 4 个 | 几十个 |
| 协议 | Anthropic + OpenAI 双协议 | 多协议 |
| Responses 兼容 | chat_compat | 看版本 |
一句话:如果你是做中转站生意,选 NewAPI;如果你是给自己搭个干净代理,选 LRS。两者不冲突,是不同场景的解。
六、怎么用
Docker 部署(最简单)
docker run -d \
  --name lrs \
  -p 3300:3300 \
  -e GATEWAY_API_KEY=your-key \
  -e DATABASE_URL=postgresql://user:password@host:5432/lrs \
  ghcr.io/gojam11/llmrelayservice:main
本地开发
git clone https://github.com/GoJam11/LLMRelayService.git
cd LLMRelayService
bun install
cp .env.example .env  # 填 DATABASE_URL 和 GATEWAY_API_KEY
bun run db:migrate
bun run dev           # 默认监听 3300
接入你的工具
装好后,在控制台 Providers 页面加渠道,然后把工具的 API 指向 LRS:
# 把 Codex 的 endpoint 指向 LRS
export OPENAI_BASE_URL=http://localhost:3300/v1
export OPENAI_API_KEY=你的网关key
所有走 OpenAI 兼容协议的工具(Codex、Claude Code 配 Anthropic 上游、各种客户端)都能直接用。
七、谁该用
强烈推荐,如果:
- 你同时用多个 AI 服务商,想统一入口
- 你受不了 NewAPI 的复杂度,只想要个干净代理
- 你想给 Codex CLI/App 接便宜的第三方/国产模型
- 你想精确看到每次请求花了多少、带了什么上下文
- 你想给不同应用(本地工具、手机 App、团队共享)分发独立 key 控额度
不适合:
- 你要做中转站生意,需要多租户、用户注册、充值计费(直接选 NewAPI)
- 你完全不用 AI API(那你不需要任何网关)
八、它背后的趋势:工具的「场景收敛」
LRS 代表的不只是一个轻量网关,而是开源工具的一个明显趋势:场景收敛。
前几年,开源工具追求「功能全」,一个 NewAPI 要覆盖从个人到中转站的所有场景,结果就是为了少数人的高级需求,让多数人背着不需要的复杂度。现在的趋势反过来:明确砍掉非目标场景,把单一场景做到极致。LRS 砍掉了商业化,把「个人自用」做到极致;开源社区里类似的做法越来越多,有的桌面应用砍掉 Electron 换来轻量启动,有的引导库把全部能力压进几 kb。
这种「做减法」的勇气,比「做加法」的勤奋更难得。它需要作者清楚知道自己为谁做、不为谁做。LRS 整个项目的起点就是一句话:NewAPI 这类方案,对个人自用来说过重了。
九、小结
LLMRelayService 是为个人自用设计的轻量 LLM 网关:格式透传避开兼容雷区、全文日志方便调试、双协议加 Responses 兼容层接入任意上游、核心依赖只有 4 个。它可以看作 NewAPI 的「轻量版」,但定位完全不同。
项目作者的动机很直白:NewAPI 这类方案对个人自用来说过重了。从这一点出发,LRS 砍掉了一切不必要的复杂度,留下一个干净、可观测、够用的网关。如果你也在多个 AI 服务商之间疲于切换,又不想装一个重型的 NewAPI,LRS 值得一试。它可能不能帮你做中转站生意,但它能帮你自己用得舒服。
而对开源工具的观察者来说,LRS 是「场景收敛」趋势的又一个样本:少即是多,明确边界比堆功能更值钱。
本文基于 LLMRelayService 仓库的 README 与项目文档整理,MIT 协议开源,技术栈为 Bun + Hono + Drizzle + PostgreSQL,Docker 镜像 ghcr.io/gojam11/llmrelayservice。