字节笔记本
2026年10月5日 · 约 11 分钟读完
微软开源 SkillOpt:像训神经网络一样训 AI 技能
想让 AI Agent 精通某个任务,传统路子是微调大模型。但微调贵、慢、还要数据,而且一动模型权重,通用能力可能跟着下降。微软开源的 SkillOpt 走了一条反直觉的路:像训练神经网络那样训练 AI 的技能,但完全不动模型权重,训练对象只是一个几百 token 的 markdown 文本文件。
官方数据相当亮眼:在 GPT-5.5 上,直接对话的平均准确率提升 23.5 个点;放进 Codex 的 agent loop 里提升 24.8 个点;在 Claude Code 里提升 19.1 个点。而且这些"练出来"的技能,还能跨模型、跨工具迁移。仓库采用 MIT 协议,pip install skillopt 即可安装。本文拆解它的核心思想、训练循环、稳定性设计和上手方法。
一、技能从哪来:三条老路都不算训练
目前 Agent 的技能(skill)通常有三种来源:
- 手写:专家凭经验写一份 prompt 或规则,质量全凭作者水平
- 一次性生成:让一个强 LLM 写一版,质量看运气
- 松散自我修订:让 Agent 自己改自己的技能,没有验证环节,容易越改越糟
这三种方式都不是"训练"。它们没有梯度、没有验证集、没有早停,无法保证改了一定变好。SkillOpt 的 README 第一句话就点破了它的定位,大意是:像训练神经网络那样训练 agent 技能,有 epoch、batch size、学习率和验证门,但全程不碰模型权重。
二、核心思想:技能文档就是可训练参数
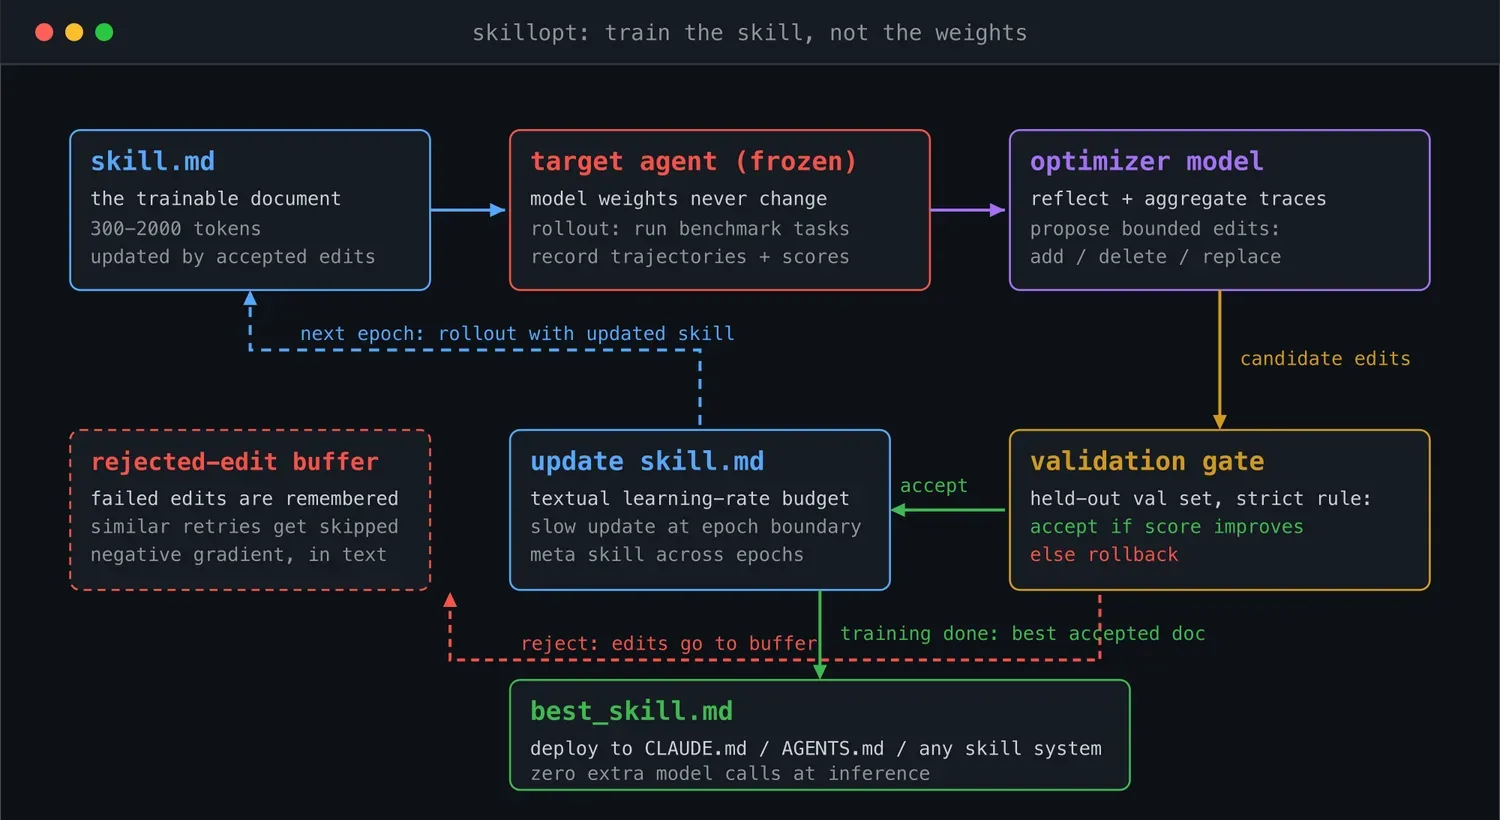
SkillOpt 把技能文档当作冻结 Agent 的"可训练状态"。具体机制是这样的:
- 大模型完全冻结:GPT-5.5、Claude、Codex 的权重一个数都不改
- 可训练的"参数"是一个 markdown 文件:通常是 300 到 2000 token 的技能文档
- 一个独立的优化器模型:根据 agent 跑任务的真实轨迹(trajectory),生成"增、删、改"三类编辑建议
- 验证门(validation gate):一个编辑建议只有在严格提升 held-out 验证分数时才会被接受
- 部署零成本:训练完只得到一个
best_skill.md短文件,推理时挂上去就行,零额外模型调用
翻译成人话:传统训练改的是模型内部的"肌肉",SkillOpt 改的是模型外挂的"说明书"。说明书越练越精确,模型还是那个模型。
三、训练循环:六步,深度学习的文本版
SkillOpt 的训练循环在文档里写得明明白白:
rollout → reflect → aggregate → select → update → evaluate
(试跑)    (反思)    (聚合)      (选择)   (更新)   (验证)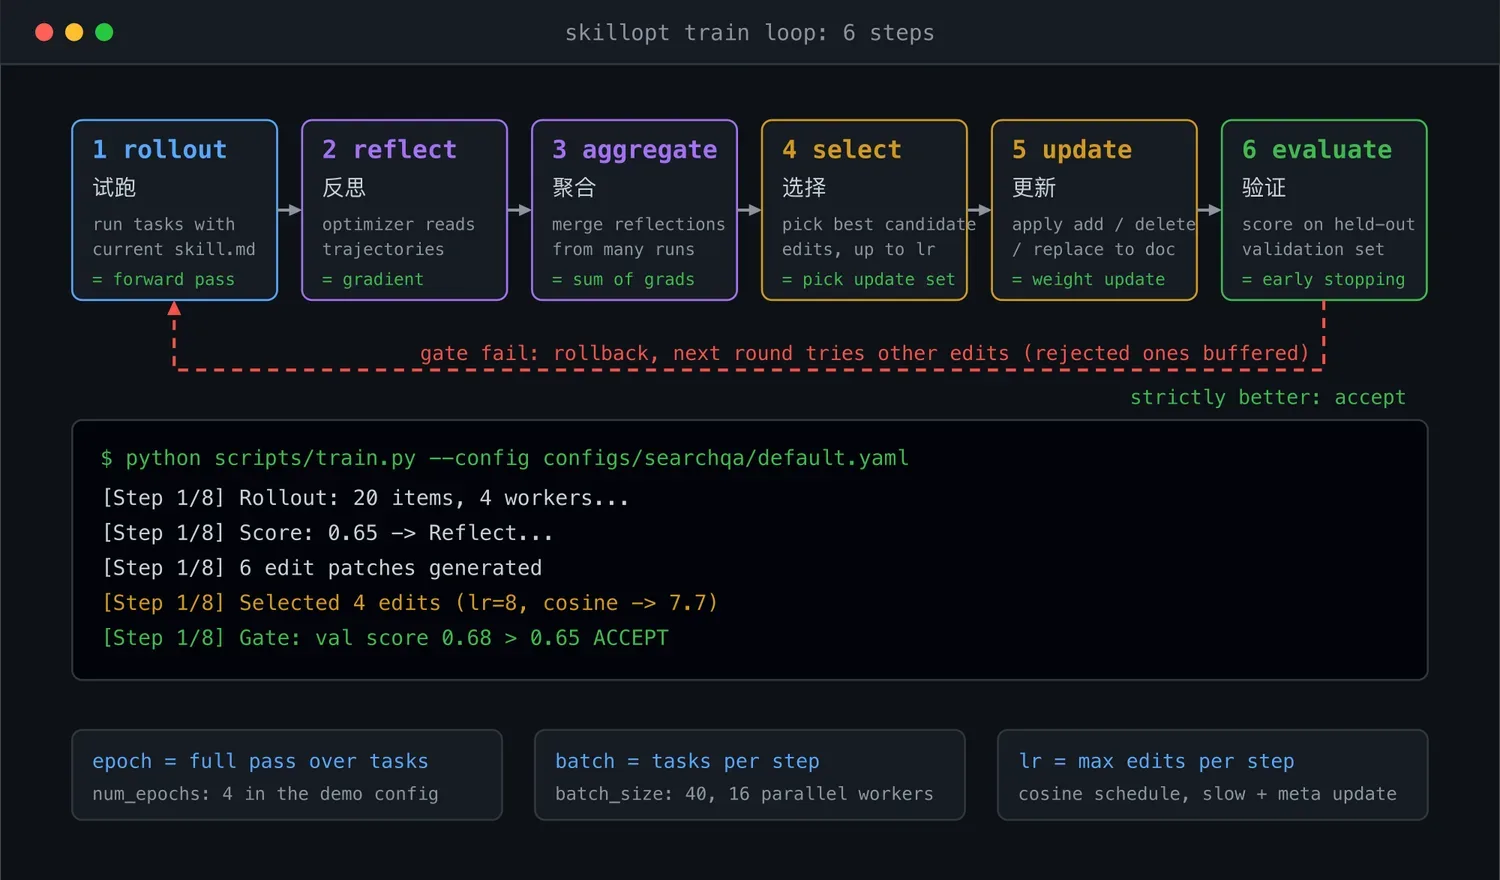
逐步来看:
- Rollout(试跑):用当前技能文档让 agent 在任务上跑一轮,记录完整轨迹
- Reflect(反思):优化器模型分析轨迹,找出哪里做得好、哪里做错了、文档该怎么改
- Aggregate(聚合):把多次 rollout 的反思汇总,避免被单次噪声误导
- Select(选择):从一批候选编辑里挑出最可能有效的几个
- Update(更新):把选中的编辑应用到技能文档
- Evaluate(验证):在 held-out 验证集上测新文档的分数,只有严格提升才接受,否则回滚
这个循环眼熟不眼熟?它就是深度学习训练循环的文本版:rollout 对应前向传播,reflect 加 aggregate 对应梯度计算,select 加 update 对应权重更新,evaluate 加验证门对应早停。SkillOpt 把"训练"这个概念从权重空间搬到了文本空间,同时保留了训练的全部优点:可复现、可验证、可早停。
四、三个机制,保证文本训练不崩
让"文本训练"稳定比想象的难:文本编辑容易越改越乱、越改越长。SkillOpt 用了三个机制:
1. 文本学习率预算
深度学习用学习率控制每步改多少权重,SkillOpt 用"文本学习率"控制每步最多做几次编辑。配置文件里 optimizer.learning_rate 的注释直接写着"每步最大编辑数",还支持 cosine 调度。小步快跑,防止一轮把技能文档改得面目全非。
2. 拒绝编辑缓冲区
被验证门拒绝的编辑不会白白丢掉,它们会进入一个缓冲区。后续轮次里如果类似编辑反复被拒,优化器就学会"这类改动没用",不再浪费算力尝试。相当于文本版的负梯度累积。
3. Epoch 级慢速与元更新
不是每轮都大改。配置里的 use_slow_update 类比动量,在 epoch 边界做慢速更新;use_meta_skill 提供跨 epoch 的优化器记忆,做结构性调整时参考历史。这种节奏控制避免了技能文档在优化过程中崩坏。
三个机制叠加的效果,官方给了一句话结论:在 6 个 benchmark、7 个目标模型、3 种执行 harness(直接对话、Codex CLI、Claude Code CLI)组成的 52 个评测单元上,SkillOpt 全部取得最佳或并列最佳。不是偶尔有效,是稳定、可复现地有效。
五、硬数据:模型无关、工具无关的提升
| 场景 | 平均无技能准确率提升 |
|---|---|
| GPT-5.5 直接对话 | +23.5 点 |
| GPT-5.5 在 Codex agent loop 里 | +24.8 点 |
| GPT-5.5 在 Claude Code 里 | +19.1 点 |
更重要的是迁移能力:
- 在 Codex 上训出来的技能,能直接用在 Claude Code 上,不用重训
- 在小模型上训的技能,迁移到大模型仍然有效
- 在 benchmark A 上训的技能,对相近的 benchmark B 也有提升
为什么能迁移?因为技能文档描述的是"怎么做这类任务的方法论",不是某个模型的怪癖。好方法是普适的,就像一份好的工作 SOP,换个人执行也管用。训一次、多场景复用,这是它比微调划算得多的地方。
六、SkillOpt-Sleep:让 Agent 在夜里自动复盘
2026 年 6 月 15 日,项目上架了一个预览功能 SkillOpt-Sleep,官方称之为"夜间离线自进化伴侣"。它面向本地编码 agent(Claude Code、Codex、Copilot),在你不用电脑的时段自动回顾过去的会话、重放反复出现的任务,并用同样的验证门把有效技能巩固下来。
开发者过去沉淀经验靠手动:在技能文档里记下踩过的坑,跑完任务手动复盘。SkillOpt-Sleep 把这套流程自动化了,本质上是给 Agent 装了个"睡眠学习系统",类似人睡觉时大脑巩固白天的记忆。第二天早上打开电脑,你的 Agent 比昨晚更聪明了一点。
七、上手:从安装到部署
pip install skilloptv0.1.0 已于 2026 年 6 月上架 PyPI,要求 Python 3.10+,MIT 协议。训练侧支持 OpenAI、Azure、Claude、Qwen、MiniMax 多种后端,内置 6 个 benchmark,还带一个 WebUI 监控面板。基本流程五步:
- 准备数据:目标任务的一些样例(输入与期望输出)
- 配置:在 YAML 里选目标模型、优化器模型和 benchmark,关键参数包括
num_epochs、batch_size、learning_rate和验证门开关use_gate - 训练:以最快的 SearchQA 为例(官方文档标注约 30 分钟):
python scripts/train.py --config configs/searchqa/default.yaml- 产出:
outputs/目录下会生成best_skill.md,通常 300 到 2000 token,每一步的候选技能、轨迹摘要和验证记录都在旁边,可复现可回溯 - 部署:把
best_skill.md挂到 Claude Code 的 CLAUDE.md、Codex 的 AGENTS.md,或任何 skill 系统里
训完想单独评测,用 scripts/eval_only.py 指定配置和技能文件即可;想在图形界面里盯训练进度,pip install -e ".[webui]" 后运行 python -m skillopt_webui.app,默认开在 7860 端口。目前 gbrain、gbrain-evals、darwin-skill 等项目已经集成了 SkillOpt。
八、适用场景与注意事项
建议认真看看,如果你:
- 做 AI Agent 开发,想让 agent 稳定精通某类任务
- 在用 Claude Code 或 Codex,想把自己手写的 skill 优化到接近最优
- 不想花大价钱微调,但想要微调级别的效果
- 做企业 AI 落地,需要可复现、可验证的能力提升
也要注意:
- 训练本身要消耗 token:rollout 和反思都要调模型,验证门保证的是不白花,不是不花
- 技能质量取决于 benchmark 的设计,垃圾任务进,垃圾技能出
- 跨模型迁移不是无限的,模型或任务差得太远,迁移收益会下降
九、结语
SkillOpt 最有价值的洞察是:在模型权重普遍冻结、各家模型差距不断缩小的当下,技能文档是性价比最高的优化面。真正拉开 agent 能力差距的,往往就是挂在外面的那几百 token。它把"训练"的纪律性,epoch、学习率、验证门、早停,带进了提示词这个轻量领域,让技能从凭手感手写,变成有纪律地训练。
项目地址:https://github.com/microsoft/SkillOpt ,论文见 arXiv:2605.23904,文档与复现指南:https://microsoft.github.io/SkillOpt/docs/guideline.html 。