字节笔记本
2026年10月6日 · 约 6 分钟读完
DeepSeek Harness 模型适配器开发指南
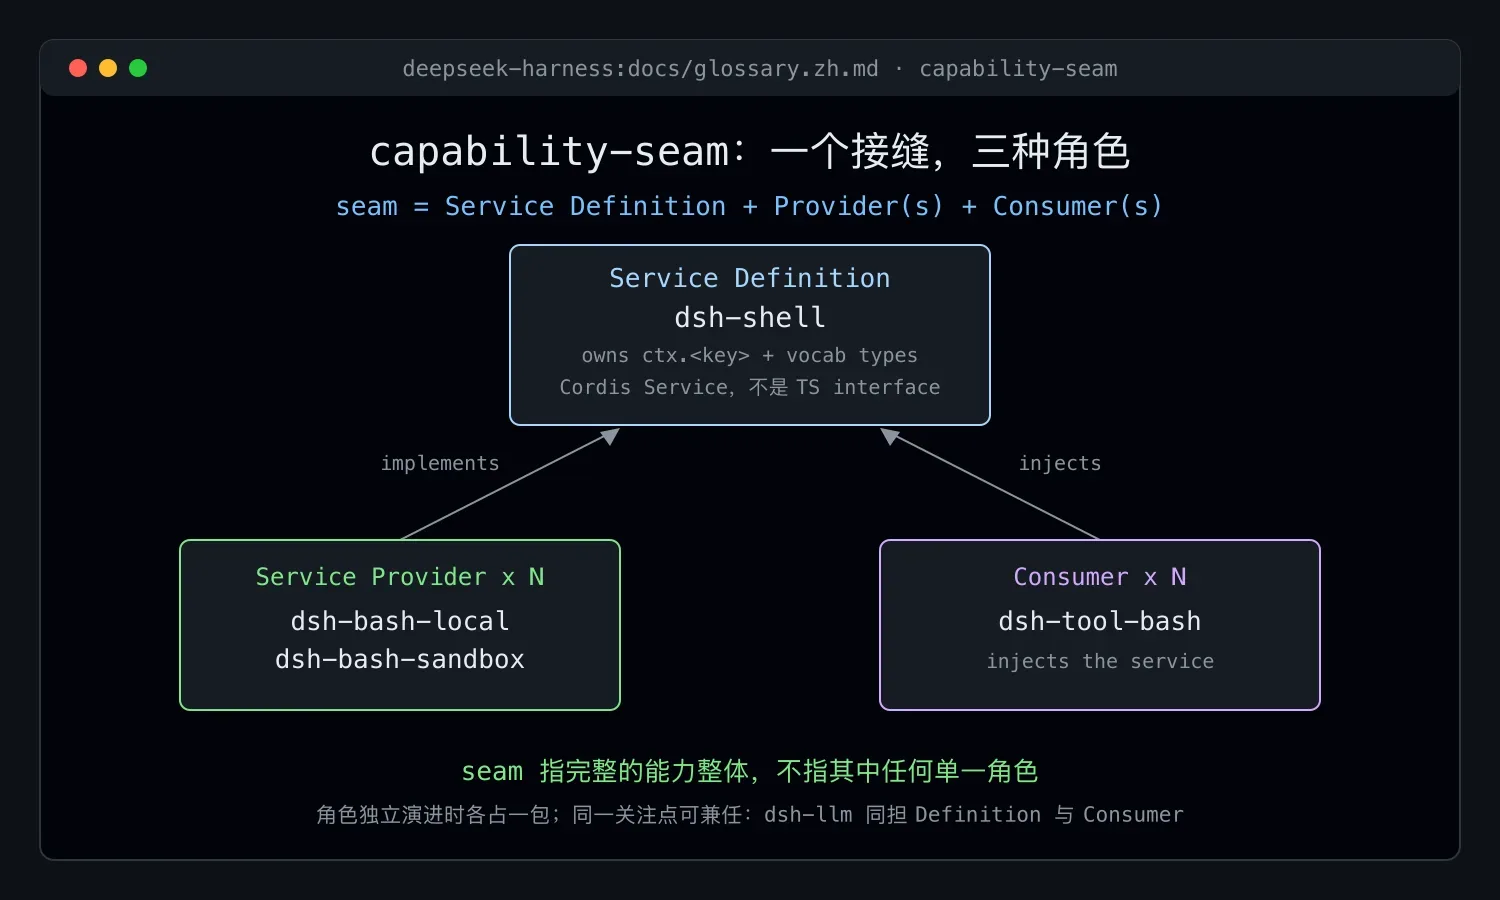
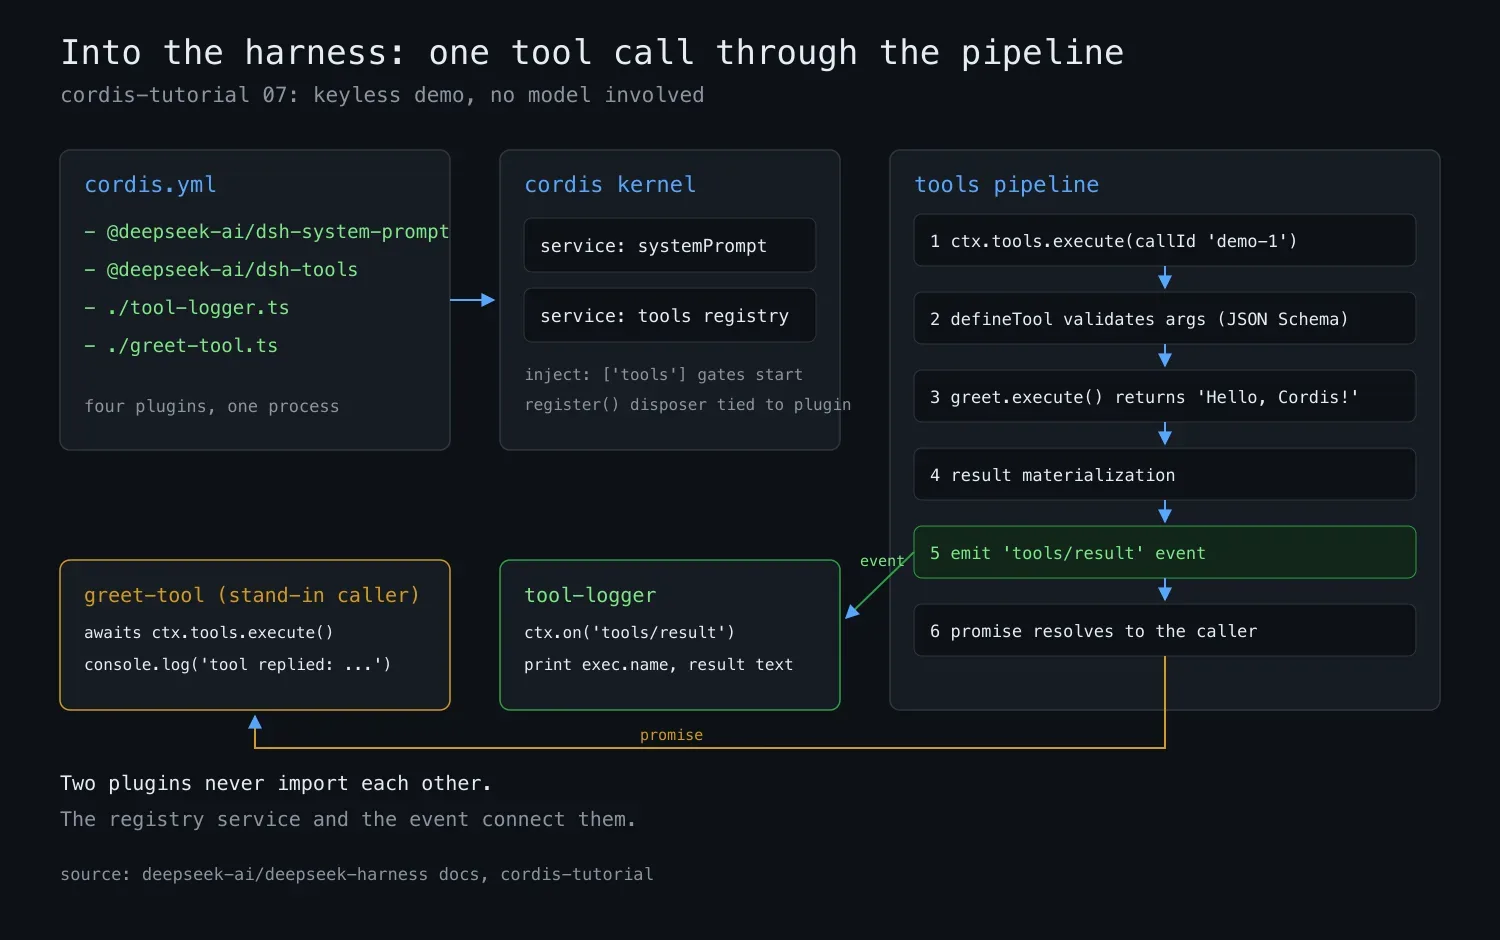
DeepSeek Harness(下称 dsh)是 DeepSeek 开源的 agent 框架,主打一切皆插件,底层由 Cordis 驱动,代码在 GitHub 上以 MIT 协议开源。想让这套框架跑在你自己的模型服务商上,标准做法不是改框架源码,而是写一个 LLM 适配器插件。官方 cookbook 文档专门讲了这件事,本文把要点整理成一篇可操作的中文指南。
先看两个参考实现和必读的类型定义
仓库里有两个可以直接参考的官方实现。llm-deepseek 直接对服务商发起 HTTP 请求,用 eventsource-parser 解析 SSE 流;llm-pi-ai 则包装一个现成的 LLM 库,把协议翻译交给库完成。两种路线都可行,区别只在于你想自己管传输,还是复用别人的封装。
动手写代码之前,官方建议先读 packages/llm/llm/src/types.ts 里 StreamChunk 的文档注释。两个参考实现都是在同一套协议约定下验证通过的,那份注释就是适配器体系的契约原文,能省掉你从报错里反推规则的时间。
适配器的代码形状
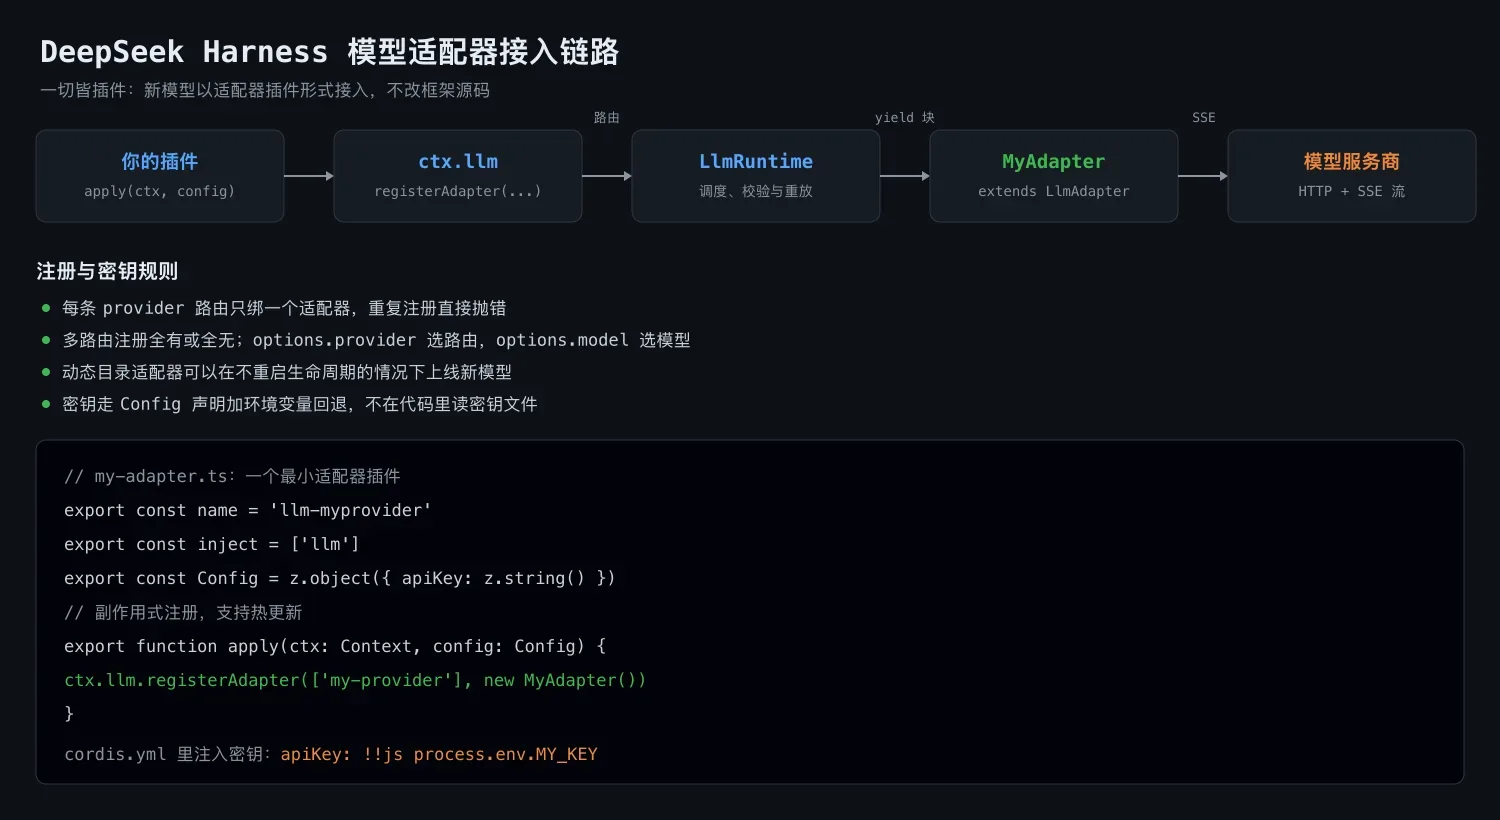
一个最小可用的适配器插件,骨架如下:
class MyAdapter extends LlmAdapter {
  async *stream(options: GenerateOptions): AsyncIterable<StreamChunk> {
    // 请求服务商接口,把响应翻译成 StreamChunk 逐个产出
  }
}

export const name = 'llm-myprovider'
export const inject = ['llm']
export const Config = z.object({ apiKey: z.string() })

export function apply(ctx: Context, config: Config) {
  ctx.llm.registerAdapter(['my-provider'], new MyAdapter())
}
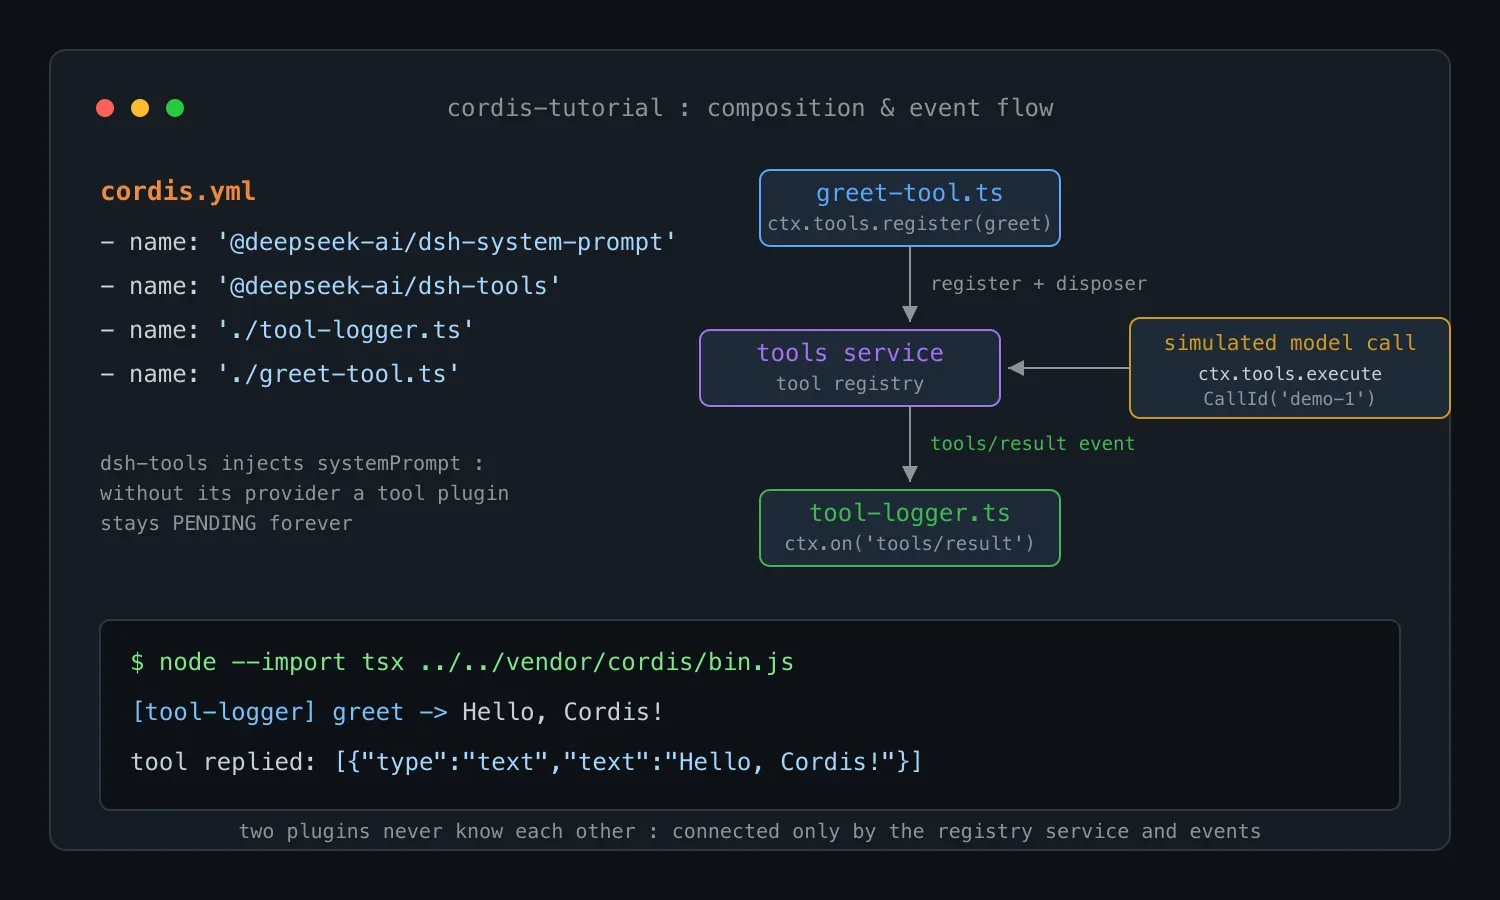
注册机制有几个值得注意的细节。注册是副作用式的,天然支持热更新;每条 provider 路由只允许绑定一个适配器,重复注册会直接抛错,一次注册多条路由则是全有或全无,不会出现半生效状态。请求侧用 options.provider 选择适配器,用 options.model 传服务商侧的模型 id,所以一个动态目录适配器可以在不重启生命周期的情况下上线新模型。
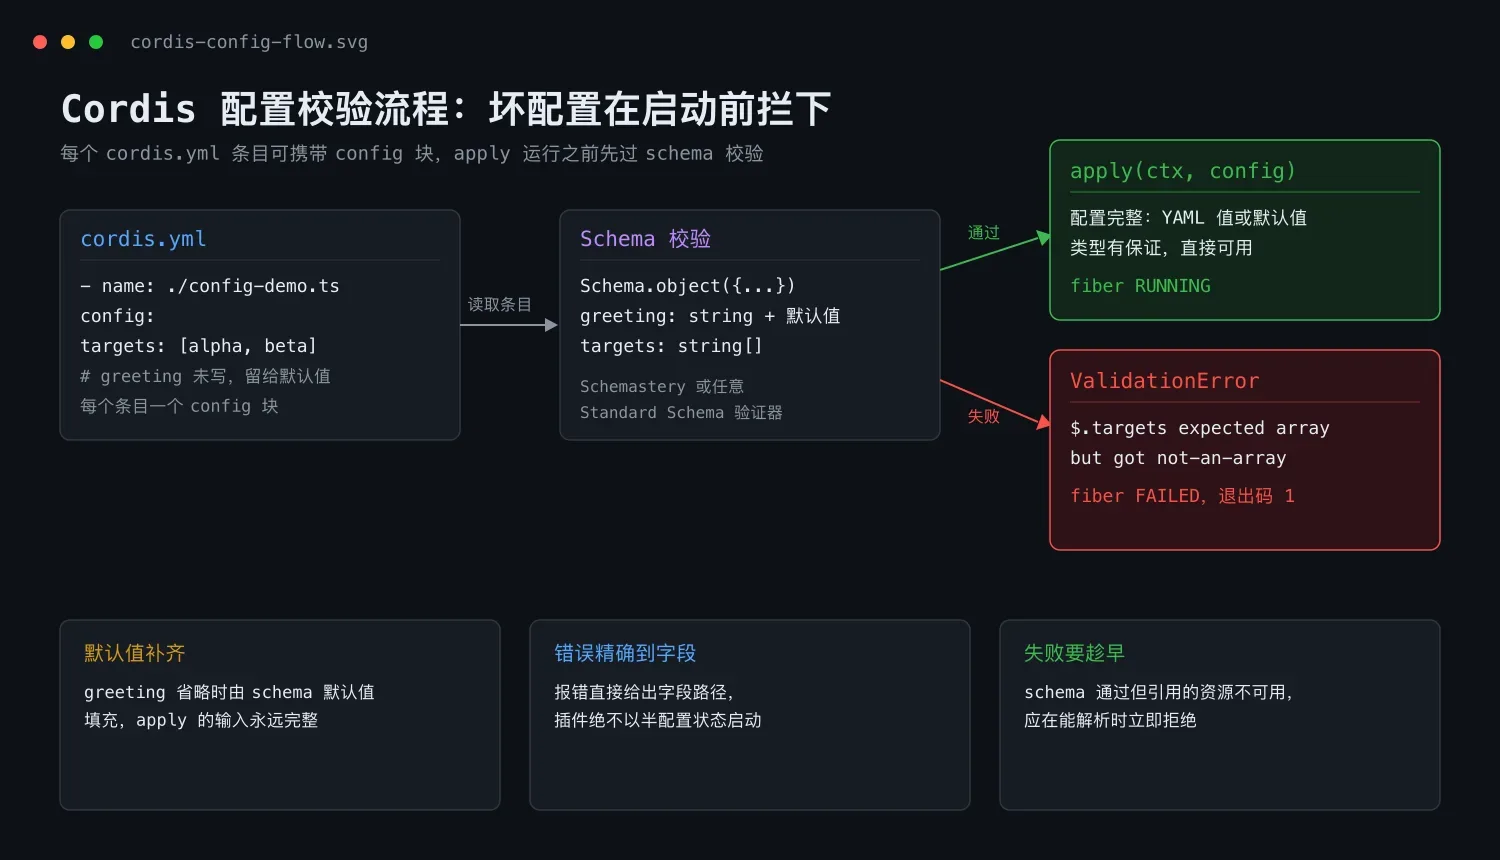
密钥管理走 Cordis 原生方案:用 schemastery 声明 Config 并支持环境变量回退,在 cordis.yml 里通过 !!js process.env.MY_KEY 注入。官方明确要求别在代码里自行读取临时密钥文件。
流式协议契约:最核心的部分
适配器和运行时之间的流式协议有几条硬约定,违反任何一条都会让上层行为变得不可预期。
第一条,usage 块必须在 finish 之前发出,finish 之后不允许再发任何块。稳妥实现是把 finish 和 usage 先缓冲住,等到服务商的流结束标记出现再统一刷出,这样能正确处理那些在结尾才补发用量数据的服务商。
第二条,工具调用的 arguments 全链路都是原始 JSON 字符串,流式增量用 argumentsDelta 表达。如果你的服务商直接返回解析好的对象,要在 block-end 时重新序列化回字符串。
第三条,块的 index 按流中首次出现的顺序分配,同一块的所有增量复用同一个 index。
第四条,错误只有两条合法路径:要么从 stream() 里直接抛出,适合传输层和协议层故障,要用带稳定错误码的 LlmError;要么用 finish 块以 error 或 aborted 状态结束流,适合服务商带内返回的失败。消费方对两条路径都有处理,你按失败类别选一条并写进文档。同时必须尊重 options.signal,把它透传给 fetch 或 SDK;服务商满足不了的 GenerateOptions 字段,例如在不支持 stop 序列的服务商上收到 stop 列表,要抛出错误码为 UNSUPPORTED 的 LlmError,不能悄悄丢弃。
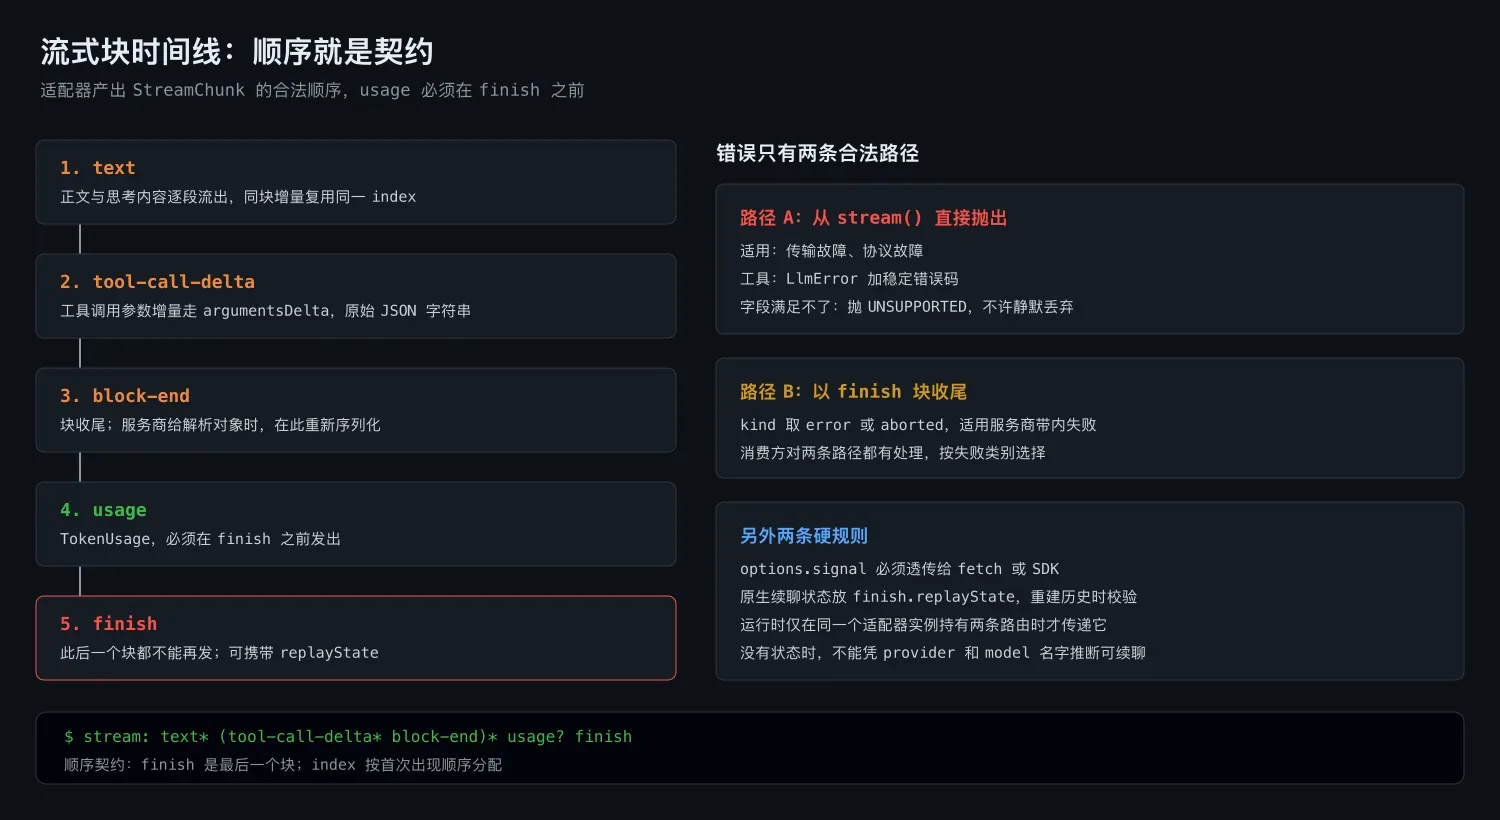
第五条,如果服务商要求后续请求携带 response id、签名等原生元数据,就把无损 JSON 的最小投影放进 finish.replayState,并在重建历史时做校验。运行时只在历史路由与目标路由当前由同一个适配器实例持有时才传递这份状态;是否允许同模型、跨模型乃至跨服务商的恢复,由适配器自己决定。没有状态时,绝不能仅凭 provider 和 model 的名字推断可以原生续聊。
思考模式与模型元数据
服务商私有的思考模式开关,留在适配器自己的 Config 里即可。模型元数据则收敛到一个服务商中立的接缝上:实现 resolveModel(),携带 provider 与 model 身份以及可选的 context 和 reasoning 字段,并尊重解析器可选的 AbortSignal;只有官方确实存在默认档位时才声明 defaultEffort。推理力度用有序的不透明 id 表示,由适配器负责映射成具体请求参数;要保留权威的可选列表,包括适配器自定义的 off 档,既不暴露线上拼写,也不对不支持的值做钳制,id 不必等于它的线上表示。
结构拆分与验证要求
实现层面,官方建议把线上类型、请求序列化、传输解析、chunk 翻译和适配器类拆成各自独立的职责,llm-deepseek 的目录布局就是参考样板。写完之后按仓库的测试策略补齐验证,包括适配器测试覆盖、真实服务商检查和发布入口要求。
适配器是 dsh 插件体系里收益很高的一类扩展:写好一个,框架的 agent 循环、工具调用、会话管理就都能直接跑在新模型上。契约条文看着多,每一条背后都是真实踩过的坑,对着两个参考实现写,基本可以一次到位。