字节笔记本
2026年10月6日 · 约 7 分钟读完
DeepSeek Harness 的文档翻译提示词拆解
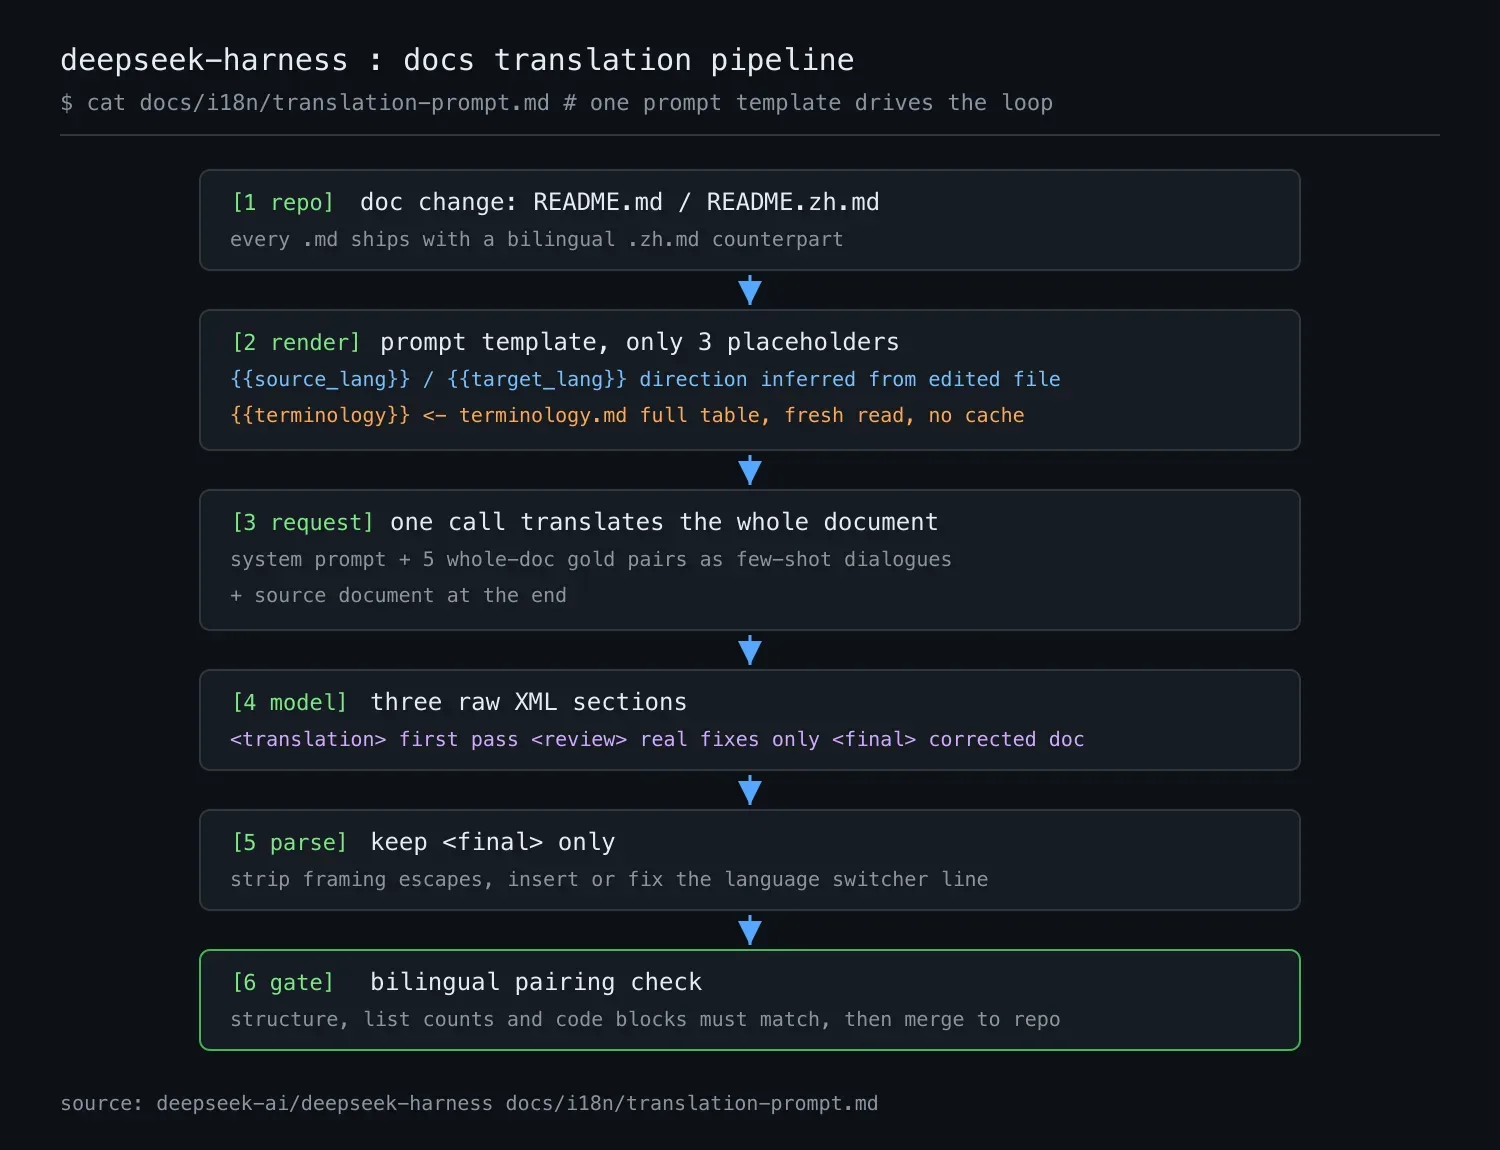
DeepSeek Harness 是 DeepSeek 开源的 agent harness,架构口号是「一切皆插件」。这个项目的文档是中英双语的:每份英文文档都有对应的中文版本,由一条自动翻译流水线维护。流水线的大脑只有一个,就是仓库里 docs/i18n/translation-prompt.md 这份提示词模板:文档改动进来,模板渲染成系统消息,模型吐出译文,流水线解析后过双语配对门禁,新译文才能进仓库。模板正文与内嵌示例由项目维护者基于对存量译文的质量评审撰写,修改它需要走正常的代码评审。最近把这份模板完整读了一遍,它对想搭文档翻译流水线的人很有参考价值,拆解如下。
占位符:模板只认三个变量
模板渲染时只替换三个占位符。{{source_lang}} 和 {{target_lang}} 标注翻译方向,方向由被改动的文件推断,改了中文文件就是中译英;{{terminology}} 注入术语表全表,每次渲染都读仓库当前版本,不做缓存。除此之外不注入任何其他仓库文件,单独约束人工翻译的规则文档也不会进模板。
一次请求翻译整篇文档。模板明确声明不支持其他占位符,也不支持按段切分的协议。模型被要求按固定格式输出,流水线解析时只取 <final> 段落入库。
金样本:整篇文档当 few-shot
多数翻译提示词的 few-shot 是几个句子级正误例,这份模板的思路完全不同:金样本是五组人工评审过的整篇中英对照文档,包括项目 README、开发指南、i18n 文档等核心文件,跟随仓库版本更新。
注入方式也有讲究:模板本体作为系统消息放在最前,五组样本作为五轮示例对话居中,每组里 user 消息放源文全文,assistant 消息放定稿译文全文,待译文档放在最后。上下文吃紧时,按既定顺序从后往前删组。这五组同时也是译文评审的校准锚点,改任何一组都等于改变流水线行为。
优先级:含义压倒一切
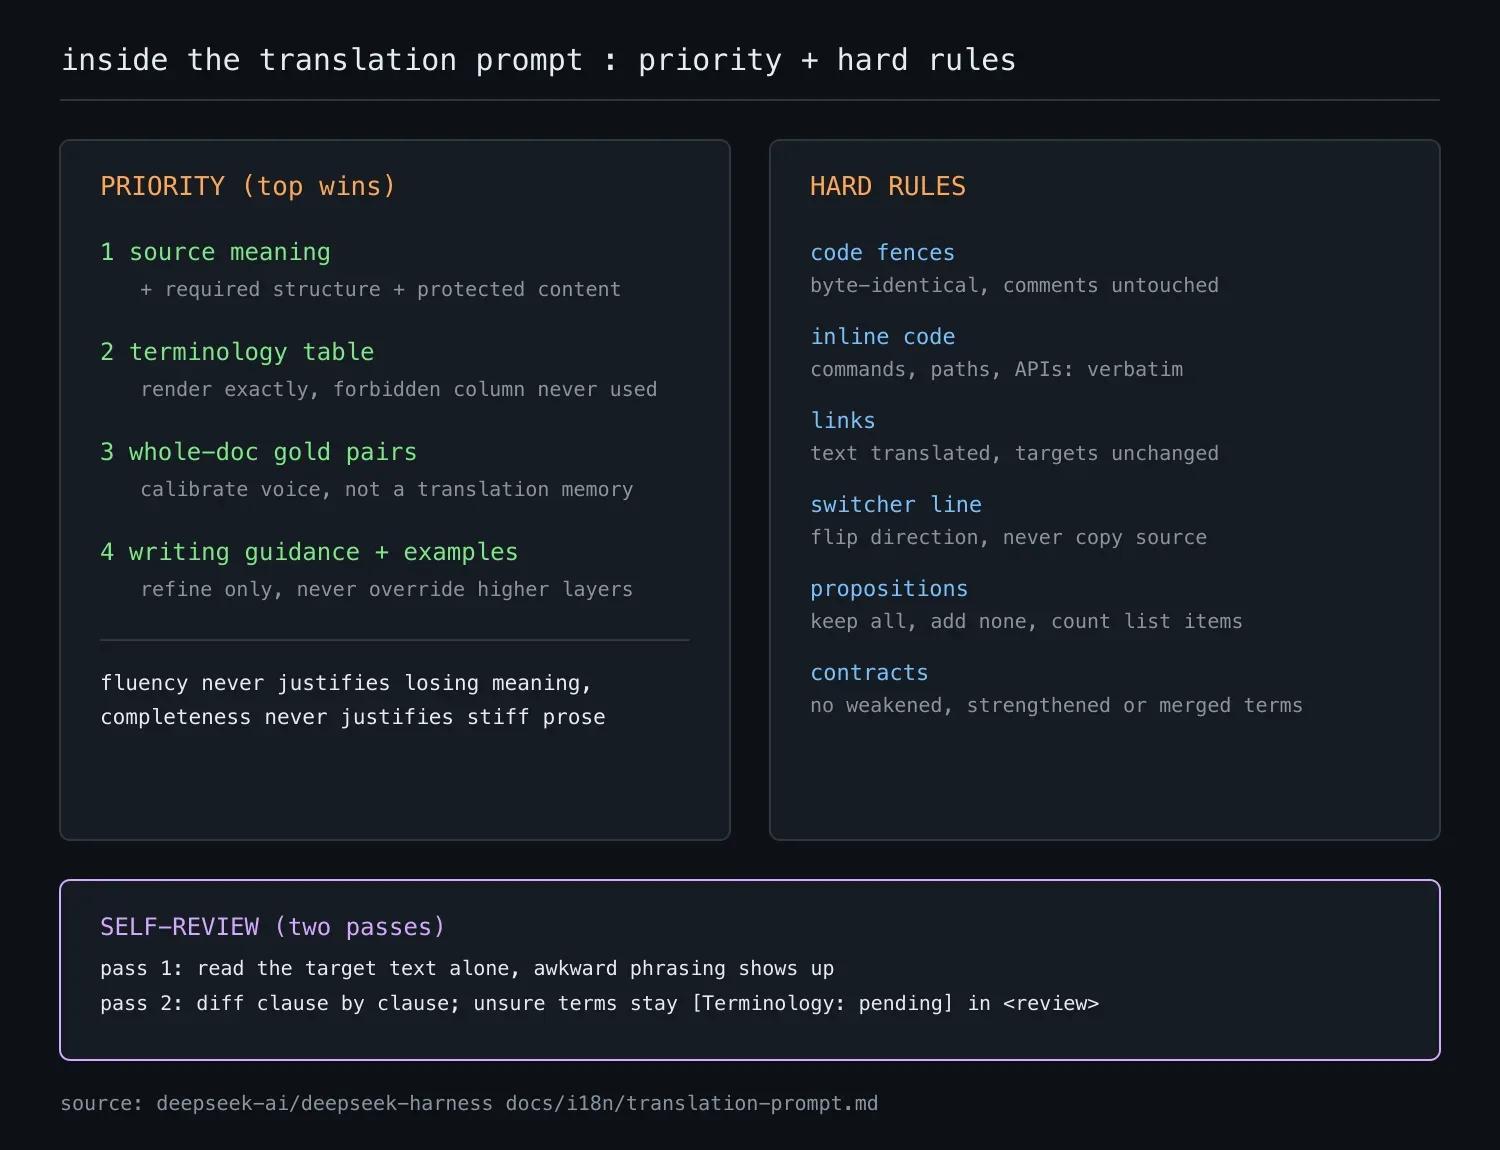
模板里最见功力的是一节 Priority,规定了四层权威的生效顺序:
- 源文含义,以及必需的文档结构、受保护内容和格式;
- 术语表,逐条严格执行;
- 整篇金样本,用来校准目标语言的口吻与措辞;
- 模板内的通用写作指导和示例。
低优先级规则可以细化高优先级,但永远不能覆盖它。模板特别强调:金样本校准的是语感,不是翻译记忆;任何风格偏好、金样本句式或内嵌示例,都盖不过源文含义、必需结构、受保护内容和术语表。
结构保持的硬规则
结构层面全是硬规则:输出必须是完整文档,标题层级与顺序、列表种类与条数、有序列表起始号、表格行列、链接目标、代码块都要与源文对齐。几个容易被忽略的细节:
- 围栏代码块逐字节一致,info string 和代码内全部注释都不许翻译、不许重排,没有例外;
- 行内代码原样保留,命令、参数、路径、标识符、API 与事件名、配置键、版本号这类机器可读 token 一律不动;
- 相对链接只译链接文字,不改链接目标;
- 语言切换行要翻转方向,英文源里的
English | [中文](README.zh.md)要译成[English](README.md) | 中文,不许照抄;源文没有切换行时也不许发明文件名,由流水线解析后机械补插,配对门禁兜底校验; - 强调标记的类型与语义覆盖范围不变,不许增删或移动。
忠实度:命题一个不丢,一个不加
忠实度要求逐命题保留、逐命题对齐:每个句子、列表项、注意、警告、示例、前提和保证都要在译文里有对应物,列表条数两边都要数。执行者、对象、条件、例外、否定、情态、因果关系和概念区分都要存活。
更进一步的是契约条款:完成与生命周期条件、失败行为、方向与数据流、正常与异常结果通道、所有权变更、数量边界,强度和方向都不许弱化、加强、反转或合并。流畅永远不构成丢意思的理由,完整也永远不构成逐字硬译的理由,这是整份模板反复回到的一对张力。
中文落地的细节
模板为中英两个方向各写了一节标点与措辞规则。中文方向包括:散文用全角标点,代码 span、数字和完整英文保留半角;并列项用顿号;中文与拉丁字母、数字之间留一个半角空格,全角标点旁边不留空格;数字修饰名词时补量词,比如译成「包含三种角色的能力 seam」而不是「三角色 seam」;列表项结尾要与语法一致,不许拿逗号收尾。
称呼用「你」不用「您」。RFC 2119 关键词译成必须、禁止、应当、可以,同时保留源文的强调级别:源文斜体译文就斜体,源文加粗译文就加粗,规范性强度不许减弱。破折号规则也与好的中文技术写作暗合:能用冒号、句号、逗号或括号说清楚就替换,只有破折号最自然时才保留。
三段输出与两遍自检
输出格式固定三段 XML:<translation> 放初稿,<review> 放修正记录,<final> 放终稿。review 只写实际发生的修正,一行一条带类别标签,没有修正就写「无修正」,不许写推理过程、通过的检查或撤回的建议。正文里如果出现这些标签行,要在行首加一个反斜杠转义,解析器剥掉恰好一层。
自检分两遍读:第一遍脱离原文只读译文,这时候别扭的措辞最容易暴露;第二遍逐句对照原文,查增删改和边界。所有疑问必须在写修正记录之前解决。
术语治理:三列表格加 pending 机制
术语表在渲染时整表注入,规则很细:目标语言是中文时走中文列,首次出现写带括号注释的版本,后文只写主词;已作为复合词注释过的单词,单独出现时不再重复注释;「不要译作」列是禁用译法,绝对不许出现。
对表外术语的处理最值得借鉴:中文目标优先采用主流中文开源社区或厂商文档的既定译法;没有可靠把握时,保留原文,在 review 段落记录 [Terminology: pending] 和一个试探译法,交给人工评审。试探译法只许出现在 review 里,不许悄悄混进终稿,也不许编造「某外部项目就是这么译的」。
模板里的正误例
模板内嵌了一组句子级正误例,每条对应一类典型问题:
- 口语动词换专业动词:「仓库在 package.json 中钉住 pnpm@11.7.0」改为「该仓库在 package.json 中固定使用 pnpm@11.7.0」;
- 生造词换自然表达:「旁挂记录」改为「伴随记录」;
- 过度直译换通顺表达:「不对照原文阅读译文时,更容易察觉别扭的表达」;
- 破折号换冒号:「FIXME:应当阻塞新版本发布的问题。除非评审者明确同意该更改可以合并,否则发布版本不应包含未解决的 FIXME。」
- 代码块注释绝不翻译:
# full-screen TUI coding agent (needs DEEPSEEK_API_KEY)原样逐字节保留。
写在最后
这份模板的骨架可以概括为四句话:模板即行为基线,改动要过评审;金样本即语感锚,整篇对整篇;优先级防覆盖,含义永远最高;pending 机制兜底,拿不准就交给人。想给开源项目搭中英双语文档流水线的话,这四条加上配对门禁的机械校验,是一套可以直接参考的作业。