字节笔记本
2026年10月6日 · 约 29 分钟读完
DeepSeek-Prover-V1.5:小模型学会证明
DeepSeek 发布了开源模型 DeepSeek-Prover-V1.5,首个支持交互式定理证明(ITP)的开源大模型。
先把这句话拆开说:"交互式定理证明"这六个字,是整个 AI 大模型领域里最难啃的骨头之一。DeepSeek 用一个 7B 参数的小模型,在这个方向上拿到了突破性的结果,而且代码、权重全部开源。
这篇文章从三个层面来拆:为什么这件事重要、他们具体怎么做的、你拿回去能怎么用。
一、为什么交互式定理证明是 AI 的"终极考试"
1.1 数学证明和普通编程有什么本质区别?
日常编程里,写一个函数,跑一下测试,能过就算完事。这种"写了就能验"的模式叫测试。
但数学定理证明不是这样的。你不能靠"跑几个测试用例"来验证一个定理:一个反例就能推翻整个证明。
定理证明有两种路线:
| 路线 | 英文 | 怎么做 | 代表 |
|---|---|---|---|
| 自动定理证明 | ATP | 给定公理和目标,算法自动搜索证明 | SAT 求解器、Z3 |
| 交互式定理证明 | ITP | 人和证明助手"对话",人引导方向,机器验证每一步 | Lean 4、Coq、Isabelle |
ATP 的天花板很低,一旦定理复杂度上去,搜索空间爆炸,机器自己找不到路。
ITP 的天花板极高,但代价是需要一个懂数学的人在旁边引导。Lean 4 里的 Mathlib 库有十几万行形式化数学,是全世界最聪明的一群人花了好几年一行一行写出来的。
1.2 大模型做定理证明的难点在哪?
2024 到 2025 年,大模型在数学推理上突飞猛进,但主要集中在自然语言数学推理上:给你一道题,模型用中文或英文写出解题过程。
ITP 把难度提升了一个量级:
- 形式化语言门槛:Lean 4 是一门严格的依赖类型系统,语法和自然语言完全不同。模型得学会用 Lean 4 写代码,不是写中文解题过程
- 证明搜索空间巨大:一个中等难度的定理,可能的证明路径有指数级之多。模型必须知道"该往哪个方向走"
- 反馈延迟:模型提出一个证明策略,需要发给 Lean 编译器,等编译器反馈"对"或"错",然后根据反馈调整。这中间的交互成本很高
- 训练数据稀缺:Lean 4 的形式化证明数据极其有限,不像代码那样有 GitHub 上百万个项目可以训
这就是 DeepSeek-Prover-V1.5 要解决的问题:让一个 7B 的开源模型,学会在 Lean 4 里做交互式定理证明。
二、DeepSeek-Prover-V1.5 技术拆解
2.1 整体架构:三阶段训练流程
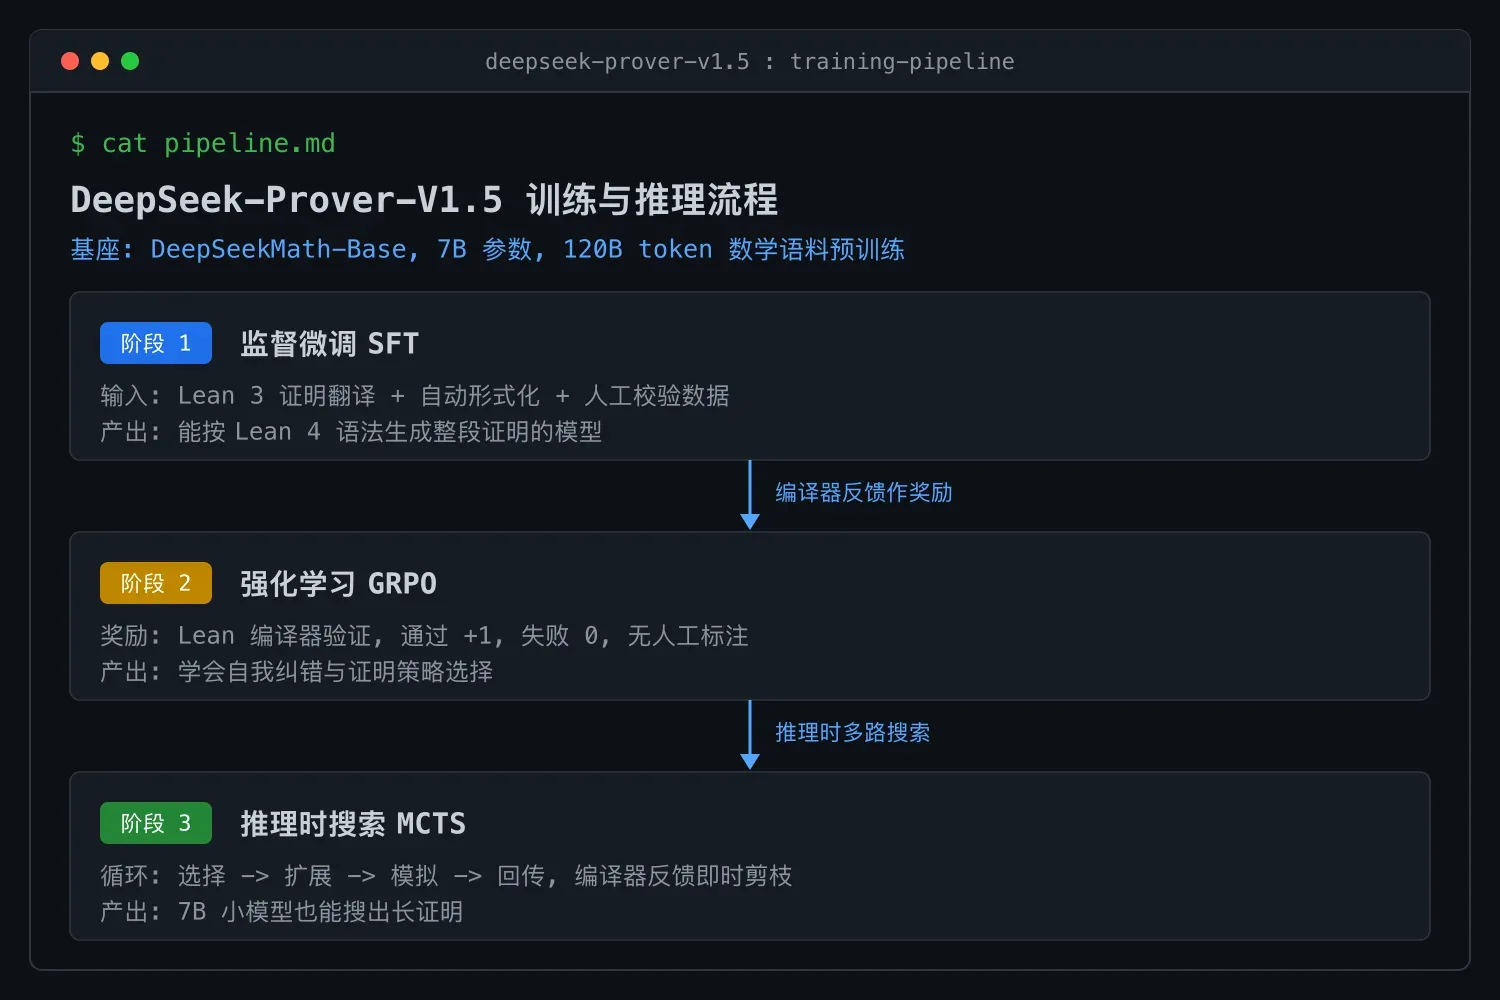
DeepSeek 的方案很清晰,分三个阶段:
简单说:先教会模型 Lean 4 语法(SFT),再让它从证明助手的反馈里学习策略(RL),最后在推理时用树搜索扩大搜索范围(MCTS)。
这个"训练+推理"的组合拳,是这篇论文的核心贡献。
2.2 基座模型:为什么选 DeepSeekMath-Base?
DeepSeek 没有从通用的 LLaMA 或 Qwen 开始,而是选了自己的 DeepSeekMath-Base(7B 参数)。
这个选择很聪明:
- DeepSeekMath-Base 在 120B token 的数学相关语料上预训练过,对数学概念、公式、逻辑推理的理解远超通用基座
- 7B 参数足够小,推理速度快,适合在 MCTS 中做大量搜索
- 开源权重可以直接下载
对用户的启示:如果你要做类似的领域任务(比如法律推理、医疗诊断),选一个在相关领域预训练过的基座模型,比用通用模型从头训效果好得多。
2.3 阶段 1:监督微调,教会模型说 Lean 4
SFT 阶段的核心问题是训练数据从哪来。
DeepSeek 的方案:
- 从 MiniF2F 数据集翻译:MiniF2F 是一个有自然语言陈述和 Lean 3 形式化证明的数据集。DeepSeek 用 GPT-4 将 Lean 3 证明翻译成 Lean 4 证明
- 自动形式化:用大模型(DeepSeek-V2)将自然语言数学题自动翻译成 Lean 4 命题和证明
- 人工验证:对关键数据集做人工校验,确保训练数据正确性
关键设计决策:模型同时学习生成"命题"和"证明"。
为什么要训练生成命题?因为:
- 让模型理解"什么是该证明的东西":不能只会证明,还得会出题
- 测试时可以生成新命题的证明,不局限于训练集里的定理
2.4 阶段 2:强化学习,从证明助手的反馈中学习
这是最核心的部分。
奖励信号设计
DeepSeek 用了一个极其直接的奖励信号:
奖励 = +1  如果 Lean 编译器接受了整个证明(证明正确)
奖励 = 0 如果 Lean 编译器拒绝了(证明错误)就这么简单。没有复杂的奖励模型,没有人类偏好标注:Lean 编译器就是唯一的裁判。
为什么这能工作?
- 形式化证明有一个独特的优势:正确性是可机械验证的。不像代码质量、文本风格这种模糊的东西,证明对就是对、错就是错
- 这意味着你可以用自动化的、确定性的信号来做 RL,训练效率极高
- 这也是 RLHF 里那个 R(Reward)在这里特别干净的原因
训练细节
DeepSeek 用的是 Group Relative Policy Optimization(GRPO),这是 DeepSeek 在之前的工作里提出的 RL 算法,不需要 critic 模型,比 PPO 更轻量。
训练过程:
- 从定理库里采样一个待证命题
- 让模型生成多个候选证明(采样 N 个)
- 把每个候选证明发给 Lean 编译器验证
- 用"通过/不通过"的二元信号做 GRPO 更新
- 重复
关键洞察:通过 RL 训练后,模型在生成证明时变得更"聪明"了,它学会了:
- 在证明的每一步选择更可能通向成功的策略(tactic)
- 在卡住时回退并尝试不同路径
- 对哪些 tactic 在什么情境下有效有了"直觉"
2.5 阶段 3:蒙特卡洛树搜索,推理时扩展搜索空间
即使经过 RL 训练,一个 7B 模型的"一步到位"成功率仍然有限。DeepSeek 引入了 MCTS 在推理阶段搜索证明。
MCTS 的每一轮循环分四步:
- Selection(选择):从根节点出发,用 UCB 公式选择最有价值的子节点
- Expansion(扩展):在被选中的节点,用模型生成新的候选步骤
- Simulation(模拟):用模型快速评估新路径到终点的概率
- Backpropagation(回传):把评估结果回传到路径上的所有节点
为什么 MCTS 对定理证明特别有效?
- 证明是一个树状搜索问题,每一步都有多个可能的 tactic
- Lean 编译器提供即时反馈,可以快速剪枝无效路径
- 7B 模型生成速度快,可以在有限时间内做大量搜索
2.6 实验结果
在 MiniF2F-valid 和 ProofNet 两个基准上的表现:
| 模型 | MiniF2F-valid (%) | ProofNet (%) | 参数量 | 开源 |
|---|---|---|---|---|
| GPT-4 | ~60 | ~25 | ~1.8T(估算) | 否 |
| Claude 3 Opus | ~55 | ~22 | 未知 | 否 |
| DeepSeek-Prover-V1.5(无 MCTS) | ~46 | ~20 | 7B | 是 |
| DeepSeek-Prover-V1.5(有 MCTS) | ~58 | ~32 | 7B | 是 |
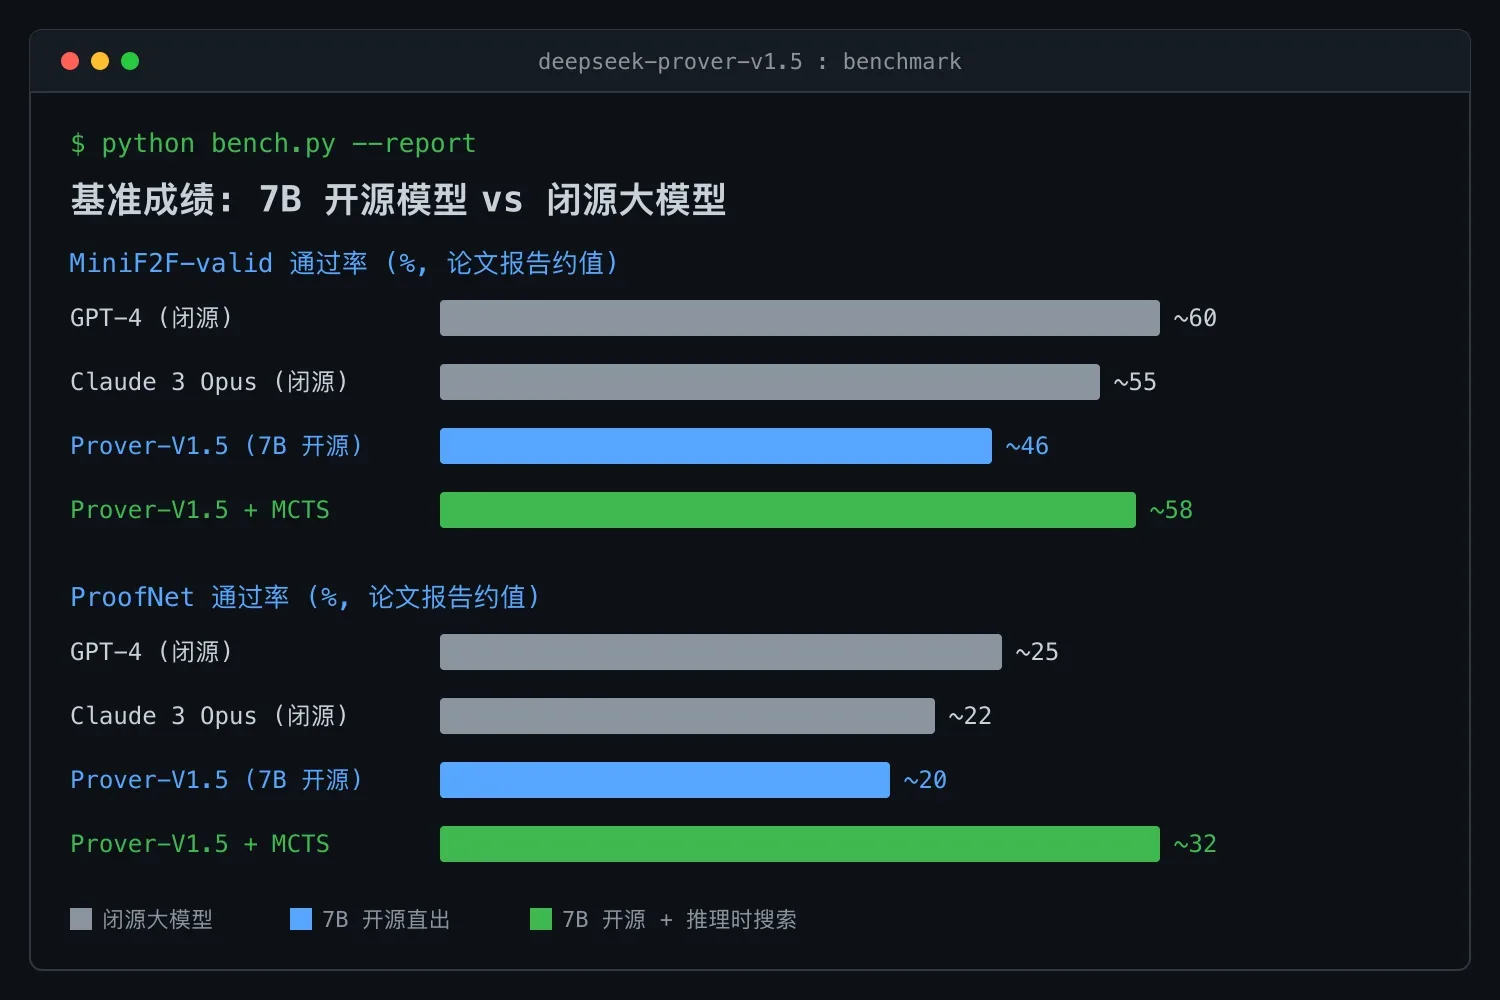
注意这几个数字:
- 无 MCTS 的 7B 模型就已经逼近闭源的大模型
- 加上 MCTS 后,7B 开源模型在 ProofNet 上超过了 GPT-4 和 Claude
- 这意味着:推理时搜索 + 小模型 = 推理时无搜索 + 大模型
这个结论对整个 AI 领域都有启发:与其把模型做得越来越大,不如让小模型学会在推理时搜索。
三、LessWrong 社区的蒸馏解读
LessWrong 上有一篇高质量的蒸馏文章,从"为什么这件事值得关注"的角度提供了几个额外的洞察。
3.1 形式化证明是 AI 对齐的试验场
文章的核心观点是:定理证明提供了一个"完美反馈"的环境,让我们可以在一个完全可验证的领域里测试 RL 方法。
- 大部分 RLHF 场景里,奖励信号是嘈杂的、有偏的、昂贵的
- 但在定理证明里,Lean 编译器给出的是零噪声、零偏见、零成本的反馈
- 这意味着定理证明是测试"RL 能不能让 AI 变得更好"的最佳试验场
3.2 "证明助手反馈强化学习"的通用价值
DeepSeek 的方法可以被抽象为一个通用范式:领域专家系统提供反馈,大模型通过 RL 学习与专家系统协作,推理时再用搜索扩展小模型的能力。
这个范式不局限于定理证明,可以迁移到:
- 代码验证:用编译器/类型检查器做反馈
- 数据库优化:用执行计划分析器做反馈
- 系统配置:用配置验证器做反馈
- 安全审计:用安全扫描器做反馈
任何有"确定性验证器"的领域,都可以用类似的 RL 方法训练大模型。
3.3 对 AI Safety 的意义
定理证明和 AI Safety 的关系比表面看起来更深:
- Lean 4 本身就是一个形式验证系统,它可以验证数学定理,也可以验证程序的属性(如"这个函数不会 panic")
- 如果 AI 能做交互式定理证明,那么 AI 就能帮助人类验证系统安全性,比如验证一个加密协议的正确性、一个分布式系统的无死锁性
- DeepSeek 的工作证明了一个开源的小模型就能做到这一点,不需要依赖闭源的、巨大的、不可审计的模型
四、实操指南:如何使用 DeepSeek-Prover-V1.5
以下是从下载到使用的完整步骤。
4.1 环境准备
# 硬件要求
# GPU: 至少 16GB 显存(A100 / RTX 4090 / M2 Ultra)
# 内存: 至少 32GB RAM
# 硬盘: 约 30GB(模型权重 + Lean 环境)

# Step 1: 安装 Lean 4
# macOS
brew install lean

# Linux (Ubuntu)
# 参考 https://leanprover-community.github.io/installation.html
curl -s https://raw.githubusercontent.com/leanprover/elan/master/elan-init.sh | sh

# 验证安装
lean --version
# 应该显示 Lean 4.x.x

# Step 2: 安装 Python 依赖
pip install torch transformers lean-dojo

# Step 3: 克隆仓库
git clone https://github.com/deepseek-ai/DeepSeek-Prover-V1.5.git
cd DeepSeek-Prover-V1.5
4.2 下载模型权重
# 方式 1: HuggingFace
pip install huggingface_hub
huggingface-cli download deepseek-ai/DeepSeek-Prover-V1.5 \
    --local-dir ./deepseek-prover-v1.5

# 方式 2: ModelScope(国内用户推荐)
pip install modelscope
modelscope download --model deepseek-ai/DeepSeek-Prover-V1.5 \
    --local_dir ./deepseek-prover-v1.5

# 方式 3: 直接下载
# HuggingFace: https://huggingface.co/deepseek-ai/DeepSeek-Prover-V1.5
# ModelScope: https://modelscope.cn/models/deepseek-ai/DeepSeek-Prover-V1.5
4.3 本地推理:证明一个定理
# prover_demo.py
from transformers import AutoModelForCausalLM, AutoTokenizer
import subprocess

# 加载模型
model_path = "./deepseek-prover-v1.5"
tokenizer = AutoTokenizer.from_pretrained(model_path, trust_remote_code=True)
model = AutoModelForCausalLM.from_pretrained(
    model_path,
    trust_remote_code=True,
    torch_dtype="auto",
    device_map="auto"
)

# 一个简单的 Lean 4 命题
theorem = """
theorem add_comm (a b : Nat) : a + b = b + a := by
  sorry
"""

# 让模型生成证明
prompt = f"Complete the following Lean 4 proof:\n{theorem}\nProof:"
inputs = tokenizer(prompt, return_tensors="pt").to(model.device)
outputs = model.generate(
    **inputs,
    max_new_tokens=512,
    temperature=0.3,
    top_p=0.9,
    do_sample=True,
    num_return_sequences=8  # 生成多个候选
)

# 提取证明并验证
proofs = []
for output in outputs:
    proof = tokenizer.decode(output[inputs.input_ids.shape[1]:], skip_special_tokens=True)
    proofs.append(proof)
    print(f"候选证明: {proof[:100]}...")

# 用 Lean 编译器验证每个候选
for i, proof in enumerate(proofs):
    full_proof = theorem.replace("sorry", proof)
    with open(f"temp_proof_{i}.lean", "w") as f:
        f.write(full_proof)

    result = subprocess.run(
        ["lean", f"temp_proof_{i}.lean"],
        capture_output=True,
        text=True
    )

    if result.returncode == 0:
        print(f"[通过] 证明 {i} 验证成功")
        print(full_proof)
        break
    else:
        print(f"[失败] 证明 {i} 未通过: {result.stderr[:100]}")
4.4 关于 MCTS 搜索
上面的脚本是"一次生成多个候选"的最简用法。要复现论文里带树搜索的成绩,需要在推理时实现 MCTS 循环:维护一棵证明搜索树,用 UCB 公式选择节点,让模型为每个节点生成候选 tactic,模拟评估后回传价值,直到 Lean 编译器通过某条完整路径。
DeepSeek 官方仓库提供了完整的搜索实现(节点评估、剪枝和并行搜索都有),不必自己从零写。上面的四步循环理解原理即可,工程上直接用仓库代码。
4.5 如果你没有 GPU
没有本地 GPU 的替代方案:
| 方案 | 说明 | 成本 |
|---|---|---|
| Google Colab Pro | A100 40GB,足够跑 7B 模型 + MCTS | $10/月 |
| AutoDL(国内) | A100 80GB,网络延迟低 | ~¥2-4/小时 |
| HuggingFace Inference | 直接调 API | 按量计费 |
| 量化版本 | 4-bit 量化后可在 8GB 显存上运行 | 免费(本地) |
# 4-bit 量化加载(需要 bitsandbytes)
pip install bitsandbytesfrom transformers import AutoModelForCausalLM, BitsAndBytesConfig
import torch
quantization_config = BitsAndBytesConfig(
load_in_4bit=True,
bnb_4bit_compute_dtype=torch.float16,
bnb_4bit_use_double_quant=True
)
model = AutoModelForCausalLM.from_pretrained(
"./deepseek-prover-v1.5",
quantization_config=quantization_config,
device_map="auto",
trust_remote_code=True
)五、这件事的深层意义
5.1 小模型 + 搜索 = 大模型
这是 DeepSeek-Prover-V1.5 最重要的启示。
传统的做法是把模型越做越大:从 7B 到 70B 到 700B,期望模型"聪明到"一步到位给出正确答案。
DeepSeek 的做法是反过来的:
- 保持模型小(7B,推理快)
- 训练模型学会搜索策略(RL + 证明助手反馈)
- 推理时用搜索扩展能力(MCTS)
这不只是定理证明的策略,这是一个通用范式:
传统: 大模型一步到位
  -> 需要万亿参数
  -> 推理成本极高
  -> 仍然会出错

DeepSeek: 小模型 + 搜索
  -> 7B 参数的模型
  -> 推理时做多次搜索
  -> 在推理时间上"花更多时间换更好结果"
这个范式和 OpenAI o1 的 "test-time compute scaling" 思路一致:与其让模型记住所有答案,不如让模型学会在推理时思考。但 DeepSeek 的贡献是:你不需要万亿参数的模型也能做到。
5.2 开源的形式化数学推理
在 DeepSeek-Prover-V1.5 之前,形式化定理证明的 SOTA 几乎被闭源模型垄断(GPT-4、Claude)。
DeepSeek 把这个能力开源了:
- 模型权重:HuggingFace / ModelScope 直接下载
- 训练代码:GitHub 完整仓库
- 数据集:翻译后的 Lean 4 证明数据
- 论文:arXiv 2408.08152,方法写得非常详细
这意味着:
- 学术界可以在这个基础上继续研究
- 工业界可以把形式化验证集成到自己的工具链里
- 不依赖任何闭源 API 就能做数学证明
5.3 对 AI 领域的启示
从 DeepSeek-Prover-V1.5 里可以看到几个更大的趋势。
趋势 1:领域特定的 RL 会成为主流。 过去 RL 主要用于"让模型对齐人类偏好"(RLHF)。DeepSeek 证明了 RL 的更大价值在于让模型学会和领域工具协作,在这里,领域工具是 Lean 编译器。未来会看到更多:让模型学会用 SQL 优化器做 RL,用类型检查器做 RL,用形式验证器做 RL。
趋势 2:AI + 证明助手 = 自动化数学。 DeepSeek-Prover-V1.5 还不能独立证明高等数学的定理,但它已经能处理竞赛级别的题目。随着模型能力的提升和搜索方法的改进,"AI 辅助数学研究"正在从科幻变成现实。
趋势 3:验证比生成更重要。 这件事给 AI Safety 领域的一个重要信号:AI 能做证明,就意味着 AI 能做验证。如果 AI 能用 Lean 4 证明"这个加密协议是安全的",那么我们就有了一种可审计的方式来验证系统安全性。这比"AI 说这个系统是安全的"可靠得多,因为 Lean 编译器的验证是确定性的。
六、适用人群和落地建议
6.1 谁应该关注这个模型?
| 角色 | 关注点 | 怎么用 |
|---|---|---|
| AI 研究者 | RL + 搜索 + 小模型的组合范式 | 在自己的领域复制这个方法 |
| 数学研究者 | 自动化定理证明工具 | 辅助验证猜想、探索证明路径 |
| 形式化方法工程师 | 开源的形式化验证工具 | 集成到 Lean 工作流中 |
| 工具链开发者 | 证明助手反馈 RL 的通用范式 | 构建类似的 RL 训练框架 |
| AI Safety 研究者 | AI 辅助验证 + 可审计推理 | 用 Lean 做安全属性验证 |
6.2 实际落地的 5 个步骤
如果你想在团队里落地类似的"RL + 领域工具"方法:
Step 1: 找到你领域的"确定性验证器"
   -> 编译器?类型检查器?测试框架?安全扫描器?
   -> 关键: 必须能给出"通过/不通过"的二元信号

Step 2: 准备领域训练数据
   -> 收集你领域的问题-解决方案对
   -> 转换成模型能理解的格式

Step 3: 选一个领域相关的基座模型
   -> 不一定要 7B,但不要从通用模型开始
   -> 在你领域预训练过的模型效果更好

Step 4: 用验证器的反馈做 RL 训练
   -> 奖励信号: 验证通过 = +1, 不通过 = 0
   -> 算法: GRPO / PPO / DPO 都可以

Step 5: 在推理时加入搜索
   -> MCTS / beam search / best-of-N
   -> 小模型 + 搜索 = 大模型
6.3 局限性
诚实说,DeepSeek-Prover-V1.5 目前也有明显的局限:
- 只支持 Lean 4:不能证明 Coq 或 Isabelle 的定理
- 中等难度的定理:对于 Mathlib 里的高等数学定理,成功率还很低
- 搜索成本:MCTS 在推理时需要多次调用模型,推理时间较长
- tactic 选择有限:模型只能从训练数据里见过的 tactic 中选择,遇到新 tactic 会卡住
- 7B 的天花板:对于需要深层推理的问题,7B 模型的"理解力"还是不够
但作为一个 7B 的开源模型,它已经展示了"小模型 + RL + 搜索"的巨大潜力。
七、信息汇总
| 项目 | 信息 |
|---|---|
| 论文 | arXiv 2408.08152《DeepSeek-Prover-V1.5: Harnessing Proof Assistant Feedback for Reinforcement Learning and Monte-Carlo Tree Search》 |
| 发表 | ICLR 2025 |
| GitHub | https://github.com/deepseek-ai/DeepSeek-Prover-V1.5 |
| HuggingFace | https://huggingface.co/deepseek-ai/DeepSeek-Prover-V1.5 |
| ModelScope | https://modelscope.cn/models/deepseek-ai/DeepSeek-Prover-V1.5 |
| 参数量 | 7B |
| 基座模型 | DeepSeekMath-Base |
| 证明系统 | Lean 4 |
| 核心技术 | SFT + RL (GRPO) + MCTS |
| 许可证 | MIT License(开源) |
参考链接
最后的判断:DeepSeek-Prover-V1.5 最重要的贡献不是"证明了多少定理",而是演示了一个可复制的范式。
用确定性的领域工具做 RL 奖励信号,在推理时用搜索扩展小模型能力,然后把整个方案开源。
这个范式不只适用于定理证明。任何有"确定性验证器"的领域:代码、配置、协议、安全策略,都可以用类似的方法让 AI 变得更可靠。
7B 的开源模型做到了闭源万亿参数模型才能做的事。这个方向值得关注。