字节笔记本
2026年10月27日 · 约 3 分钟读完
KLD 几乎不动,EAR 掉了 2-3%:Strata 量化复盘
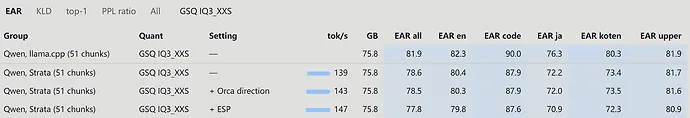
上次 Strata 量化测试被吐槽「结论不清晰、太长懒看」,这次帖主把 DeepSeek v4.1-flash-1017 与 Qwen 3.8-flash-next 的量化数据做成了 artifact,结论浓缩成几个标题。测试平台是 9950X3D 加 64G DDR5-6400(实际只用了 30G 内存)、RTX 5090 32G、9100 Pro 与 P5800X 双 SSD。
最核心的发现是 EAR 指标揭穿了 Strata 的隐藏损失。在 KLD、top-1 甚至 PPL 几乎与原版完全一致的情况下,EAR(Expected Acceptance Rate,出自统计无损量化论文 SLQ,arXiv 2605.02404)平均仍差 2-3%,超过误差范围。按 unsloth 的估算表,这个幅度相当于从 IQ3_XS 掉到 IQ3_XXS 的一级量化。
EAR 之所以比 top-1 敏感,在于它衡量的是概率分布的重叠程度:原版两个候选 0.51 与 0.49,量化后翻转成 0.49 与 0.51,top-1 判为不一致,但 EAR 仍有 98%;反过来原版 0.9 对 0.1 变成 0.6 对 0.4,top-1 仍判一致,EAR 却只剩 70%。只看 top-1 的测试天然会漏掉这类损伤。
内存方面也有反直觉的结论:把跑模型的内存从 30G 提到 42G,精确模式的 tps 只有个位数变化,light、fast 两个加速模式的提升更是只有 1%。可另一位 A 卡用户的报告里,内存从 60G 加到 75G 却提速 40%,帖主用带宽解释了这个谜:DDR5 约 100G/s,内存到显存的 PCIe 5.0 x16 交换只有 50G/s 出头,双 SSD 加起来近 20G/s,对显卡而言这三者都是「慢」,只有显存 2000G/s 独一档,所以内存的加成远没有想象中大。顺带一提,开着 Chrome 跑模型挤爆内存那次,速度掉了约 9%。
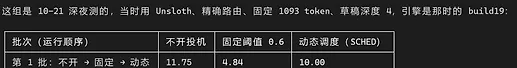
投机解码方面,DeepInfer 的 Dspark 动态调度草稿性能约是固定阈值 0.6 的两倍,但有意思的是帖主这台机器什么都不开反而最快,作者怀疑 Strata 对 MTP 的支持还不够好。
给准备在 64G 内存机器上部署的人划重点:量化损失要看 EAR 而不是只看 PPL;先堆内存不如先确认专家交换路径;投机解码未必是加速,实测说话。