字节笔记本
2026年10月4日 · 约 19 分钟读完
4000 元双 V100,13 款本地大模型狠狠干了一遍:谁才是低成本部署之王?
大模型本地部署,其实最终就看两件事。
模型够不够强,以及跑得够不够快。
模型再聪明,一秒钟吐两三个 Token,用起来一样折磨。速度再快,碰到复杂任务就开始胡说八道,同样没有生产力价值。
所以这一次,我干脆把目前一批热门本地模型全部拉到同一套硬件上,来了一场真正的正面对决。
硬件也没有上什么 RTX 6000、5090,更没有堆几十万的服务器。
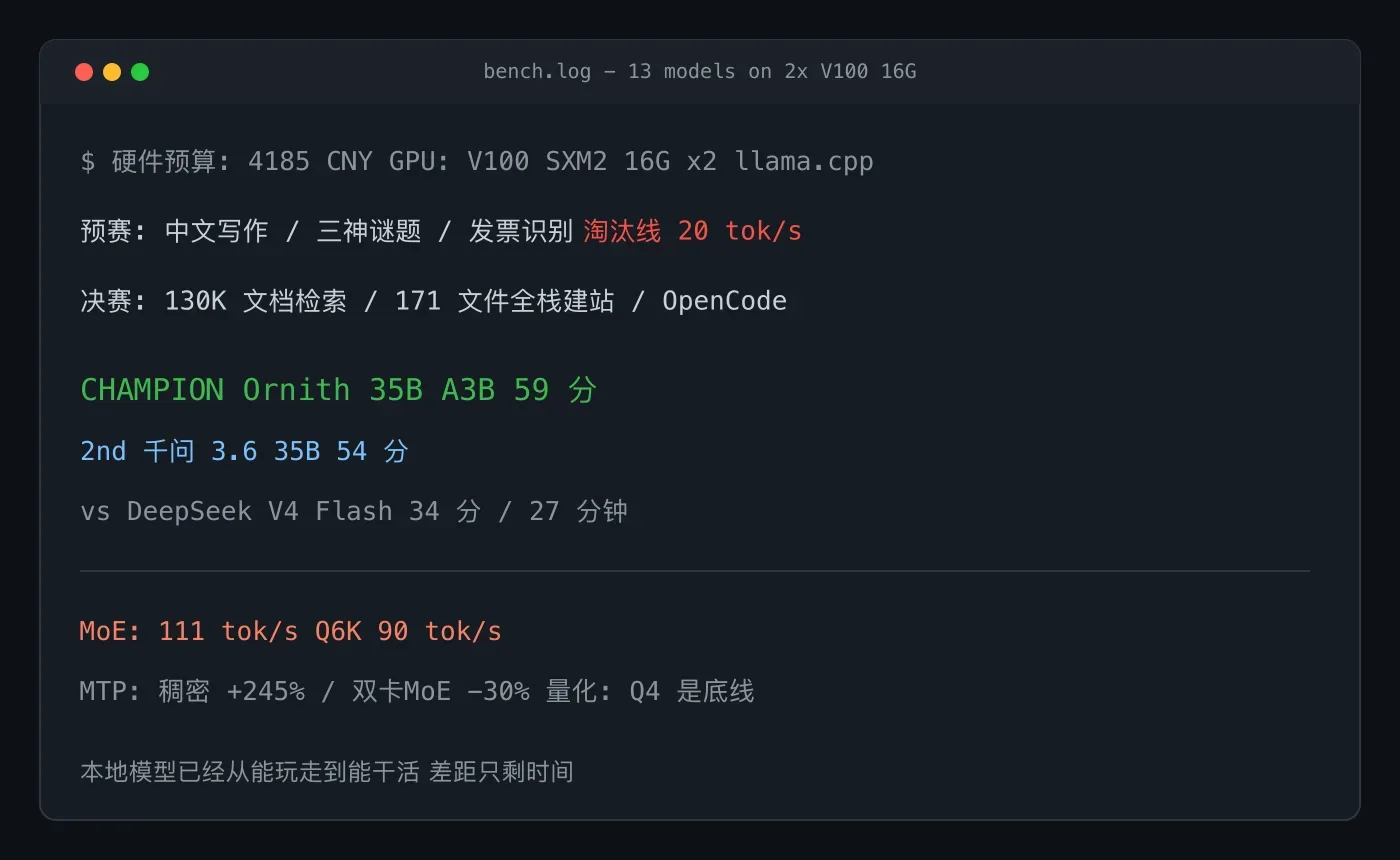
整套机器 4000 元出头,两张 16GB V100 SXM2。
我要看的只有一件事。
在普通人真正能够承担的硬件成本下,现在的本地大模型,到底已经能做到什么程度?
最后胜出的模型,我还直接拿去和在线大模型跑同一个 Agent 工程任务。
结果比我预想中有意思得多。
先说硬件:4000 多块,两张 V100
这次所有测试,都跑在一台自己组装的机器上。
整机价格大约 4185 元,其中两张 16GB V100,加上 32GB DDR4 内存,大约占了 3000 元。
两张卡都能跑满 PCIe 3.0 x16。
这套东西最大的特点就是便宜。
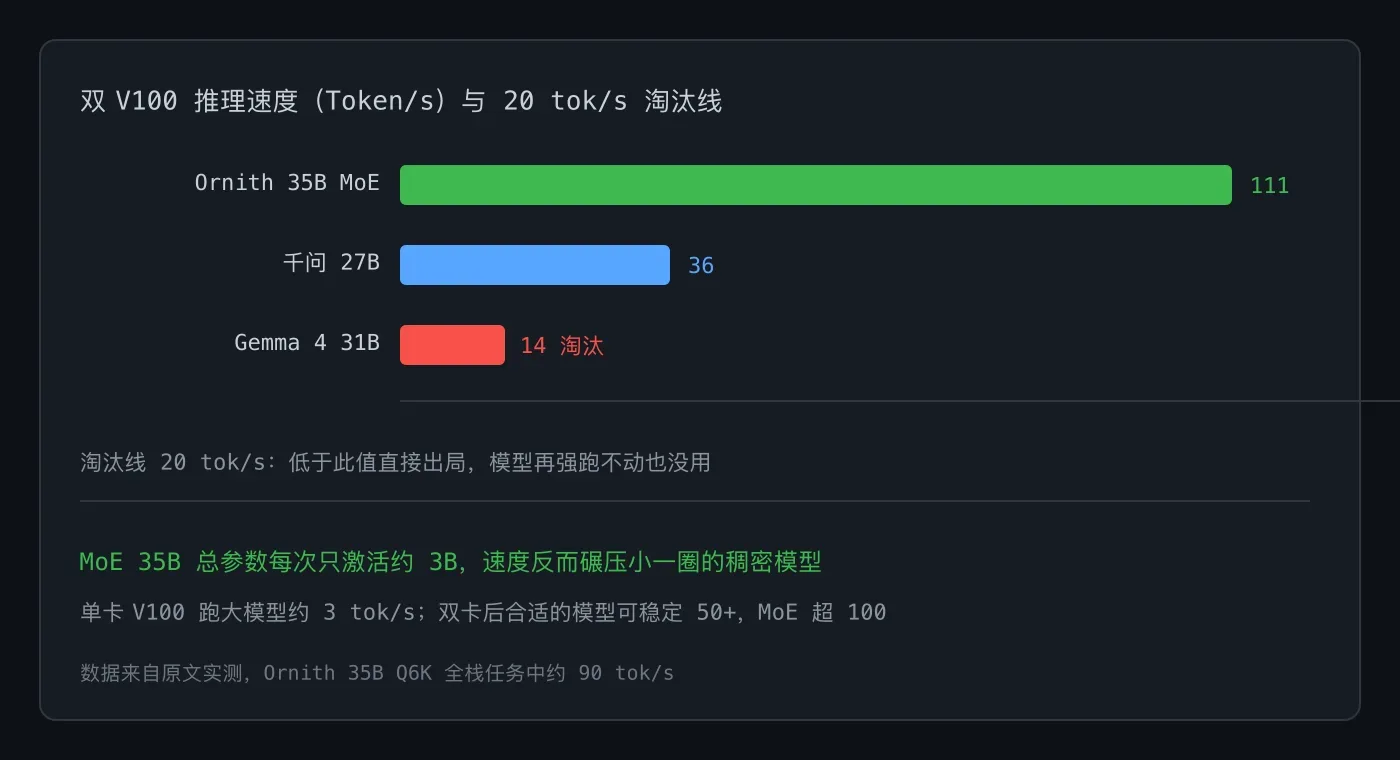
单张 V100 跑稍大的模型,速度很容易掉到 3 Token/s 左右,基本已经到了没法正常使用的程度。但双卡以后,大部分合适的模型已经可以稳定跑到 50 Token/s 左右,有些甚至超过 100 Token/s。
所以我给所有模型划了一条很简单的生死线:
双卡推理低于 20 Token/s,直接淘汰。
因为本地模型最终是拿来用的。
参数再漂亮、榜单分数再高,真实使用的时候等半天才蹦几个字,没有意义。
这里也顺带回答一个很多人都会问的问题:为什么要折腾本地模型?
答案其实也很直接。
隐私、安全,以及长期成本。
内部文档、代码、病例、合同、图片资料,并不是所有东西都适合直接扔给云端 API。断网环境、隔离网络、本地资料库,更是天然适合本地部署。硬件买完之后,长期运行剩下的主要成本也就是电费。
所以这次测试没有围着那些“1+1 等于几”的榜单题打转。
我更关心一个问题:
这些模型真正进入你的电脑,能不能干活?
13 款模型,先打一轮预赛
这次一共测试了 13 个模型。
按照参数规模,大致分成三组:
12B 以下算入门组,12B 以上的稠密模型进入进阶组,MoE 模型单独放进专家组。
所有模型统一使用开源的 llama.cpp。
第一轮预赛一共三道题。
中文写作、逻辑推理、发票识别。
三个任务看起来简单,实际上刚好覆盖本地模型最常见的三类能力:语言质量、推理,以及视觉信息提取。
第一关,中文到底会不会说人话
第一道题非常简单。
让模型帮一只小猫竞选小区楼长,100 字以内写一段竞选宣言。
要求只有两个:
不无聊,不套路。
结果这一题反而暴露出了很多问题。
有些模型参数不小,中文写出来依然一股翻译腔;有些甚至直接输出英文或者繁体中文。
最终中文写作表现最好的是 Ornith 35B A3B,第二名是 Gemma 4 26B A4B QAT。
让我比较意外的是 Ornith 9B。
参数并不大,但中文写作质量相当不错。
相反,一些社区微调模型表现非常糟糕,不仅没有因为微调变得更强,反而连基础中文输出都出了问题。
这也是本地模型很容易踩的一个坑。
模型名字后面多了几个“优化”“中文增强”“社区版”,不代表真的更好。
尤其是小数据集微调,很可能强化了某一种能力,同时把底模原本已经很好的能力搞坏。
第二关,史上最难逻辑谜题
第二道题直接上强度。
经典的“三神谜题”。
三个神分别代表真话、谎言和随机,你只能问三个问题,还不知道对方回答中的两个词哪个代表“是”,哪个代表“否”。
这题的结果非常整齐。
26B 以上的模型全部做对。
而 26B 以下的小模型,全部失败。
小模型当然也不是完全不会推理,有些步骤是对的,但走到长链条推理以后就开始断。
其中有的 9B 模型甚至出现了非常明显的幻觉。
这一轮给我的感受非常明确。
小模型平时聊天、总结、提取信息,看起来已经相当聪明。
可一旦进入需要持续保持逻辑一致性的长推理任务,参数规模造成的差距依然存在。
这也是为什么不能光看“日常对话感觉差不多”,就认为 9B 和 30B 级模型已经没有区别。
第三关,真正高频的本地任务:识别发票
第三道题我直接给模型扔了一张信息非常密集的电子发票。
商品名称、税率、金额、订单号等内容全部提取出来,再用脚本自动核对。
这一轮反而是千问系占据绝对优势。
从 9B、27B 到 35B,千问系模型的视觉识别成绩都非常好。
Gemma 4 的几款模型即使把视觉预算拉高,依然会出现一些漏字和信息错误。
更有意思的是两个社区微调模型。
它们的底模原本几乎可以拿满分,微调以后反而只剩下 4 到 5 分,金额、编号、文字内容各种错误都有。
看到这里,其实已经能得出一个非常重要的结论。
如果你的主要任务是 OCR、票据识别、图片资料整理,底模本身的多模态能力,往往比那些花哨的社区微调更值得优先考虑。
第一批模型开始掉队
三轮预赛结束以后,一批模型直接被淘汰。
Gemma 4 12B 和一款 9B 模型总分只有 16 分。
千问 9B 也没能晋级。
Gemma 4 31B 更尴尬。
能力本身没有太大问题,但是放到双 V100 上,最高只有大约 14 Token/s,直接撞上了我前面定下的速度红线。
模型再强,跑不动也没有用。
反而千问 27B,在同样双卡环境下可以跑到 36 Token/s,顺利晋级。
这里基本也测出了双 16GB 显卡的一个现实边界。
在不量化 KV Cache 的情况下,27B 左右已经接近比较舒服的稠密模型上限。
真正让我意外的是 MoE。
Ornith 35B 不但预赛成绩接近满分,双卡速度甚至直接跑到了 111 Token/s。
参数量看起来更大,实际速度反而远超很多小一圈的稠密模型。
原因就在 MoE 的工作方式。
稠密模型每次推理,基本所有参数都需要参与计算。
MoE 则会把模型拆成多个“专家”,每次回答只激活其中一部分。
比如一个 35B 级 MoE,实际每次可能只激活大约 3B 参数。
于是它既能保留更大的总模型容量,又不用每生成一个 Token 都把全部几十 B 参数重新计算一次。
这也是这次双 V100 测试里,MoE 开始疯狂占便宜的地方。
真正的决赛:不要再做题了,直接干活
进入决赛以后,我不再给模型做普通 Benchmark。
因为真正决定一个本地模型有没有价值的,从来不是它会不会解几道题。
而是你把几十个文件、几百页 PDF、一个完整项目扔给它,它能不能从头做到尾。
决赛满分 100 分。
任务包括复杂图片理解、超长文档检索、Excel 文档生成、全栈应用开发,以及推理速度。
130K Token 文档,全部通过
其中一项测试,是在一份 110 页、约 130K Token 的中英文 PDF 中,寻找位于接近第 100 页的一段内容,再根据文章进行逻辑推理。
这一轮 5 个决赛模型全部拿到满分。
这个结果其实非常重要。
因为它意味着今天优秀的本地模型,在超长文档场景里已经开始真正具备可用性。
至少在这次测试环境中,即使输入超过 128K,几款决赛模型依然可以完成检索和推理任务。
对于企业内部知识库、合同、论文、技术文档,这种能力的实际价值要远远高于很多榜单分数。
然后,我让它们直接写了一个完整网站
真正拉开差距的是第四轮。
这是整个测试里分值最高的一项。
我准备了一套小说素材库,里面有 171 个文档,包括人物设定、世界观、章节、图片、视频等内容。
模型首先要逐一读取文件,对内容进行分类和总结,然后生成 Excel 清单。
接下来再继续:
从零搭建一套在线小说阅读网站。
创建 MySQL 数据库,把素材全部导进去,完成前端、后端以及对应功能。
整个测试统一使用 OpenCode,接入本地推理服务。
大部分模型开启 256K 上下文。
只有千问 27B 因为显存限制,只能跑 128K。
这一轮,差距终于彻底被拉开。
小模型最大的问题:不是笨,是一直犯错
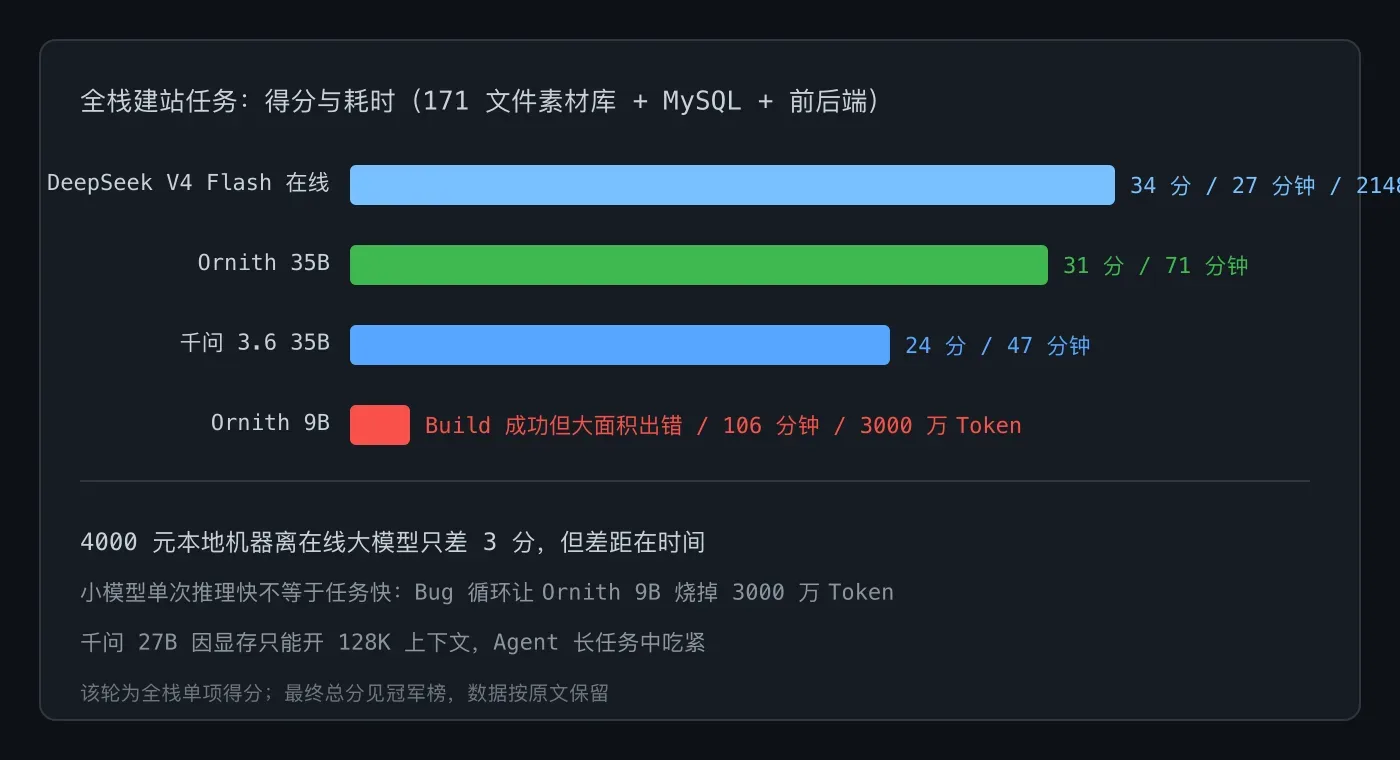
Ornith 9B 非常努力。
它一共消耗了 3000 万 Token,是所有模型里面最多的。
最终耗时 106 分钟。
它确实把项目 Build 成功了。
但真正打开以后,除了首页,大部分页面都有不同程度的错误。
这就暴露出了小模型做复杂 Agent 任务时一个非常典型的问题。
它会写错。
然后 Agent 框架发现错误,再让它修。
修完这里,又弄坏那里。
于是整个过程就变成:
制造 Bug、检查 Bug、修 Bug,再制造新的 Bug。
最终看起来模型单次推理很快,整个任务反而变慢了。
这也是我越来越不认同“Agent 就应该全部用小模型”的原因。
简单的工具调用、分类、路由,小模型当然很香。
可一旦进入长程复杂任务,单 Token 便宜、单次推理快,并不代表整个任务便宜。
真正应该看的指标,是 Task Cost。
完成一个完整任务,究竟需要多少时间、多少 Token、多少次返工。
千问 27B,败在了上下文
另一个非常让我意外的是千问 27B。
它总共只消耗了 391 万 Token,是所有选手里最低的。
但是耗时达到 103 分钟。
最终虽然 Build 成功,绝大多数页面依然存在严重问题。
我怀疑一个非常重要的原因,就是它因为显存限制,只能开到 128K 上下文。
对于这种连续几十分钟、需要反复读取项目状态、修改代码、重新检查的 Agent 任务来说,128K 很快就会开始吃紧。
而其他模型可以开到 256K。
这次测试让我越来越明显地感受到:
进入 Agent 时代以后,上下文窗口已经开始变成一种真正的“硬件资源”。
复杂工程里,256K 和 128K 的区别,并不只是“多塞几篇文章”。
它会直接影响模型还能不能记住自己前面做过什么。
本地模型和在线大模型,到底差多少?
为了知道这些成绩究竟处于什么水平,我又加了一位场外选手。
DeepSeek V4 Flash。
通过官方 API,完全相同的环境和提示词,执行同一个全栈任务。
最终它消耗了约 2148 万 Token,耗时 27 分钟,拿到了全场最高的 34 分。
这当然不算公平竞争。
DeepSeek V4 Flash 本身就是 284B 级 MoE,规模远大于这次本地测试的模型。
所以我也没指望两张二手 V100 把云端大模型干翻。
我真正想看的,是:
4000 块钱的机器,到底能追到什么程度?
结果第二名的千问 3.6 35B,耗时 47 分钟,最后拿到 24 分。
而真正让我惊讶的,是 Ornith 35B。
它在 Q6K 下的推理速度可以达到大约 90 Token/s。
整个任务用了 71 分钟。
它没有像小模型那样陷入大量无效返工,而是持续检查、修改、完善。
最终成品拿到 31 分。
和 DeepSeek V4 Flash 的 34 分,只差了 3 分。
看到这个结果,我第一反应其实是:
那以后是不是写代码都可以直接用本地模型了?
暂时还不能这么说。
真正的差距依然非常明显。
不是最终成品差距。
是时间。
27 分钟和 71 分钟,在 Benchmark 里看起来只是一串数字。
真正工作的时候,就是完全不同的体验。
真实生产力场景中,时间永远是最贵的资源。
最终冠军出来了
所有项目结束以后,最终冠军是:
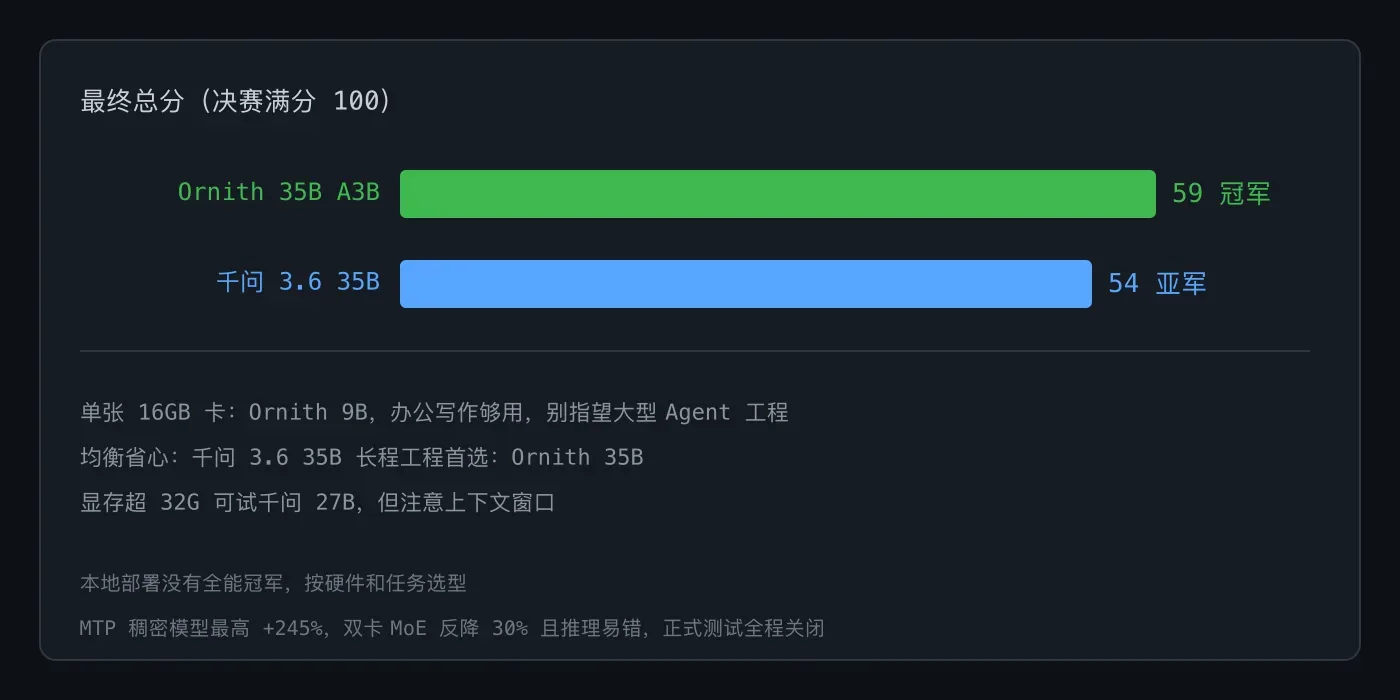
Ornith 35B,59 分。
第二名:
千问 3.6 35B,54 分。
但如果你现在准备照着榜单直接下载冠军,我反而建议先别急。
因为本地部署从来不存在一个所有人通吃的“最佳模型”。
真正应该根据你的硬件和任务来选。
如果显存超过 32GB,可以尝试千问 27B,但一定要关注上下文窗口。
如果只有一张 16GB 卡,Ornith 9B 是这次测试里非常值得考虑的选择。普通办公、写作、总结、资料处理已经够用,但不要期待它稳定完成大型 Agent 工程。
如果希望兼顾速度、稳定性以及 Token 消耗,千问 3.6 35B 是更加省心的选择。
如果你的主要需求就是长程任务、复杂工程、Agent 编程,Ornith 35B 是这次测试里的第一选择。
为什么这次 MoE 赢得这么彻底
做完整轮测试以后,我最大的感受,其实还不是某一个具体模型赢了。
而是:
低成本本地部署,MoE 的优势正在越来越大。
以前我们谈本地模型,经常第一反应就是参数量。
7B、14B、32B、70B。
参数越大,显存需求越高,速度越慢。
MoE 把这套简单关系打破了。
它可以拥有 35B 的总参数规模,但每次只激活其中很小一部分。
这意味着,在双 V100 这种算不上豪华的硬件上,它反而能够同时获得比较好的能力和非常夸张的生成速度。
这次 Ornith 35B 能赢,不只是因为能力强。
更重要的是:
它对硬件没有那么挑。
对于普通玩家来说,这一点甚至比 Benchmark 再高几个百分点更重要。
量化不要贪,Q4 基本已经是底线
另一个非常重要的经验是量化。
开源模型原始权重通常会以 16 位格式保存。
一个 12B 模型,权重本身就可能需要 20GB 以上显存。
所以本地玩家几乎绕不开量化。
这次大部分模型主要测试 Q4、Q6。
决赛里,除了特殊 QAT 模型之外,基本都尽量使用 Q6K,目的很简单:
让模型尽可能保留原始能力。
我的建议依然是,不要为了硬塞模型,一路把量化压到特别低。
4bit 基本已经可以看作实用下限。
继续往下压以后,与其承受明显的能力损失,不如直接换一个参数更小、精度更高的模型。
MTP 也不是免费加速
这次测试还有一个非常有意思的东西。
MTP,Multi-Token Prediction。
传统大模型一次预测下一个 Token,而 MTP 会尝试一次预测多个 Token,再让主模型验证。
理论上可以明显提高生成速度。
实际测试也确实如此。
在部分 27B 稠密模型上,提升非常明显,最高一次甚至测到了 245%。
但到了双 V100 跑 MoE,事情完全反了过来。
开启 MTP 以后,部分模型速度反而下降超过 30%。
原因在于双 GPU 会引入额外的跨卡通信。
MTP 节省掉的串行生成成本,还没有跨卡通信增加的成本高。
更麻烦的是,MTP 还可能影响复杂推理准确率。
前面的逻辑题,在开启 MTP 后,大约一半测试会出现错误。
所以这次正式比赛,我最后选择了全程关闭 MTP。
我的建议也很简单。
纯追求速度,可以试。
复杂推理和 Agent 任务,谨慎开。
最后再说一个本地模型老毛病:无限循环
很多人跑本地模型,最后都会撞到同一个问题。
模型突然开始重复一句话。
不停循环。
或者重复生成完全一样的代码。
这次测试里我也遇到了。
它通常是几个因素叠加造成的。
低精度量化会破坏部分关键权重;MoE 每次实际激活参数占比较低,一旦关键部分被量化影响,更容易出现异常;再叠加超长上下文和某些特殊提示词,就可能把模型绕进死胡同。
这个问题目前很难彻底消灭。
最有效的方法依然非常朴素:
提高量化精度,或者换模型。
同时尽量避免那些已经验证过容易把模型带入循环的提示词。
写在最后
这一轮测下来,我对本地模型最大的感受是:
它真的已经从“能玩”,走到了“能干活”。
130K Token 文档检索、复杂图片理解、结构化资料整理、Excel 生成,甚至完整的全栈项目,现在都已经可以交给本地模型完成。
当然,它距离最强的在线模型仍然有差距。
尤其是在长程工程任务中,最大的差距已经逐渐从“能不能做出来”,变成了:
需要花多久做出来。
但别忘了,这次跑这些模型的并不是什么几十万元服务器。
只是一台 4000 元出头、塞了两张老 V100 的机器。
更重要的是,所有数据、文档、代码,都可以留在自己的机器上。
不需要按照 Token 一直交 API 费,也不需要每隔几个月担心某个模型涨价、降额度或者下线。
所以如果问我,2026 年还有没有必要折腾本地大模型?
我的答案已经和一两年前完全不同了。
如果只是聊天,确实没有必要。
但如果你想搭自己的知识库、文档处理系统、本地 Agent、代码 Agent,或者有隐私数据需要长期处理,本地模型已经进入了真正值得认真研究的阶段。
而这一次测试给出的答案也非常清楚。
一张 16GB 卡,先看 Ornith 9B。
追求均衡和省心,看千问 3.6 35B。
需要长程 Agent 和复杂工程,这次冠军就是:
Ornith 35B。
至于下一步,我更想干的事情已经不是继续刷模型榜单了。
而是把这套 4000 元双 V100 机器,真正搭成一台 24 小时在线的本地 AI Agent 主机。
让它自己跑模型、读文件、写代码、执行定时任务、连接其他电脑。
到了那个时候,本地大模型真正有意思的部分,才刚刚开始。