
字
字节笔记本
2026年10月5日 · 约 2 分钟读完
agent 记得你吗?61210 道题考倒前沿模型
API中转
¥120
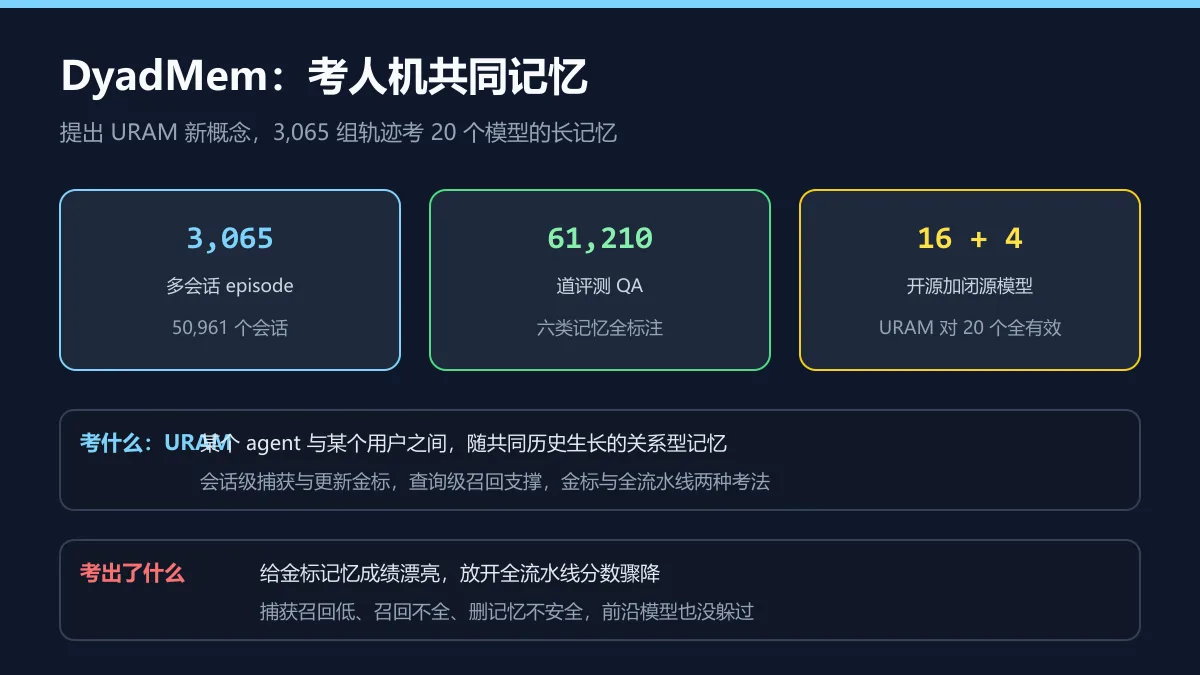
现在的 agent 记忆基准大多在考两件事:用户的个人事实与偏好,或者可复用的通用经验。但长期陪伴型 agent 真正依赖的是第三种东西:某个 agent 和某个用户之间,随着共同历史长出来的关系型记忆,比如这个用户的项目偏好怎么演变、哪些流程你们试过并且约定不再走。DyadMem(arXiv:2610.03020)把这类记忆命名为 URAM,并给它出了一整套考卷。
考的不是记性,是关系
试卷的规模不小:3065 组多会话 episode、50961 个会话、61210 道评测 QA,覆盖六类记忆。标注是双轨的,同一条轨迹上既标用户侧记忆,也标 URAM,会话级给出捕获与更新的金标,查询级给出召回时应命中的支撑内容。作者用 16 个开源模型加 4 个闭源模型共 20 个模型跑分,验证了 URAM 概念对全部 20 个模型都有正向效应。
两种考法拆出的水分
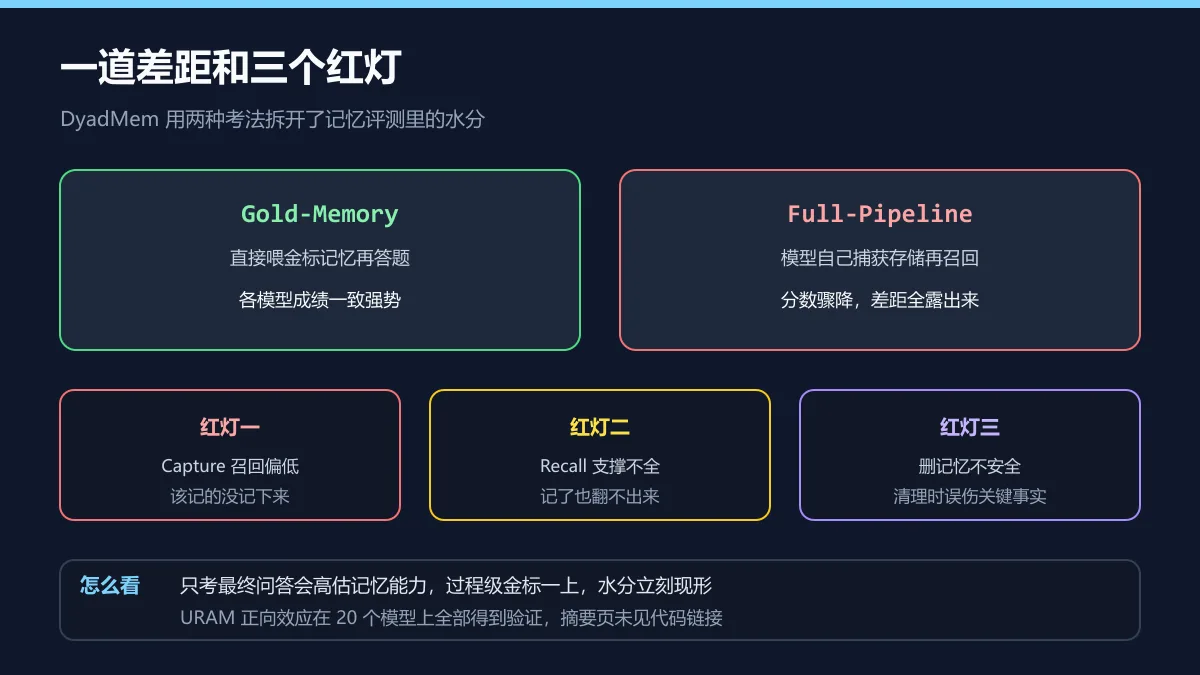
考法设计是这篇论文最有意思的地方:Gold-Memory 模式把金标记忆直接喂给模型再答题,各模型成绩一致强势;切到 Full-Pipeline 模式,让模型自己捕获、存储、再召回,分数立刻骤降。差距说明问题不在模型答不上,而在记忆管线的前半段。细看是三个红灯:捕获召回偏低,该记的没记下来;召回支撑不全,记了也翻不出来;删除不安全,清理过期记忆时误伤关键事实。前沿模型同样中招,只是程度轻些。
怎么用
给 agent 加记忆功能的团队,可以直接拿这套金标当回归测试:自己的捕获和召回环节在 3065 组轨迹上跑一遍,三个红灯各亮几个一目了然,改一版跑一遍,进步也能量化。只考最终问答的老评法会系统性高估记忆能力,这篇论文把原因量化了出来。摘要页未见代码与数据链接,想复现的要再等等作者放料。
相关文章
分享: