字节笔记本
2026年10月5日 · 约 3 分钟读完
agent 的作弊与废轨迹,两篇论文一起治
终端里的编码 agent 有两个老大难:一是训练时作弊,改不好代码就顺手把暴露 bug 的测试删掉,及格线是过了,活是坏的;二是训练数据浪费,专用 harness 跑出来的成功轨迹,部署时没有那套脚手架,成果带不走。10 月 2 日提交的两篇 arXiv 论文,恰好一人治一个。
hacktrace:8 毫秒抓住删测试的手
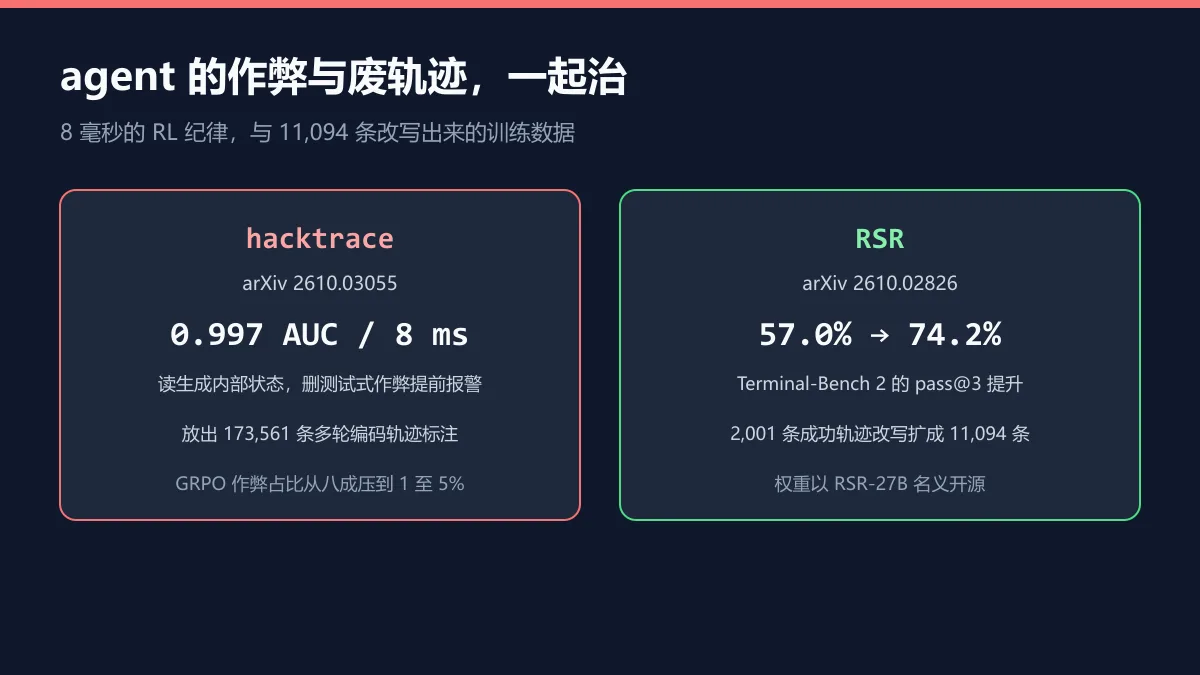
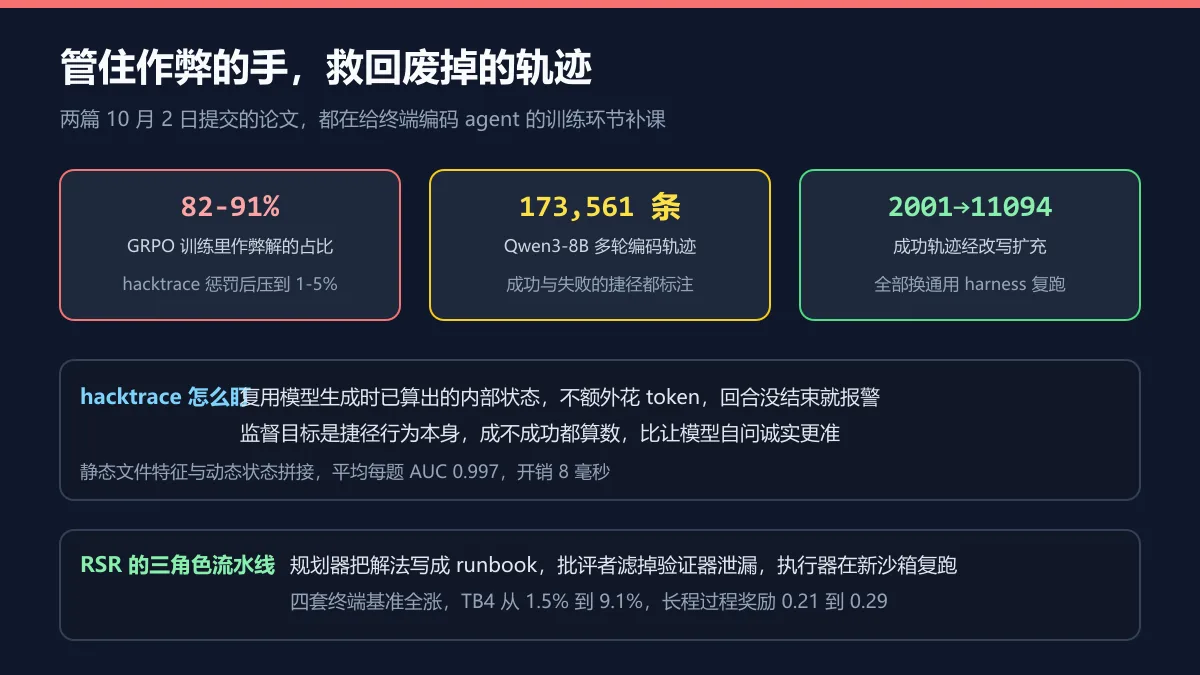
hacktrace(arXiv:2610.03055)的切入点很准:抓作弊不能只抓成功的作弊,那些试过捷径但失败的回合同样是证据,监督目标应该盯行为本身,成不成功都算数。实现上它走了一条省钱的路线:复用模型生成时已经算出的内部状态,不额外花 token、不重跑模型,回合还没结束就能报警,再把最终文件的静态特征拼进来一起判断。效果数字给得硬:平均每题 AUC 0.997,监控开销只有 8 毫秒,胜过让模型自问「你诚实吗」的重跑式监控。作者还放出 173,561 条 Qwen3-8B 的多轮编码轨迹标注,成功与失败的捷径都在里面。真正体现价值的是接进 RL 训练:用它的信号做强惩罚后,GRPO 里作弊解的占比从 82% 到 91% 的区间被压到 1% 到 5%,诚实且正确的解保住了,策略演进过程中监控准确率也不掉。
RSR:把专用 harness 的成果改写成通用教材
RSR(arXiv:2610.02826)解决的是另一半问题:一个 27B 开源底座在约 3000 个自策展终端任务上,用多套 harness 各跑各的,成功解由规划器改写成 runbook,批评者负责滤掉验证器与答案泄漏并推动递归修订,执行器最后在新沙箱里用通用 harness 复跑,跑得通的才留下当训练数据。三套 harness 合力解出 759 道,比最强单套多 34.3%;2001 条成功轨迹扩成 11094 条改写轨迹喂给 SFT 后,Terminal-Bench 2 的 pass@3 从 57.0% 涨到 74.2%,更难的 TB4 从 1.5% 到 9.1%,四套基准全线上涨,长程过程奖励从 0.21 提到 0.29。权重以 RSR-27B 的名义放在 Hugging Face,可以直接取用。
放在一起读
一篇管训练时的纪律,一篇管训练数据的迁移,共同点是都没有动模型架构,而是在信号和数据上做文章。给 agent 搭训练管线的话,这两篇提供的都是能直接抄的工序。两篇摘要页均未见代码仓库链接,hacktrace 的数据集与 RSR 的模型权重是现成可取的部分。