字节笔记本
2026年10月5日 · 约 14 分钟读完
环境式AI协作实战:一句话让AI完成20分钟跨仓迁移
AI 编程的理论文章满天飞:第二大脑、SkillOpt、AGENTS.md、loop engineering、Karpathy 的 LLM Wiki 等等。但这些理论放到真实的脏乱老代码库、跨多仓库、多轮重构、多人协作的工程现场,到底跑不跑得通?
一位工程师在论坛发帖,分享他用 GLM-5.2 在公司真实项目里跑了大半年的实战。读完让人眼前一亮:他不仅跑通了,还把这些理论缝合成了一个真实可用的系统。最惊人的是那句:一句「将旧组件迁移到重构后的新组件」,AI 在 20 分钟、3 轮上下文压缩后,100% 完成迁移,零人工介入。
这是怎么做到的?这篇文章就把这套「环境式」实践拆透。
一、核心思想:先建「环境」,再让 AI 放手干
这套实践最准确的概括,是「环境式 AI 协作」。
传统 AI 编程的姿势是:打开 Claude Code 或 Codex,喂给它一堆上下文(PRD、私域 skill 文档、代码库说明),然后让它干活。所有知识都要靠你「提前喂进去」。
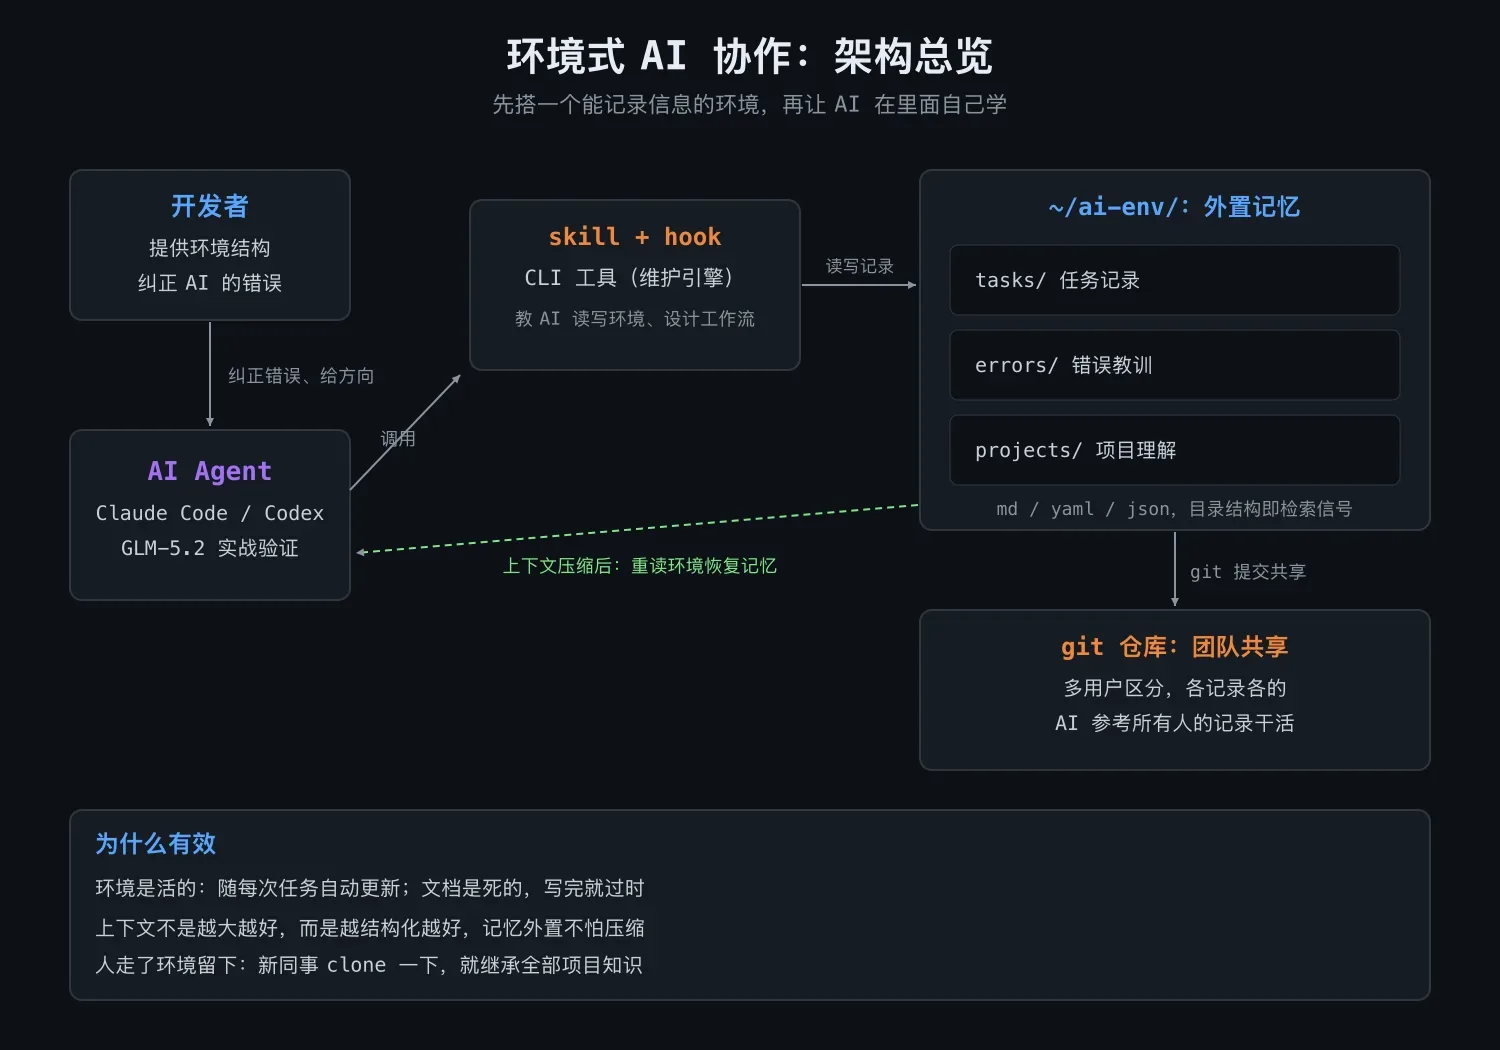
这位作者的姿势反过来:先搭一个让 AI 能记录信息的环境,然后让 AI 自己在里面学。
这个「环境」具体是什么?作者的原话是:
实际上就是个 cli 工具,再用 skill + hook 去教 AI 用这个 cli,以及设计工作流、记录机制。至于记录就是一堆有目录结构的 md、yaml、json 文件,放到了 ~/ 下的一个文件夹里。
翻译成大家熟悉的语言:这就是 Karpathy 说的「第二大脑」落进了真实工程工作流。那个 ~/ 下的文件夹,相当于 vault 的 raw/ 加 wiki/;CLI 工具就是维护引擎;skill + hook 就是教 AI 怎么读写它。
关键洞察是:不用提前喂私域知识,让 AI 在环境里自己学。人负责提供环境结构和纠正错误,AI 负责记录和学习。
二、试错学习法:让 AI 像新人一样「熬过来」
这套实践最反直觉的地方是:作者不追求「一次做对」,他追求「做错了一定要记录」。
刚开始,AI 肯定会错,人工介入得会很频繁……但哪怕只是改一行入参错误,也要在对话框中告诉 AI 原来为什么错,应该改成什么。环境会让 AI 能够记录这些信息。等 AI 熟悉项目后,就轻松了。
这本质上就是「带新人」的方法论,只不过这个新人是 AI。带一个真实的新人工程师,你不会第一天就甩给他完整文档让他全背下来,你会让他干活、犯错、纠正、记住。几周下来,他对项目的理解,比读十遍文档还深。作者对 AI 用的就是同一套。
这与 Anthropic 报告里「AI 不是完全委派,而是高度协作」的判断一致,也和 SkillOpt 这类「技能靠训练而不是手写」的思路同源:作者是用人工的方式,做了技能自训练用算法做的事,把每一次错误变成 AI 的经验。
而「环境」的作用,就是让这些经验不被下次会话的上下文压缩冲掉。这是它和普通 AI 编程的根本区别。
三、上下文压缩不再是问题
作者提了一个特别关键的实战发现:
不需要担心有限的上下文,subagent 也不必要,一旦触发压缩,让 AI 读取回环境中记录的任务、环境上下文即可,在环境信息足够的一次对话下,AI 经过多轮压缩后还能保持工作流,并完成任务。
这段话信息量极大。它正面回答了社区反复讨论的「context rot(上下文腐烂)」问题:当上下文被压缩时,AI 怎么不失忆?
答案是:环境外置记忆。
- 传统做法:把所有信息塞进上下文窗口,窗口一压缩就失忆。
- 环境式做法:只把当前任务相关的信息放进上下文,背景知识全存在环境文件里。压缩了?让 AI 重新读环境文件恢复上下文。
这就是 Karpathy 第二大脑里 log.md 思路的工程化版本:log.md 用 500 token 恢复 2000 到 3000 token 的上下文,而这套环境用一组 md/yaml/json 文件,让 AI 在 3 轮压缩后还能保持工作流。
一句话总结:上下文不是越大越好,而是越结构化越好。把记忆外置到结构化环境文件,比死撑一个大上下文窗口更有效。这是实战验证过的洞察。
四、那句「20 分钟 100% 完成迁移」是怎么做到的
作者给了一个具体例子,最能说明这套方法的威力:
任务提示词:「将当前旧组件 1.129.0 版本依赖的新提交,迁移至重构后的新组件」。 背景:重构了一个十多万代码的组件,拆成两个新组件,其中一个要被其它地方复用。所以 AI 一共要看 3 个独立项目仓库。 结果:仅一句话,AI 就在环境中找到了一切信息,然后花费 20 分钟,3 轮上下文压缩后,100% 完成了迁移,没有人工介入。
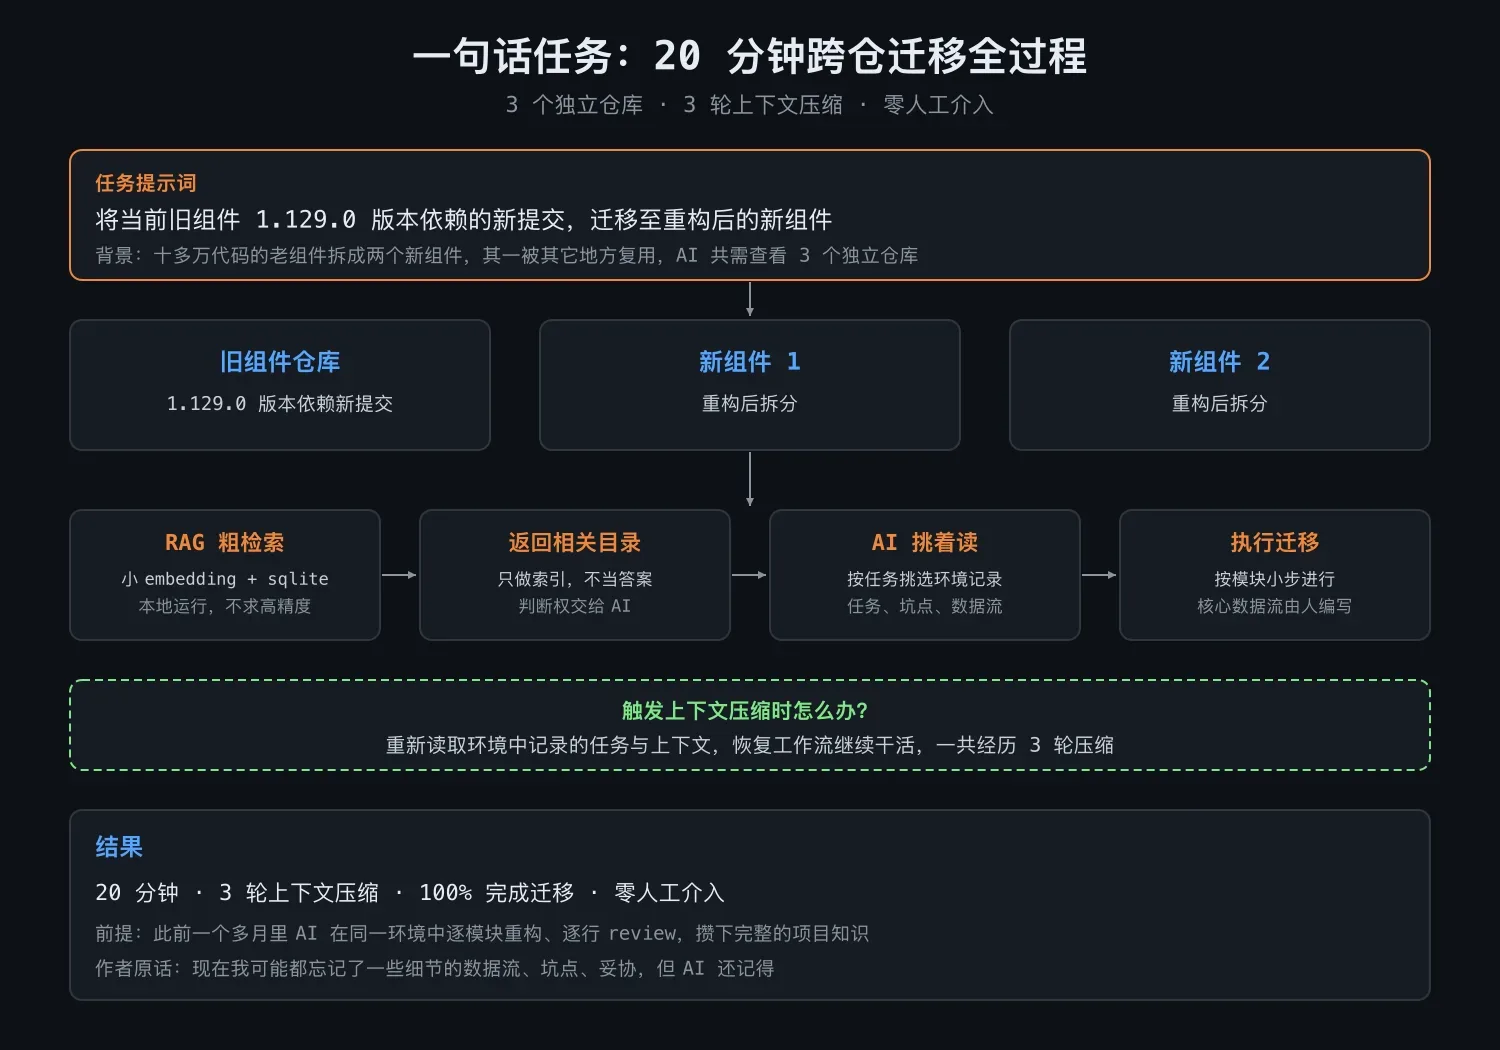
为什么一句话就能驱动这么复杂的跨仓迁移?因为 AI 在那个环境里已经「泡」了一个多月。
之前的重构任务花了一个月多,这一个月一直在环境中让 AI 完成任务……最开始我让 AI 直接按要求重构所有代码,效果很不好,业务逻辑一塌糊涂。后面根据各功能模块,逐个重构,核心数据流、架构古法编程,逐行 cr,跑通业务,指出问题。
这段复盘极其重要,它揭示了 AI 重构老代码的正确姿势。
错误姿势:直接甩给 AI「重写这个十万行组件」,结果业务逻辑全乱,只有目录结构像样。
正确姿势:
- 按功能模块逐个重构,小步实现,分阶段带门禁;
- 核心数据流、架构用「古法编程」,人写,不让 AI 瞎猜;
- 逐行 code review,看 diff,防止改到不该改的地方;
- 跑通业务、指出问题,让 AI 记录下来。
一个月下来,AI 累积了对这三个仓库的完整理解:数据流、坑点、历史妥协。所以一句「迁移」它能自己搞定。这不是 AI 突然变聪明了,是环境里攒了一个月的「项目知识复利」在爆发。
现在我可能都忘记了一些细节的数据流、坑点、妥协,但 AI 还记得,并偶尔在完成新任务时,发现问题。
这句话最戳人:AI 反而比作者更记得项目的细节了。这就是「环境式」相比传统文档的终极优势:环境是活的,文档是死的。文档写完就过时,环境随每次任务自动更新。
五、RAG 的克制用法
作者对 RAG 的处理很务实:
rag 是有用的,但不需要多高的准确度,用小的 Embedding 模型 + sqlite 本地跑,只是为了 AI 方便根据任务提示词,自己弄一些关键词去环境中搜记录、相关任务等等信息,搜出来一个目录,让 AI 挑着读去。
这套 RAG 不追求检索精度,只追求「让 AI 能找到相关文件的目录」。找到后让 AI 自己挑着读,把「判断什么相关」的决策权交给 AI,RAG 只做粗筛。这和「检索只提供线索,理解与组织交给模型」的思路一脉相承。
这种「RAG 当索引不当答案」的定位特别克制。很多团队花大力气调 RAG 精度,结果不如让 AI 在结构化环境里自己找。环境文件的目录结构本身就是一种「预检索」:文件名、目录层级、yaml 元数据都是信号。
六、多人协作:把环境提交成 git 仓库
最让人意外的设计:
把 ~/ 下那个文件夹提交成个 git 仓库,别人 clone 就行,做了多用户区分,所以各记录各的,给 AI 提供信息时,是参考所有用户的记录。
这个设计非常优雅。传统的「团队知识库」是搭个 Wiki、配个权限、定个模板、催大家填,结果是没人填,Wiki 永远过时。
这里的多人协作是:每个人正常用 AI 干活,环境文件自动记录,git 提交共享。每个人的错误教训、对项目的称呼习惯、踩过的坑,全在仓库里,AI 读所有人的记录。
这是「被动沉淀」对「主动维护」的胜利:不用催任何人写文档,文档自己长出来。这大概是对付「老代码、人走了、文档过时」这个软件工程世纪难题,目前最优雅的解法之一。
七、诚实的局限:为什么不生成 Wiki
作者有一段特别清醒的反思:
业务文档全在无数产品 prd 里,先辈的文档、流程图也只是冰山一角,很多和现存代码映射不上……靠 AI 自动生成 repo wiki 和业务逻辑也是两码事,还缺失了上下游组件链路的依赖理解,用不了。 所以,一开始就不想人工提前梳理出一堆文档,就是懒了,干看老代码太烧脑了。
这段话戳中了所有「AI 自动生成文档」幻想的痛点。很多团队指望把代码丢给 AI,让它生成 Wiki,但实战发现这行不通。因为:
- PRD 和现存代码对不上,文档早已过时;
- AI 生成的 Wiki 缺少上下游链路理解,孤立看一个仓库没有用;
- 老代码多年迭代,逻辑不忍直视,一行三年前的 todo 注释就能让人眉头一皱。
所以作者的选择是:不提前整理文档,让 AI 在干活中自己学。这是「自底向上」对「自顶向下」的胜利。与其花几个月梳理一份马上过时的文档,不如让 AI 直接干,干中学,学中记。
唯一的代价是 token。作者自己说这套跑下来 token 消耗量挺大,好在用的是公司内部资源额度。这是真实的成本,不藏着。
八、把这套实践放到方法论的坐标系里
这套实战,几乎是对近期社区主流 AI 工程方法的一次工程级验证:
| 方法 | 这套实践怎么落地 |
|---|---|
| Karpathy 第二大脑(raw 归你、wiki 归 AI) | ~/ 文件夹就是 vault,AI 自己记录维护 |
| SkillOpt(技能靠训练不是手写) | 让 AI 试错,每次错误都记录,环境就是训练集 |
| Claude Code 最佳实践(CLAUDE.md、context rot) | 环境外置记忆,解决上下文压缩失忆 |
| Codex 橙皮书六步法(小步实现、逐行 CR) | 重构不是一次甩给 AI,是逐模块加逐行 review |
| AGENTS.md 与各类记忆系统 | hook + skill + CLI 就是记忆系统的真实形态 |
| 社区的 agentfs、brain.md 记忆文件实践 | 环境目录就是这类构想跑在生产里的样子 |
| Loop Engineering(persistence) | 每次任务的经验被持久化,复利增长 |
作者不是在套用某个理论,而是抓住了所有这些方法的共同内核:让 AI 在结构化环境里自主学习和记忆,然后用一个 CLI、一组文件加 git 跑通了。而且跑在真实的、脏乱的、跨仓库的、多人协作的工程现场。这比任何 demo 都有说服力。
九、给想试的人的路径
作者没有放出工具(内部项目),但思路完全可复制。如果你想搭一套类似的环境:
最小可行版本:
- 建一个
~/ai-env/目录; - 里面放
tasks/(任务记录)、errors/(错误教训)、projects/(项目理解)几个子目录; - 写一个简单的 CLI(或者直接用 Claude Code、Codex 的 skill 和 hook),让 AI 能往里读写;
- 干活时,让 AI 把每个任务、每个错误、每个项目结构记进对应文件;
- 新会话开始,让 AI 先读环境恢复上下文。
进阶:
- 加一个本地 RAG(小 embedding 模型加 sqlite)做粗检索;
- 提交 git,团队共享;
- 设计工作流模板:任务、执行、验证、记录、复盘。
也可以直接参考公开的同方向实践:Karpathy 公开过的 LLM Wiki 模板、SkillOpt 的技能自训练方案,都是同一个思路的不同实现。
十、结语:软件工程世纪难题的一种解
一句话概括这套「环境式 AI 协作」:先建一个让 AI 能记录错误、任务、项目信息的环境(CLI 加文件加 git),让 AI 在试错中学习,把每次经验外置到环境文件。一个月下来,AI 比你更懂项目的细节。
这套实践最深刻的意义,不在于「AI 能干迁移任务」,而在于它给「老代码、人走了、文档过时」这个软件工程世纪难题,提供了一种现实解。
传统解法是「补文档」,但文档永远补不全、永远过时。这套解法是让 AI 在干活中自己长出理解:不补文档,补一个会自我更新的「项目大脑」。
而且这个大脑是多人的、git 化的、跨仓库的。人走了,大脑留下。下一个接手的人(或 AI),clone 一下就能继承全部项目知识。
这大概就是 AI 时代「项目知识传承」该有的样子:不是写文档,是养环境。
作者最后说,想看看这种实践方向对不对,有没有更好用的。我们的回答是:方向对了,这正是 2026 年 AI 工程的主流方向之一。你不是在追赶理论,你是在用实战证明理论。
本文整理自一位工程师在论坛分享的个人工作实践,所用工具为公司内部项目,未开源。文中方法论可直接复用,也可以结合 Karpathy 的第二大脑、SkillOpt、Claude Code 最佳实践、Codex 橙皮书等公开资料对照阅读。
如果你也在用类似的环境式协作,或者想讨论改进方向,欢迎留言,这套实践值得被更多人验证和迭代。