字节笔记本
2026年10月9日 · 约 3 分钟读完
方言一开口,凭什么十六亿参数能压过旧榜首
阿拉伯语语音识别常被英语模型顺手带过,方言一开口,词错率就回到二十出头。技术创新研究所在 2026-10-07 的博文 Introducing Falcon ASR 里放出 16 亿参数的 Falcon-ASR,主攻阿拉伯语,尤其是阿联酋方言,同一套权重也覆盖英语、法语、西班牙语和葡萄牙语,不靠语言开关。底座写成 Falcon3-Audio。演示空间最长 60 秒,支持词级时间戳。接口和应用还在规划。
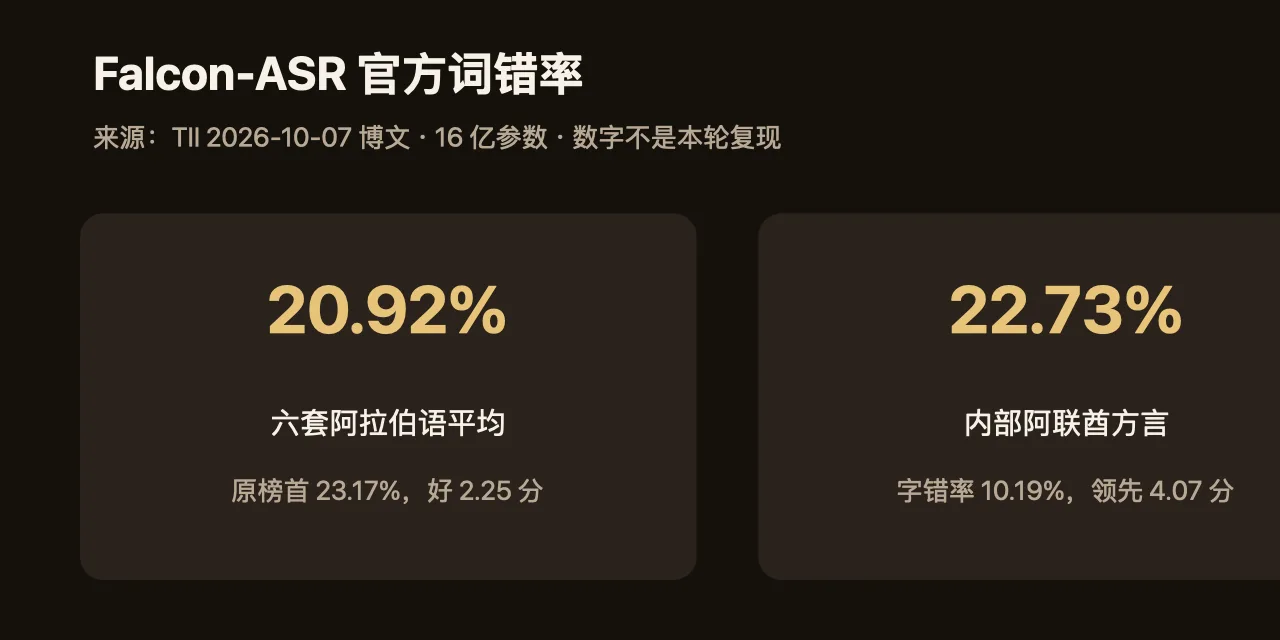
官方六套阿拉伯语平均词错率 20.92%,原公开榜首 23.17%,好 2.25 个百分点。内部阿联酋方言词错率 22.73%、字错率 10.19%,比下一档好 4.07 个百分点。英语公开集平均 5.74%。训练写了噪声、重叠、电话和方言混杂。对照模型博文点了另一家全模态系统。论文号 2509.07526,检查点日期写成 2026-09-30。这些是官方口径,不是本轮复现。
演示能听,许可证本轮没核到
演示在公开空间,片段最长一分钟。博文还链到通用阿拉伯语识别榜和相关方言模型介绍。本轮直接打开模型卡返回未授权,所以不写仓库星数,也不写可商用。若只是要听一段方言转写,先走演示空间。若要接到生产流水线,等接口和应用,并自己核许可证和权重页。
读这篇记住三组数:阿拉伯语平均 20.92%,阿联酋方言 22.73%,英语 5.74%。别把它写成已经能替换英语为主的识别接口。方言和电话噪声是它的主场,英语分数只是同权重附带。站点主线仍是工具和开源,这篇只把官方分数钉死,方便后面对照开源识别栈。
博文把训练场景写成噪声、重叠、电话信道和多种方言混在一起,不是干净演播室。六套阿拉伯语测试和七套英语测试是分开报的,不要把 5.74% 的英语平均拿去解释方言能力。阿联酋方言那组是内部数据,字错率 10.19%,词错率 22.73%,领先幅度 4.07 个百分点,对照的是博文里的下一档系统,不是你本机的开源识别器。
相关页面还包括通用阿拉伯语识别榜、卡萨布兰卡数据集和方言大模型介绍。论文 2509.07526 写的是单阶段公开数据训练。270M 和更早的条目是对照家族里的小模型,不是这颗 16 亿的替代品。演示空间目前点赞是零,只能说明它还新,不能说明不好用。若要把词级时间戳接到字幕流水线,先在 60 秒上限里看时间轴准不准,再谈更长的录音。
本轮不写安装命令,因为权重页未授权,许可证也不清楚。能写进稿子的只有博文分数、演示时长和语言清单。后面如果模型卡公开,再补仓库、许可和调用示例。现在把三组数钉在值班笔记里就够:20.92%、22.73%、5.74%。