字节笔记本
2026年10月5日 · 约 2 分钟读完
未来的需要,决定该记住哪一帧
长视频生成有两个老毛病:历史越攒越多算不动,模型对物理世界的理解又没人能量。Hugging Face 今日论文榜的前两名恰好各治一个,组合着读很有意思。
FrameMorrow:按未来需要选历史帧
Bo Yin 等人的 FrameMorrow(arXiv:2609.38839)处理长时程视频生成的上下文问题。常见做法是按与当前内容的相似度挑历史,作者的观点恰恰相反:历史该按与未来需要的相关度入选。方法分两步,先预测一小撮前瞻 token,代表接下来生成要用的信息;再按这些需要挑选相关的历史帧。
关键设计在选的是显式帧而不是模型内部状态,于是它可以即插即用地挂到不同生成器上,闭源的也行,额外推理开销很小。五个基准加 11 个生成模型(长视频、交互式、动作条件世界模型)的验证里,长程一致性、视觉质量、动作对齐三线都有增益。论文页未见代码链接。
World Embedding Benchmark:给世界理解配把尺子
Yiqi Liu 等 11 位作者的 WEB(arXiv:2610.03632)造了 8000 例受控仿真场景,覆盖流体、固体力学、动力学与光电等 80 个物理族,每例配渲染视频与物理标注。基准支持三项任务:文本视频检索、物理属性回归、多选描述分类,分别考跨模态对齐与定量物理信息的恢复。
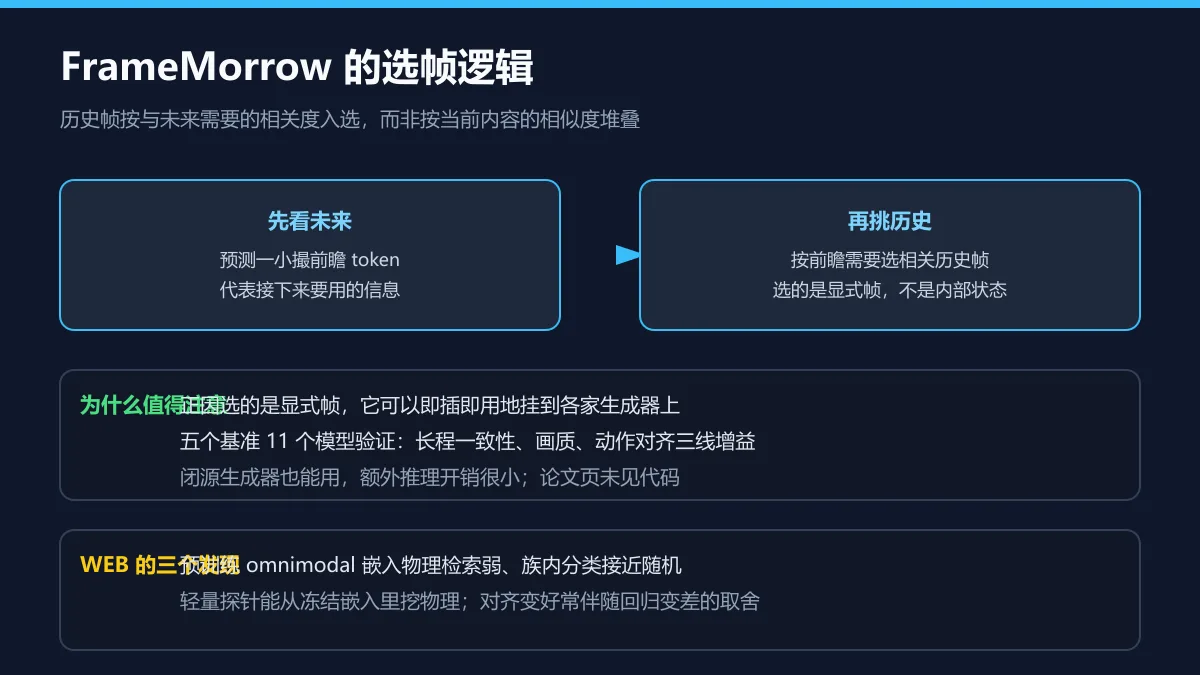
三个发现值得记。第一,预训练的 omnimodal 嵌入模型物理检索很弱,族内分类接近随机猜。第二,轻量探针能从冻结的嵌入里挖出有用的物理信息,说明信息在但没对齐。第三,用物理配对做对比训练能提升检索却伤害回归,对齐与可恢复性存在取舍。还有个实用彩蛋:拿嵌入去检索参考视频做检索增强生成,MiniMax-H3 生成视频的物理保真度会变好。该篇同样未见代码链接。
放在一起读
一个让生成器记得聪明,一个让我们量得清楚。视频这条线在站内已经从工具侧写到模型侧,这两篇补上了方法与评测两块地基;嵌入里藏着但没对齐的物理知识,也呼应了此前 harness 系列的结论:能力常在,缺的是把它请出来的结构。