字节笔记本
2026年10月5日 · 约 2 分钟读完
出题出到 agent 只剩五成胜率:两篇新论文
arXiv 周一批次放榜,两篇 10 月 2 日提交的新论文都把「难度」这件事做到了极致:一份给浏览器 agent 出了套防漏题的硬卷子,一份让出题的 harness 自己进化到 solver 只剩五成胜率。
HyperBrowseComp:浏览器 agent 的多语多模压力测试
来自 Alham Fikri Aji 等人的 HyperBrowseComp(arXiv:2610.03574)收录 423 道全部人工撰写并人工校验的题目,横跨 13 种语言,由母语或高熟练度作者执笔。题目刻意做得很难:答案要求简短且公开可验证,但证据藏在冷门角落,需要多步线索链,甚至要查视频、扫描件、图片或地图。
防漏题的设计很讲究:先用没有联网能力的模型预筛,删掉靠参数记忆就能答出的题目,确保考的是真实的信息检索能力。评测把厂商原生搜索与共享的外部检索 harness 放进同一 agent 协议对比,并抽样做了人工评测来锚定难度。做浏览器 agent 或搜索产品的团队,这套卷子是现成的验收标准。未附代码链接。
Recursive Harness Self-Improvement:让出题器自己进化
另一篇(arXiv:2610.03548,Wenlong Zhang 等)处理合成训练数据的老问题:任务级递归会让出题 harness 停在原地。作者提出任务与 harness 共同进化:生成进行中,求解器的失败被在线转成可复用技能;每批结束后,技能、提示词与工作流再做批后修订,只有在成本上限内产出更难且合法任务的候选才会被接受。模型权重与验证标准全程冻结,进化的只有 harness。
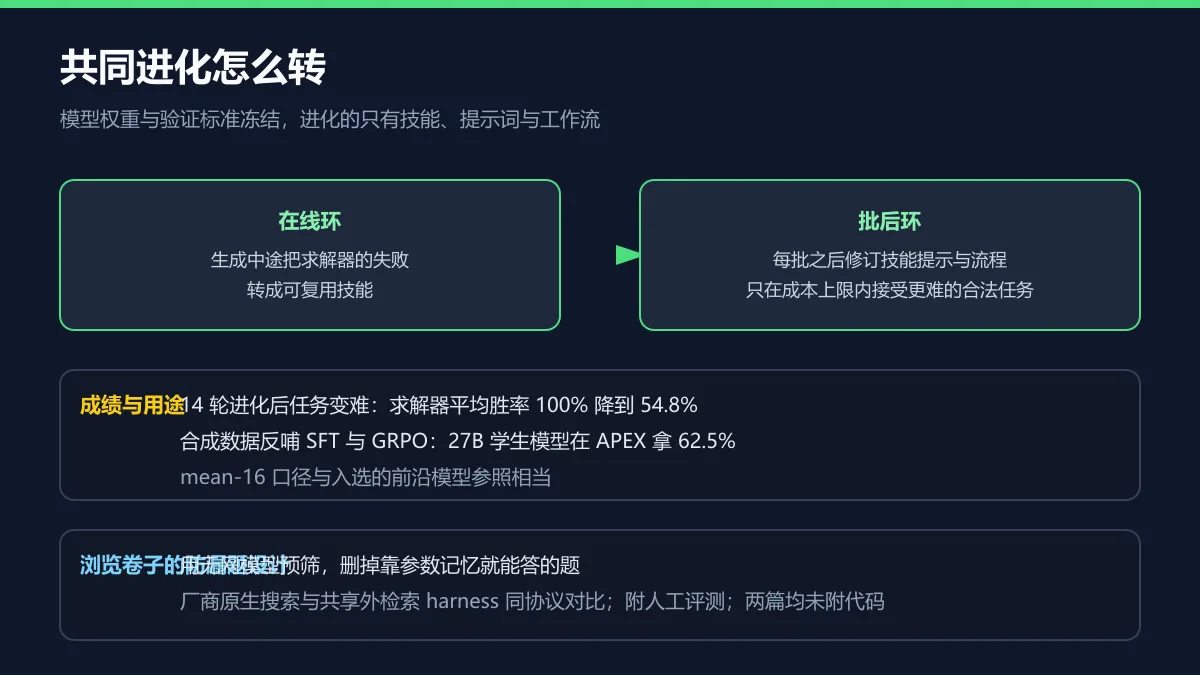
数字直观体现了「变难」:14 轮进化后,求解器平均胜率从 100% 降到 54.8%。这些合成数据反哺 SFT 与 GRPO 训练都有增益,27B 的学生模型只用 1 万条合成数学样本微调,就在 APEX 上拿到 62.5% 的 mean-16 成绩,与入选的前沿模型参照相当。该篇同样未见代码链接。
放在一起读
一篇定义了 agent 检索能力的验收线,一篇把训练数据的质量边界往外推。与本周写过的 harness 系列连起来看,外围工程的进化速度已经明显快于模型本身,这个判断的证据链又厚了一层。