字节笔记本
2026年10月5日 · 约 2 分钟读完
agent 会查文献吗?会种地吗?两篇论文都试了
agent 在聊天框里已经很强,真放到专业工作流里成色如何?10 月 1 日的两篇 arXiv 论文分别在科研情报与农业物理控制两个垂直场景做了实测,一盆冷水一个样板,都很有信息量。
ScholarCatalyst:科研灵感检索,agent 暂时不及格
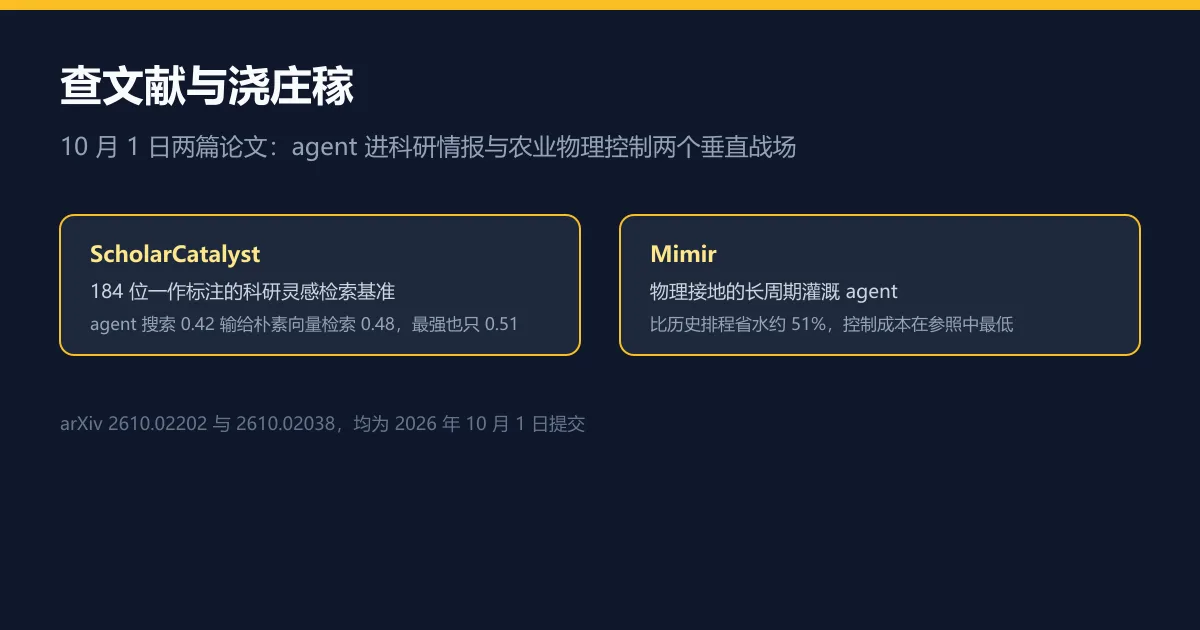
做研究最贵的直觉之一,是知道该读谁的论文。ScholarCatalyst(arXiv:2610.02202,14 位作者)把这件事做成了基准:请 207 篇近期计算机论文的 184 位一作,标注哪些候选论文推动或本可以推动自己的项目并给出理由,任务设定为在项目启动时的文献范围内把这些论文检索出来。
结果给 agent 热泼了冷水:agent 式搜索的 Recall@20 只有 0.42,反而不如朴素的嵌入检索 0.48;最强的 agent(Claude Fable 5.1)也只做到 0.51。把半成型的想法连接到该读的先行研究,这种专家级检索直觉目前还不存在,作者据此呼吁新的训练方法。对做文献综述工具的团队,这个基准值得盯。
Mimir:把物理交给物理,把语义交给模型
Mimir(arXiv:2610.02038)挑的是另一极端:长周期物理控制。大多数 agent 研究是短回合任务,而灌溉是每天的决定与土壤水分动态相互作用、误差跨生长季累积、安全规则不许改写的世界。
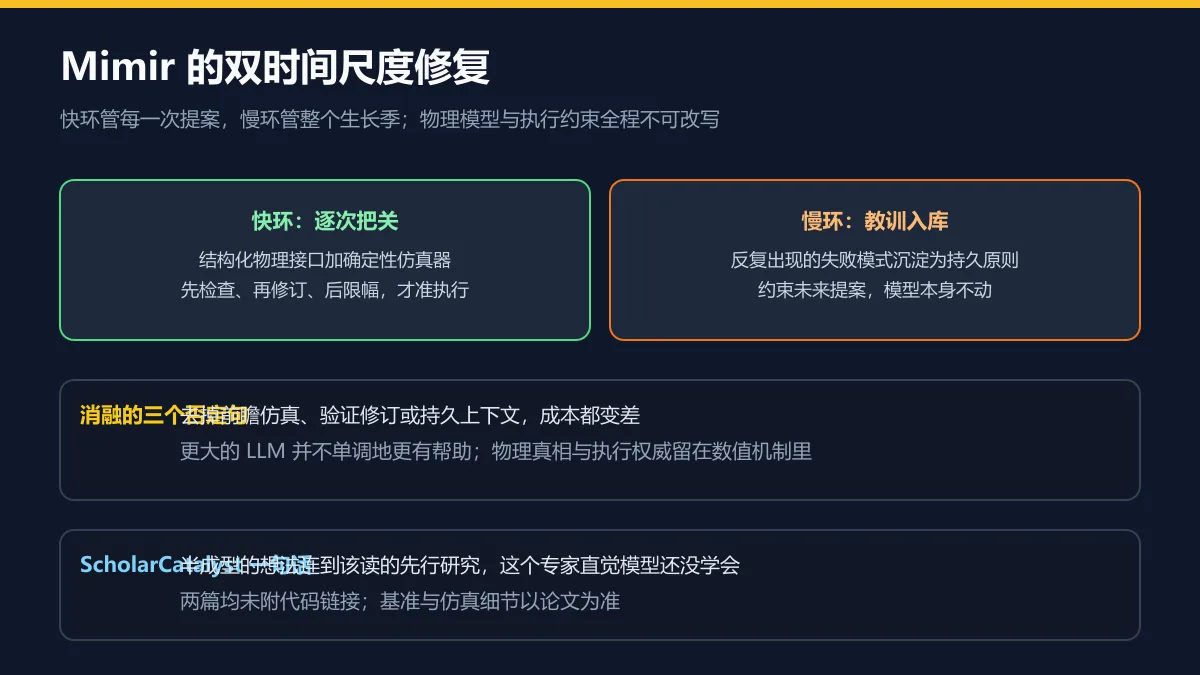
Mimir 的架构是双时间尺度修复。快环:LLM 的每次灌溉提案先过结构化物理接口与确定性仿真器,检查、修订、限幅之后才允许执行。慢环:反复出现的失败模式被沉淀为持久原则,约束未来的提案,而物理模型与执行约束全程不可改写。跨站点、作物与年份的回溯评估里,Mimir 拿到参照中最低的聚合控制成本,灌溉用水比历史排程回放少约 51%。消融实验的三个否定句更有价值:去掉前瞻仿真、验证修订或持久上下文,成本都会变差;更大的 LLM 也并不单调地更有帮助。一句话总结:物理真相与执行权威留在数值机制里,语义推理只做提案。
放在一起读
一篇证明 agent 在知识检索上还差专家直觉,一篇证明物理控制里模型加机制分工就能打赢历史基线。同一个星期的两份样本,恰好框出了当前 agent 落地的真实边界:语义强的交给模型,讲究证据与安全的交给确定性机制。两篇均未附代码链接。