字节笔记本
2026年10月5日 · 约 6 分钟读完
GLM 像严谨工程师,Opus 像创意画家:双模型组合用法
同一个需求,交给不同的模型,产出质量可能天差地别。一位海外资深开发者最近分享了一个关于 GLM-5.2 的精妙观察:GLM 的思维方式像一位极度严谨的工程师,黑白分明、精度极高;而 Opus/Fable 则像一位擅长铺色的画家,习惯在信息不全的地方补全语义。
这不是贬低任何一个模型,而是对模型认知风格的精准刻画。理解每个模型"怎么想",才能把它放到工作流的正确位置上。
一、两个模型的性格差异
GLM-5.2:黑白思维,高精度
这位开发者的大意是:GLM 系列模型非常出色,但思维黑白分明、追求高精度,像一位严谨刻板的工程师。
落到日常使用上,可以总结出三个特点:
- 黑白思维:给它什么就做什么,不会自作主张脑补细节;
- 高精度:只要指令明确,产出就精确、严谨、边界清晰;
- 依赖充分输入:提示词写得越充分,表现越惊艳;信息不足时,效果就比较平淡。
Opus/Fable:色彩画家,擅长脑补
对 Opus/Fable,他的描述是:这类模型擅长"铺颜色",即使提示词的规格不够细,也能自行补全语义的空白。
它们的性格几乎相反:
- 擅长填补空白:需求描述残缺,也能脑补出合理方案;
- 灵活:面对模糊需求,照样能给出像样的结果;
- 有创意感:产出更有人味,不像从模板里套出来的。
二、最佳组合:一个磨提示词,一个做执行
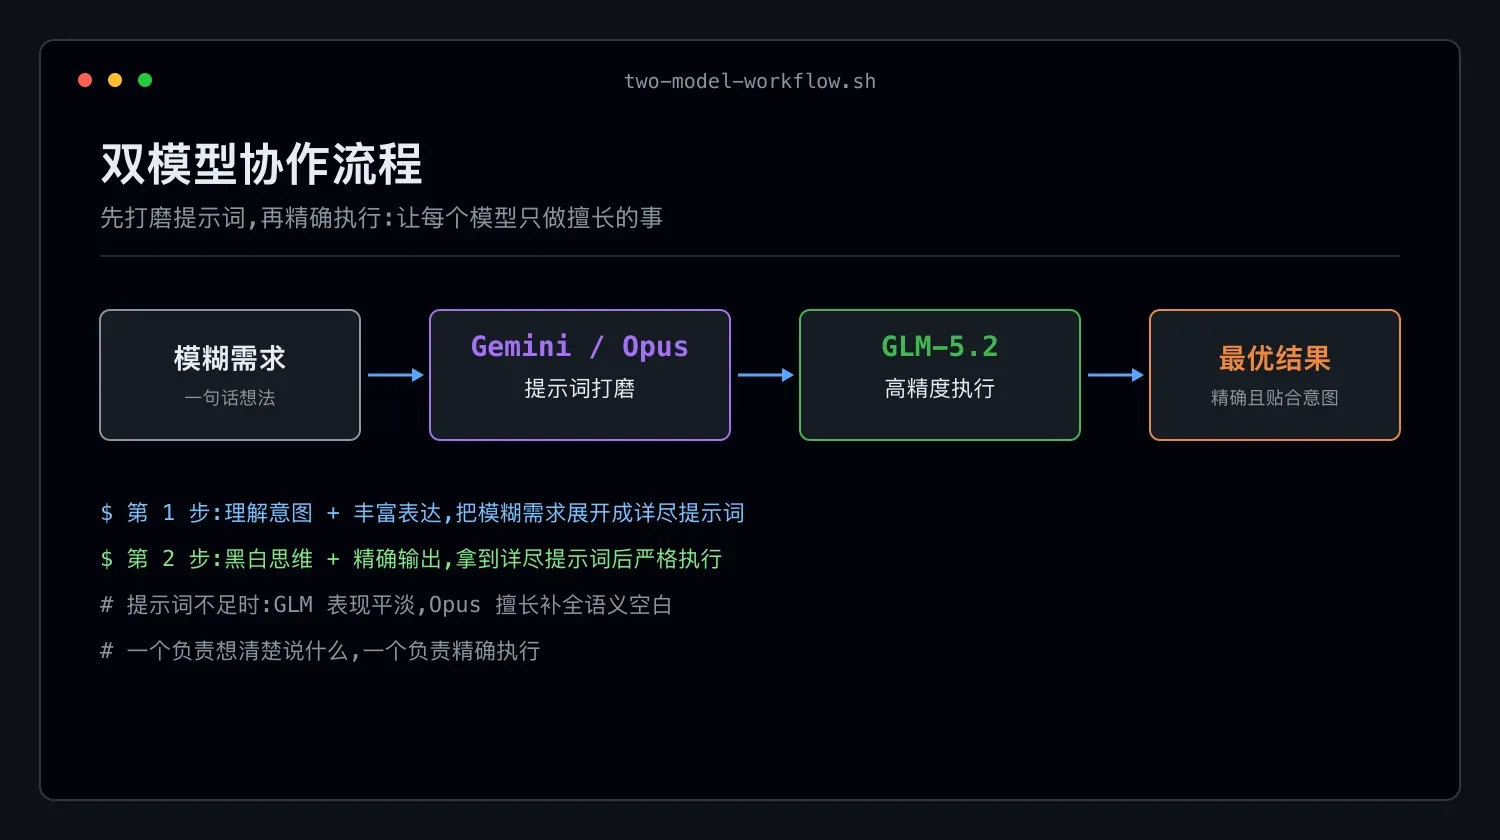
理解了性格差异,组合用法就顺理成章:让每个模型只做擅长的事。先用 Gemini(或 Opus)这类擅长理解意图、表达丰富的模型,把模糊需求展开成详尽的提示词;再交给 GLM-5.2 高精度执行。
一句话概括:一个负责"想清楚说什么",一个负责"精确执行"。
三、这个观察为什么重要
不同模型有不同的认知风格
它揭示的本质不是"A 比 B 强",而是不同模型有不同的认知风格:
| 维度 | GLM-5.2 | Opus/Fable |
|---|---|---|
| 思维方式 | 黑白、精确 | 发散、灵活 |
| 面对模糊需求 | 容易困惑 | 能脑补 |
| 面对明确需求 | 极其精确 | 可能过度发挥 |
| 最佳角色 | 执行者 | 创意与规划 |
| 提示词要求 | 必须充分 | 能适应不足 |
这套思路并不孤立
类似的多模型分工,在业界已有不少落地形态:
- 常见的模型选型建议里,"简单编码任务交给 GLM"的理由正是:指令明确时,高精度模型优势最大;
- 多模型编排工具(例如 Pi 这类路由型框架)的核心逻辑,就是按任务特征挑选模型;
- 开源 agent 框架 agents-go 提供的 RouterProvider,可以按请求路径把规划类请求与执行类请求分发给不同模型;
- Loop Engineering 中"生成器与评估器分离"的实践,同样建议两个角色使用不同模型;
- 多 Agent 团队的常见配置,也是给不同角色的 Agent 配备不同风格的模型。
更进一步:Amp 的 Oracle 模式
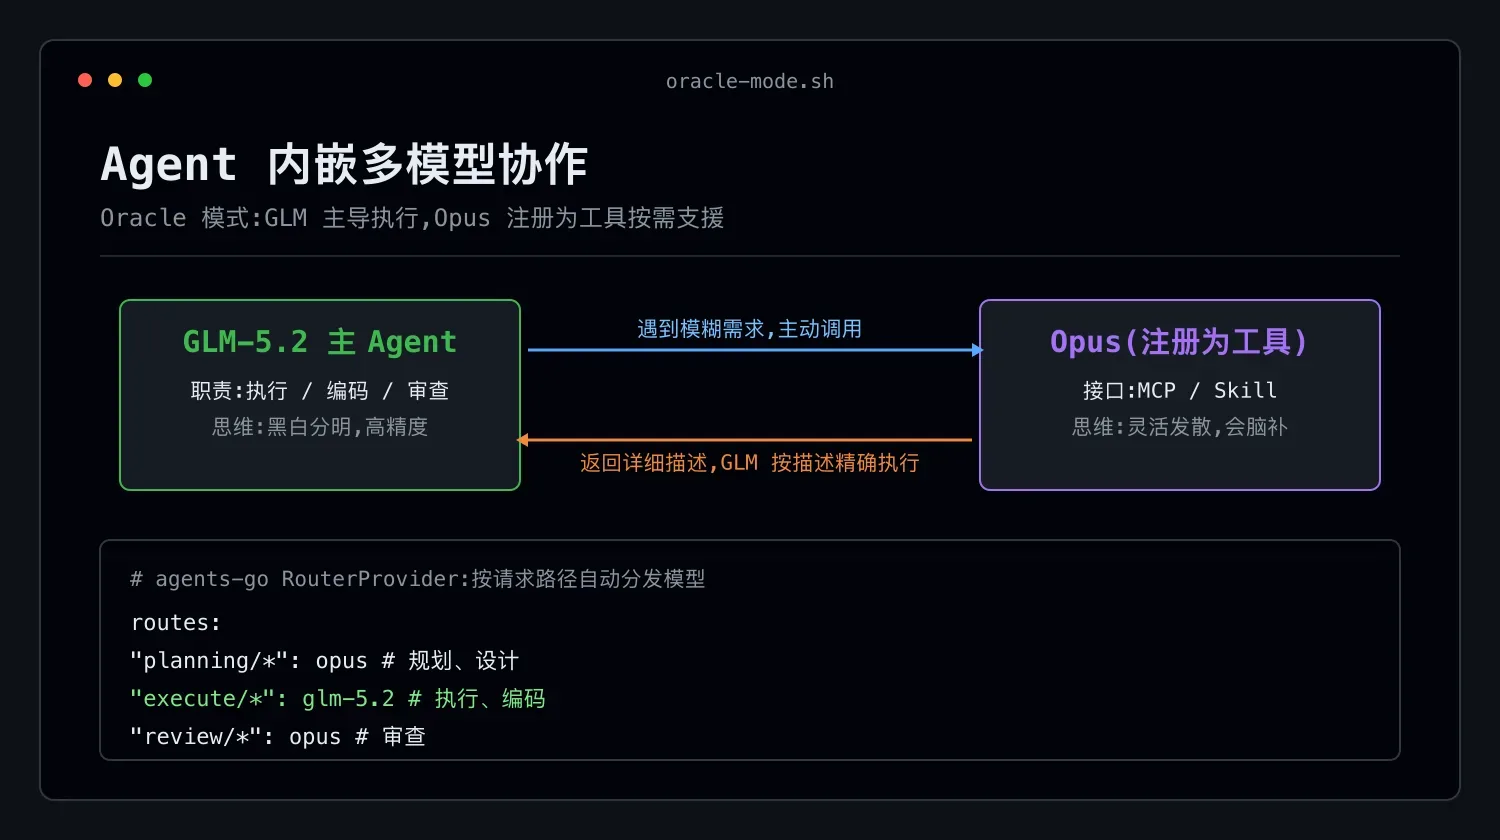
这位开发者还特别提到 Amp 的 Oracle 模式:把另一个模型注册成工具,让 GLM 在需要时主动调用。
这比"两步走"更彻底:不再是人手动切换模型,而是 GLM 自己判断"这个任务我需要 Opus 帮忙",然后把 Opus 当工具调用。这就是 Agent 内部的多模型协作,相当于一个 Agent 的大脑里住着两个风格互补的模型。
四、实操建议
简单版:手动两步
1. 你有一个模糊需求:"帮我做一个登录页面"
2. 先问 Gemini/Opus:"把这个需求展开成一份详细的开发规范"
   → 产出详细提示词(设计规范 + 技术栈 + 组件结构)
3. 把详细提示词交给 GLM-5.2 执行
   → GLM 高精度输出代码
进阶版:Agent 内嵌
1. GLM-5.2 作为主 Agent
2. 把 Opus 注册为工具(MCP 或 Skill)
3. GLM 遇到模糊需求时自动调用:"帮我细化这个需求"
4. Opus 返回详细描述
5. GLM 按详细描述执行
自动化版:路由分发
用 agents-go 的 RouterProvider,按路径把请求路由给合适的模型:
routes:
  "planning/*": opus     # 规划、设计
  "execute/*": glm-5.2   # 执行、编码
  "review/*": opus       # 审查
五、给开发者的核心认知
没有一个模型在所有维度都最优。真正的高手不是找到"最强的模型",而是理解每个模型的性格,让它们各做擅长的事。
| 如果你的需求是 | 用谁 |
|---|---|
| 需求明确,要精确 | GLM-5.2(黑白思维 + 高精度) |
| 需求模糊,要创意 | Opus(色彩画家 + 会脑补) |
| 拿不准 | 先用 Gemini 磨提示词,再让 GLM 执行 |
下次模型输出不符合预期时,不妨先检查两件事:提示词是否足够充分,以及这个模型是否被放在了适合它性格的位置上。
本文关于模型性格的观察整理自海外开发者在社交平台上的公开讨论,组合用法与实操建议由本站编辑整理补充。