字节笔记本
2026年10月8日 · 约 3 分钟读完
别让 agent 猜 API 用法:谷歌把官方文档做成 API
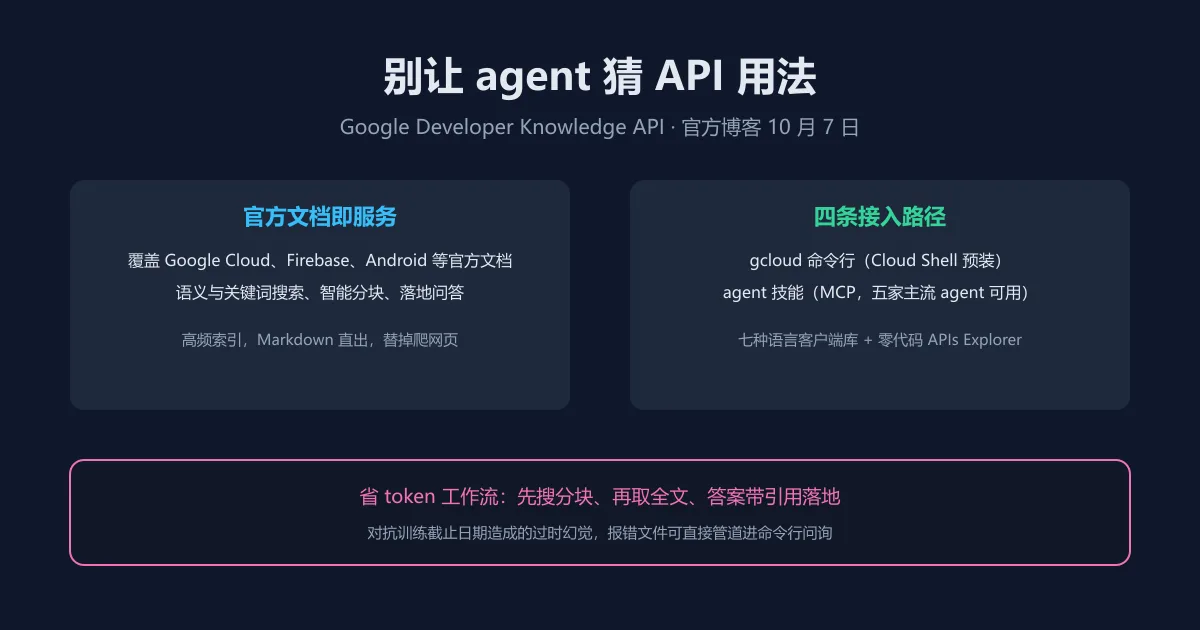
agent 写代码时最不可靠的一环,是对平台 API 用法的凭记忆发挥:训练截止日期一过,文档早就改版,agent 却还在熟练地背旧答案。谷歌 10 月 7 日在官方开发者博客放出的 Developer Knowledge API 生态,把这件事从根上解决:官方文档不再是给人看的网页,而是给 agent 用的结构化服务,官方口径的程序化事实来源。
四条接入路径
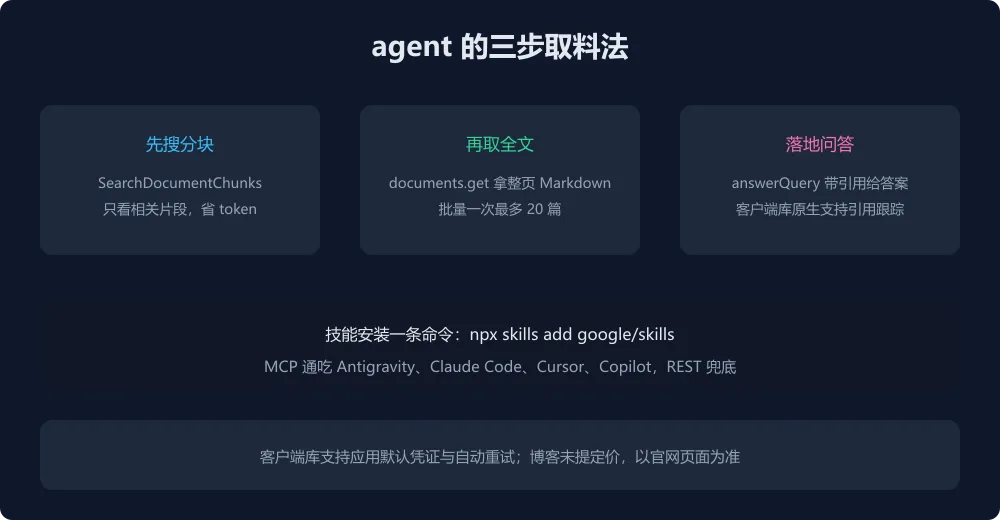
覆盖 Google Cloud、Firebase、Android 等产品文档,语义与关键词搜索、智能分块、落地问答齐备,高频索引保证文档随官方更新保持新鲜。接入方式按场景分四路:gcloud 命令行(Cloud Shell 里预装,answer-query、documents search-chunks、documents describe 等命令,报错文件可以直接管道进去问询);agent 技能(npx skills add google/skills 一条命令装好,MCP 协议通吃 Antigravity、Claude Code、Cursor、GitHub Copilot 与自定义 agent,不走的还有 REST 兜底);七种语言的客户端库(C#、Go、Java、Node.js、Python 等,支持应用默认凭证、自动重试与引用跟踪,批量取文档一次最多 20 篇);以及零代码的 APIs Explorer 交互测试界面,先试通再写代码。
省 token 的三步取料法
官方推荐的工作流为省 token 而设计:先用 SearchDocumentChunks 看相关分块,确认值得读再 documents.get 取整页 Markdown 原文,最后需要直接答案时用 answerQuery 拿带引用的落地问答。这个顺序把上下文开销压在分块层,全文只在必要时进上下文,引用跟踪则让每句回答都能回溯到官方文档的具体位置。对被训练截止日期坑过的团队,这套带引用的问答就是过时幻觉的解药。
怎么看这一步
这是官方文档 agent 化的标志性一枪:厂商不再满足于把文档挂上网等人爬,而是亲自提供机器友好的供给口,爬虫解析的不稳定、页面改版的断裂、更新的滞后,在这条通道里一次清零。把它与本月初的 Stack Overflow 开发者调查并读很有意思:48% 的开发者只在能轻松验证答案时才信任 AI,官方源加引用跟踪恰好就是那 48% 想要的可验证性,谁先给 agent 铺好这条可信供给线,谁的工具链就会被 agent 优先使用,这在 agent 自动选型的场景里就是直接的市场份额。其他厂商大概率会跟:Azure、AWS、苹果的文档体系都有同样的爬取痛点,跟进只是时间问题。定价与配额博客未提,动手前先看官网页面的口径;给 agent 做工具接管的团队,今天就可以把这个技能装上,把平台文档的取用从抓网页切到走 API,报错直接管道进命令行问询这一手,值回安装成本。