字节笔记本
2026年11月3日 · 约 4 分钟读完
GPT-6 Astra 直接改写权重,6 倍提升先别急着信
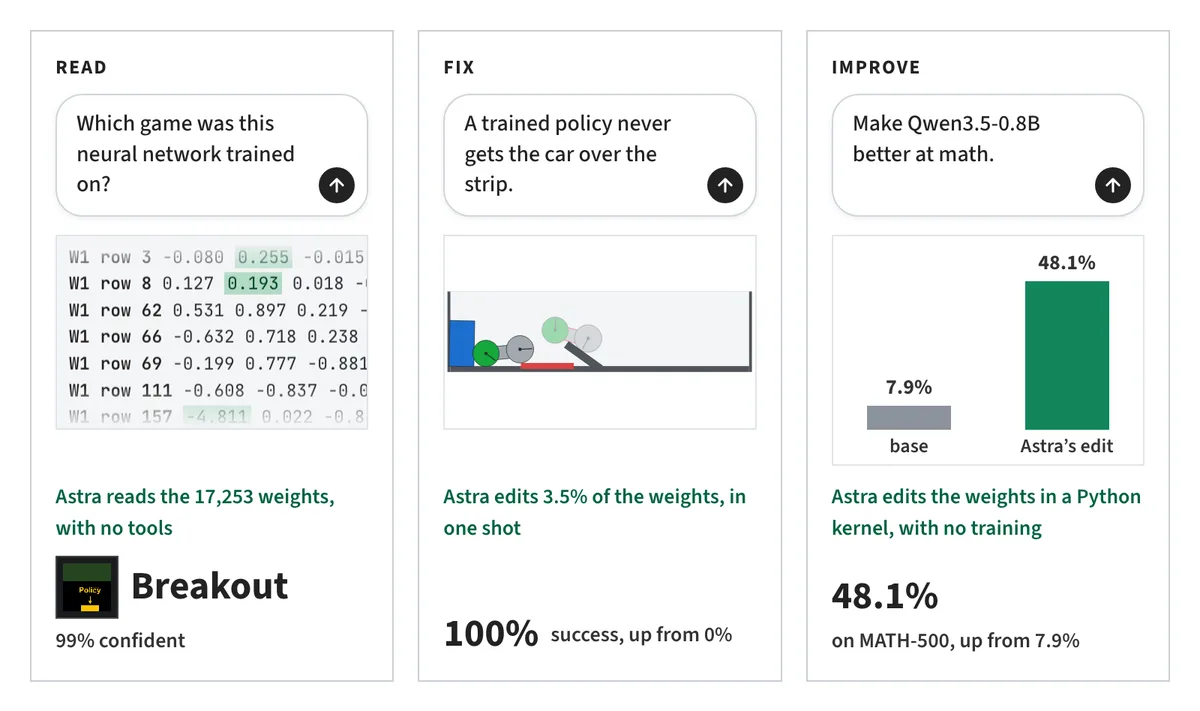
GPT-6 Astra 直接改写另一个神经网络的权重,把 Qwen3.5-0.8B 的 MATH-500 成绩从 7.9% 提到 48.1%,「6 倍」的说法就是这么来的。这篇先把这个结果讲清楚,再泼该泼的冷水。出处是 11 月 2 日的博客《Sparks of Weight-Space Programming: LLMs can natively read & write neural network weights》,作者 Rikiya Takehi 和 Jayden Teoh 为共同一作,另有 Alex Zhang 与 Omar Khattab,来自 MIT CSAIL。注意:这是博客文章,不是同行评审论文;实验日志全文公开在 GitHub(RikiyaT/lm_understand-logs),Hugging Face 上已有第三方按日志重建模型、做哈希校验并重跑评估。热度佐证:Hacker News 一天 1857 points 登顶。
一、主张:读写权重,不走训练循环
核心主张一句话:前沿大模型(文中用 GPT-6 Astra)可以直接读写另一个神经网络的原始权重,不用梯度下降、不跑训练循环,靠推理判断每一部分权重在算什么,然后手工改写。博客共 8 个实验,分三类:读权重、修权重、从零写权重。主实验是修 Qwen3.5-0.8B,数字如下,全部与原文核对过:MATH-500 从 7.9% 到 48.1%(约 6.1 倍);GSM8K 从 13.8% 到 67.1%;IFEval 从 21.0% 到 62.3%(约 3 倍);因撞 32768 token 上限而没有答案的比例从 93.0% 降到 33.1%。实际改动 131,072 个权重,占总量 0.016%,位置在第 15/19 层 MLP 的 down_proj,64 个输出列里减去同一个「导致循环的方向」。
二、流程五步:沙盒、试错、诊断、补丁、泛化
做法是构造性的。第一步,Python 沙盒里直接读写权重张量,明确禁止训练循环和梯度;第二步,给它试错预算,练习题来自 GSM8K 和 MATH 的训练集;第三步,诊断出这个模型的通病是 thinking loop,96 道题里 85 道烧穿 token 上限也没给出答案;第四步,打补丁,删掉导致循环的方向向量;第五步,泛化验证,IFEval 没有做过针对性优化,也从 21.0% 涨到 62.3%。
三、预算敏感:一次成功并不存在
第三个必须知道的数字组:改权的效率强依赖试错预算。10 次 forward pass 只能把 MATH-500 提到 12.3%,25 次到 14.1%,50 次才到 48.1%。所谓「不用训练直接改对」,是多轮试错收敛出来的,不存在一次性手写成功的故事。
四、冷水六点
第一,7.9% 的基线异常低,「6 倍」很大程度上是把「答不出」修成「答得出」,含金量要打折看。第二,作者自己在博客里承认,这是「移除障碍」而不是「增加能力」,对照组 Gemma 3 270M 上同样的流程几乎没有提升。第三,「无训练」不等于零成本:找到这个补丁用了 158 轮对话、80 次 Python 执行、20.3 小时。第四,中文媒体已经出现误读:36kr 把 IFEval 写成「近两倍」(实为约 3 倍),多家把「数学翻 6 倍」泛化成「智商翻 6 倍」,原文只测了 MATH-500。第五,独立复现尚未发生,作者自己的定性是 demo,不是可复现的工程能力。第六,安全是双刃剑:能读写权重就能审计模型后门,同样也就能植入后门。
五、X 上的后续:复现有了,交锋也来了
发布一天后,讨论分成了两派,而且都带着具体证据。效果层面有了复现支撑:作者 Rikiya Takehi 跟进称改过的 Qwen 已上传 Hugging Face,有第三方按公开日志重跑 MATH-500 得到 51.0%,比原文的 48.1% 还略高(x.com/rikiyatakehi/status/2117474915561701780)。但机制层面的反方同样具体:Anthony Maio 按日志重跑后认为「6 倍」站不住,理由是基线被配成了大量死循环,而已完成答案的准确率并没有变化(x.com/AnthonyMaio/status/2117637512499773868);Prasenjit Sarkar 拿 ROME、MEMIT 这类权重编辑算法做对比,指出这里没有专用编辑算法,只是通用大模型用自然语言改权重,性质更接近拆掉障碍而非补上能力;satsuki 的质疑更技术性:实验禁了梯度,但这样改出来的权重,会不会只是近似了基于梯度的更新。AVB 则澄清实验原意:用玩具网络衡量前沿模型能否无工具直接在权重空间推理,不是建议拿 Astra 去训练小模型。
两派合起来看反而清楚了:效果可复现,叙事有分歧:「模型能改权重」是真的,「6 倍等于能力提升」是没有证据的引申。
结语
冷水泼完,这件事的价值依然成立:它演示了「权重本身可以作为可编程接口」这个方向,而且日志全公开、第三方已经能按日志重建校验,透明度在同类演示里算顶格。正确的读法是:单实验、小模型、移除型修复、20 小时的试错成本,效果可复现、机制存争议。方向有意思,工程还早。
来源:博客 rikiyat.github.io/blog/weight-space-programming/;实验日志 github.com/RikiyaT/lm_understand-logs;HN 讨论页(1857 points);X 讨论(rikiyatakehi、AnthonyMaio、Prasenjit Sarkar、satsuki、AVB 等帖)。