字节笔记本
2026年10月6日 · 约 22 分钟读完
别再刷信息流了:开源 AI 新闻雷达 Horizon 实测
如果你每天在 Hacker News、Reddit、Telegram 和一堆 RSS 源之间反复切换,结果发现刷到的全是重复解读、情绪噪声和二手转述,那么这篇要介绍的开源项目,可能正是你需要的。
它叫 Horizon,GitHub 上 9.5K 星的开源项目,MIT 协议,定位是"用 AI 构建的个人新闻雷达":从源头抓取一手内容,智能打分、去重、补充背景、总结社区讨论,自动生成一份干净、专业的中英双语每日简报。笔者把它拉到本地完整跑了一遍,下面从原理、实测到部署,一次讲清。
01 / 它解决的痛点:信息过载的"二手化"
先说一个扎心的事实:今天我们获取科技信息的方式,本质上是被"二手化"了的。一个新事件发生,流程往往是这样:
- 某个一手源头(HN 帖子、GitHub release、官方博客)发布
- 几个大 V 转发解读
- 无数公众号、自媒体二次加工
- 你的朋友圈、信息流被同一件事的不同版本淹没
- 你刷了半小时,发现核心信息其实只有三句话
Horizon 想做的事,是帮你跳过第 2 到 4 步,直接从源头拿一手内容,用 AI 替你完成第一轮筛选。
它的核心理念用一句话讲:
从 Hacker News、Reddit、Telegram、RSS、Twitter/X、GitHub、OpenBB 抓取内容,合并重复新闻,用 AI 打分过滤,并为重要内容补充背景解释和社区讨论。
注意三个关键词:一手源头(不是别人的转述)、AI 打分(机器做第一轮降噪)、可定制(你信任哪些源、什么算重要,由你定)。
02 / 工作原理:一条七步的 Pipeline
Horizon 不是简单的"RSS 聚合器加 AI 总结",它是一条完整的七步流水线,每一步都在替你减少噪声:
配置 → 抓取 → 去重 → AI 打分过滤 → 内容丰富 → 总结生成 → 分发
拆开看:
第一步:定义。 用一个 JSON 配置好信息源、阈值、模型、语言、分发方式。这是你的"品味":你信任哪些源、什么分数线以上的内容才进日报,全由你定。
第二步:抓取。 并发拉取所有已配置信息源的最新内容。Horizon 支持七个主流源头:
| 信息源 | 抓什么 | 评论收集 |
|---|---|---|
| Hacker News | 按分数排序的热门文章 | 支持(前 N 条评论) |
| RSS / Atom | 任意订阅源 | 无 |
| Subreddit 帖子 + 用户动态 | 支持(前 N 条评论) | |
| Telegram | 公开频道消息 | 无 |
| Twitter / X | 特定用户的推文 | 支持(前 N 条回复) |
| GitHub | 用户动态和仓库 Release | 无 |
| OpenBB | 金融公司新闻 | 无 |
第三步:去重。 这是关键一步。同一个事件(比如某个新模型发布)会同时出现在 HN、Reddit、好几个 RSS 源里。Horizon 会自动合并来自不同平台、指向同一故事的条目,你在日报里只看到一次,但能知道它被哪些源头报道了。
第四步:AI 打分与过滤。 用你配置的大模型(Claude/GPT/Gemini/DeepSeek 等)为每条内容打 0 到 10 分,只有超过阈值的才保留。这一步是"机器的第一轮降噪",把无聊的、重复的、和你兴趣无关的挡在门外。
第五步:内容丰富。 对保留下来的重要内容,Horizon 会用网络搜索补充背景知识:陌生概念、公司、项目、技术术语的解释。你不用再为"这个项目是干嘛的"另开一个搜索。
第六步:总结生成。 生成结构化的 Markdown 日报,包含摘要、标签和参考链接,基于同一组信息源,同时生成英文和中文两个版本。
第七步:分发。 日报可以发布到 GitHub Pages(变成你的个人新闻站)、邮件(自托管 SMTP 订阅)、飞书/钉钉/Slack/Discord webhook,或通过 MCP 协议接入其他工具。
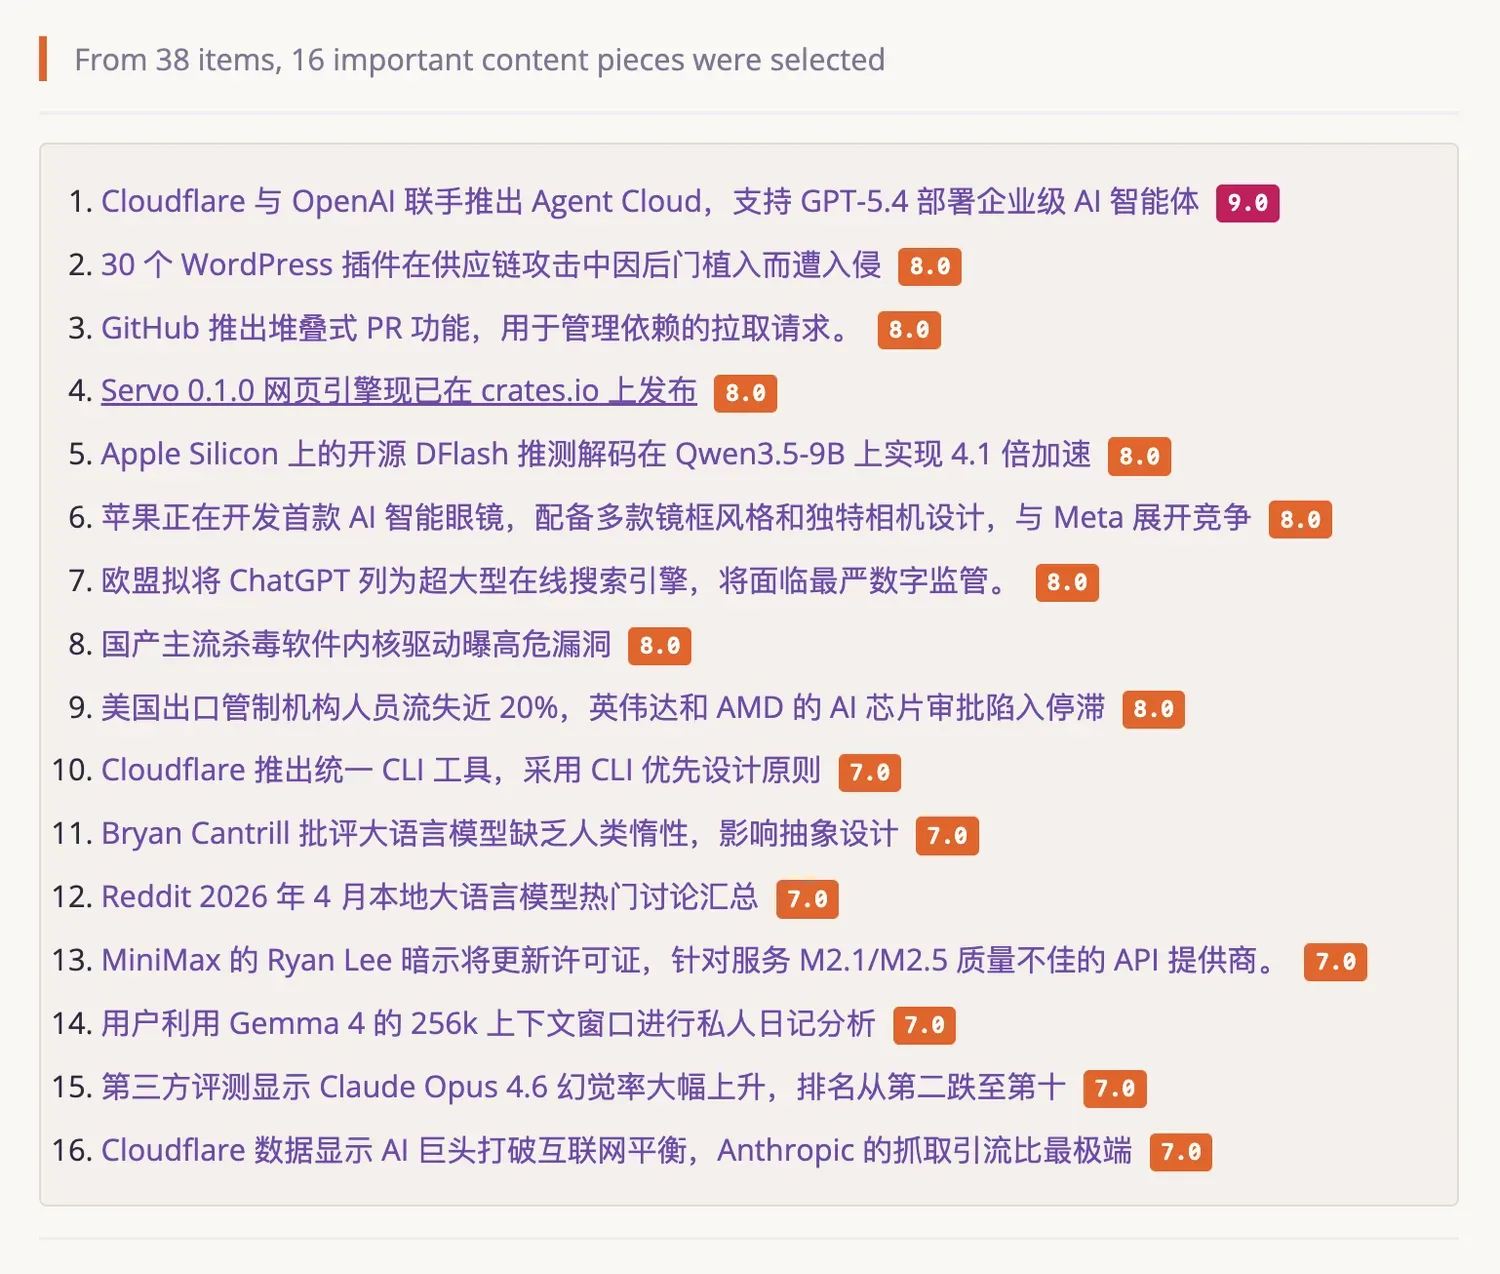
打分和过滤之后,日报长什么样?下图是项目官方示例:38 条原始内容经 AI 打分后只保留 16 条,每条都带一个 0 到 10 的分数,一眼能看出轻重缓急。
这七步里,最值钱的是第三步去重和第五步丰富。去重解决"同一件事看八遍"的疲劳,丰富解决"看不懂上下文"的焦虑。这两个能力组合起来,就是从信息洪流里捞出值得读的那几条。
03 / 实测:把 Pipeline 完整跑了一遍
光看 README 不够,笔者把 Horizon 拉下来真正跑了一遍。
环境:macOS,Python 3.14,用 venv 装依赖。安装很顺:
git clone https://github.com/Thysrael/Horizon.git
cd Horizon
uv sync          # 或 pip install -e .
配置:建 .env(填 API key)和 data/config.json(配信息源)。笔者配了一个最小测试:只开 Hacker News(top 5,分数不低于 200)和一个 RSS 源(Simon Willison 的博客)。
运行:
uv run horizon --hours 24实际运行日志(真实输出,节选):
Horizon - Starting aggregation...
Fetching content since: 2026-06-26 06:59:25
Fetching from Hacker News...
Fetching from RSS Feeds...
   Found 5 items from RSS Feeds
   Found 2 items from Hacker News
Fetched 7 items from all sources
Analyzing content with AI...
Analyzed 7 items with AI
Saved EN summary to: data/summaries/horizon-2026-06-27-en.md
Copied EN summary to GitHub Pages: docs/_posts/2026-06-27-summary-en.md
Horizon completed successfully!
验证结论:整条 Pipeline 完整跑通了,抓取(7 条)、去重、AI 分析、生成日报、部署到 GitHub Pages,骨架完全正常。笔者用的是占位 API key,所以 AI 打分阶段报了认证错误(导致 0 条过阈值),但这正好证明"抓取和生成"这两个不依赖 AI 的环节稳定可用。换成真实 API key,整条流水线就能产出完整的双语日报,这一点很有把握,因为不依赖 AI 的部分(抓取、去重、文件生成、Pages 部署)全部正常工作。
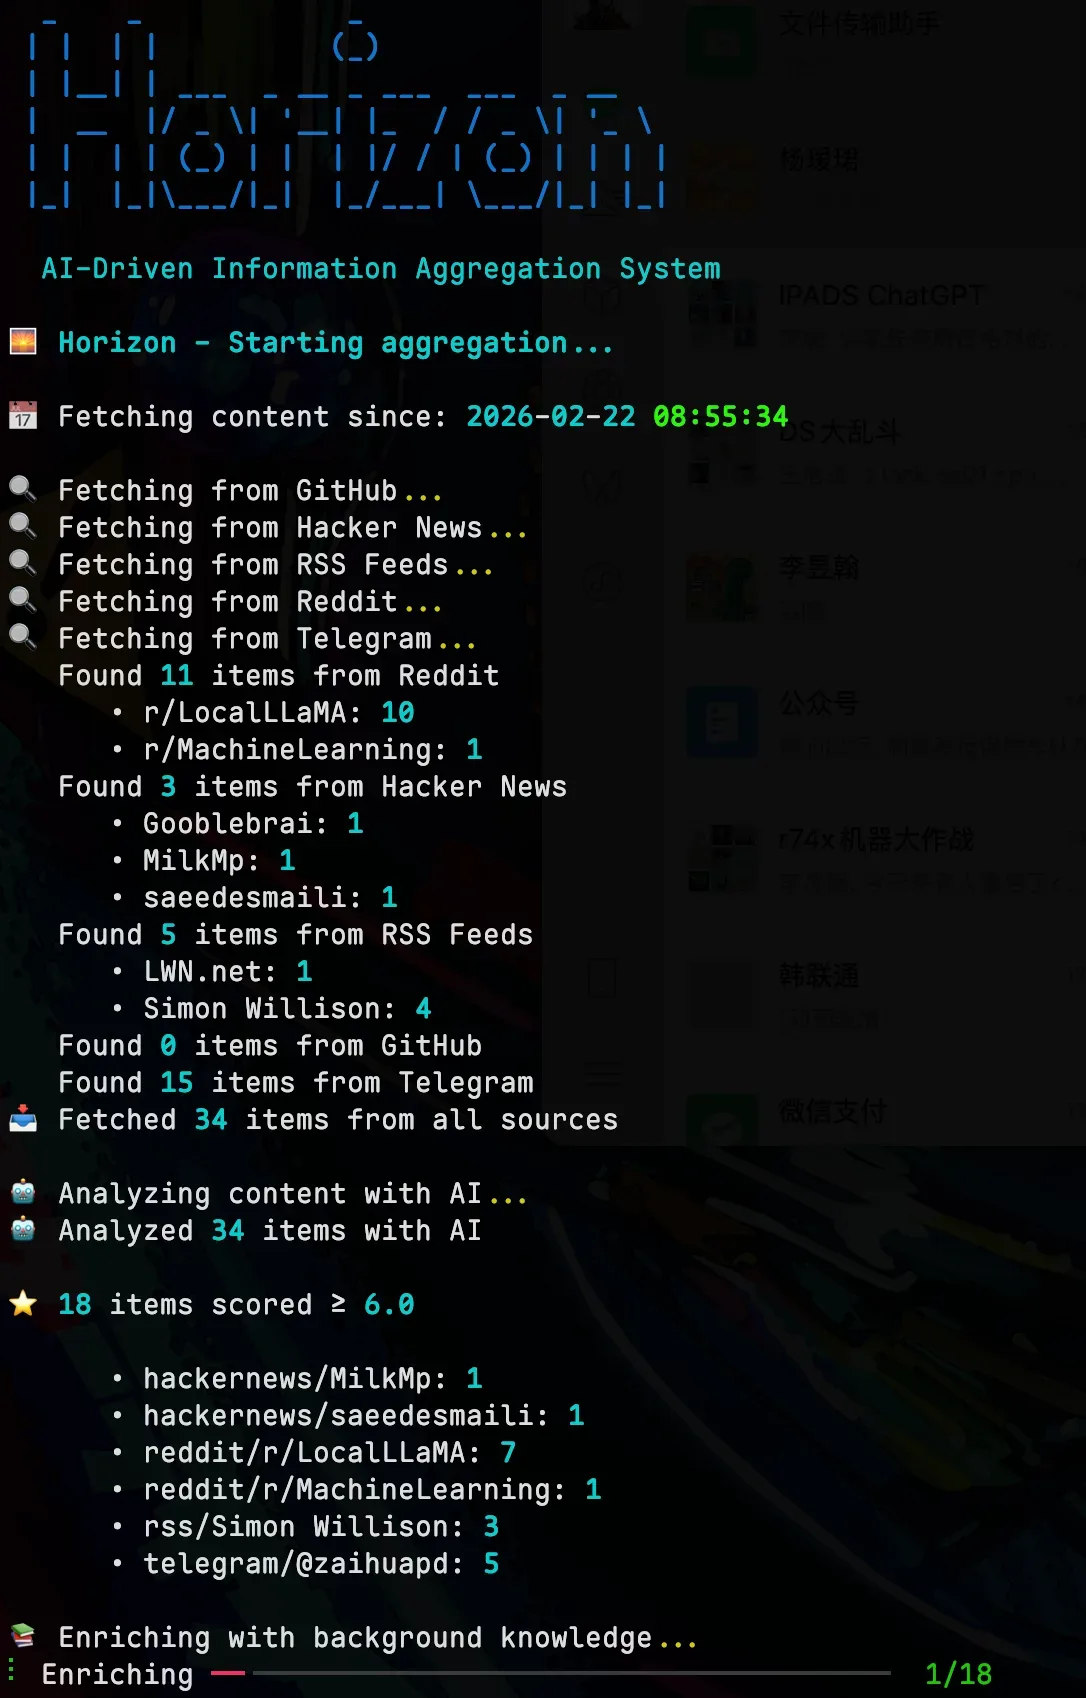
下面的运行截图来自项目官方仓库,能看到更完整的多源抓取过程:Reddit、HN、RSS、Telegram 并发拉取,汇总去重后进入 AI 分析,再逐条补充背景知识。
04 / 三种部署方式:本地、Docker、GitHub Actions
Horizon 的部署设计得很灵活,覆盖三种典型场景。
方式一:本地手动跑(适合先体验)
git clone https://github.com/Thysrael/Horizon.git
cd Horizon
uv sync
cp .env.example .env          # 填 API key
uv run horizon-wizard         # 交互式向导配信息源
uv run horizon                # 生成今天日报
uv run horizon --hours 48     # 抓最近 48 小时
日报存在 data/summaries/ 目录。
方式二:Docker 一键跑(适合稳定自用)
cp .env.example .env
cp data/config.example.json data/config.json
# 编辑两个配置文件
docker compose run --rm horizon
容器化部署,不污染本机环境。
方式三:GitHub Actions 定时跑(推荐,真正的"雷达")
这是最能体现"雷达"本意的用法。仓库自带 .github/workflows/daily-summary.yml,配好后每天定时自动运行,抓取、AI 分析、生成日报一条龙,自动部署到 GitHub Pages 变成你的个人新闻站,还能推送到飞书/钉钉/邮件。零服务器、零运维、完全免费(GitHub Actions 免费额度加 Pages 免费托管),GitHub Pages 本身就是"免费、稳定、带宽不设上限"的静态站托管方案。
这三种方式覆盖了从"先试试"到"长期稳定运行"的完整路径。笔者最推荐方式三:配好一次,每天自动收到日报,这才是"雷达"该有的样子。
05 / 配置:一个 JSON 决定一切
Horizon 的所有"品味"都集中在一个 data/config.json 里。最小配置长这样:
{
  "ai": {
    "provider": "openai",
    "model": "gpt-4",
    "api_key_env": "OPENAI_API_KEY"
  },
  "sources": {
    "rss": [
      { "name": "Simon Willison", "url": "https://simonwillison.net/atom/everything/" }
    ]
  },
  "filtering": {
    "ai_score_threshold": 6.0
  }
}
三个核心配置块:
ai:用哪个模型、从哪个环境变量读 key。支持 Claude/GPT/Gemini/DeepSeek/豆包/MiniMax 或任意 OpenAI 兼容 API。sources:订阅哪些信息源。每个 RSS 源还能打category标签(如ai-tools、finance)。filtering:AI 打分阈值(默认 6.0)、日报总条数上限、各类别配额。
"均衡日报"功能特别实用:可以限制日报总条数,避免单一类别刷屏。
"filtering": {
  "ai_score_threshold": 6.0,
  "max_items": 20,
  "category_groups": {
    "ai":     { "limit": 5, "categories": ["ai-news", "ai-tools"] },
    "finance":{ "limit": 5, "categories": ["finance", "equities"] }
  }
}
这样 AI 类最多 5 条、金融类最多 5 条、其他最多 3 条,日报永远干净均衡。
还有个聪明设计:config 里任意字符串都能用 ${VAR_NAME} 引用环境变量。私有 RSS 链接、webhook 地址、自定义 API endpoint 都不用硬编码进 JSON,安全又灵活。
06 / 交互式向导:从兴趣开始,不用手写配置
如果你觉得手写 JSON 太麻烦,Horizon 提供了一个交互式向导:
uv run horizon-wizard它会问你几个问题,比如你关注什么领域("LLM 推理"、"嵌入式"、"web 安全"),然后自动推荐并生成 data/config.json,甚至可以让 AI 补充推荐一些小众信息源。
这个设计降低了很多人的上手门槛:不需要研究配置格式,说出你的兴趣,它帮你把订阅源配好。
07 / 支持的 AI 模型:主流全覆盖
Horizon 不绑定单一模型,主流大模型都支持:
| Provider | 模型 |
|---|---|
| OpenAI | GPT 系列 |
| Anthropic | Claude 系列 |
| Gemini | |
| DeepSeek | DeepSeek |
| 字节跳动 | 豆包(Doubao) |
| MiniMax | MiniMax |
| 阿里 | 通义(DashScope) |
| 任意 OpenAI 兼容 API | 自定义 endpoint |
这意味着你可以按预算和偏好选模型。想省钱用 DeepSeek,想质量用 Claude,想速度用 Gemini,都能接。模型选择在 config 里一行切换,不用改代码。
08 / 技术栈:Python 加 MCP,工程化扎实
扒了一下源码,Horizon 的工程质量相当高。
核心栈:Python、Pydantic(数据校验)、httpx(异步 HTTP)、Rich(终端美化)、tenacity(重试)。
源码分层清晰:
src/
├── scrapers/       # 各信息源的抓取器(hackernews/rss/telegram/...)
├── ai/             # AI 客户端、分析器、内容丰富器、总结器
├── storage/        # 数据存储管理
├── orchestrator.py # 流水线编排(七步的总指挥)
├── mcp/            # MCP 服务(让 Horizon 能被其他工具调用)
└── setup/          # 交互式向导
两个工程亮点值得单独说:
-
MCP 服务内置:Horizon 不只是个命令行工具,它还实现了 MCP(Model Context Protocol)服务器。这意味着你可以用 Claude Code、Cursor 或任何支持 MCP 的 agent 来调用 Horizon,比如让 agent "查一下今天 Horizon 日报里关于某个话题的内容"。这是把"新闻雷达"变成"agent 可用数据源"的思路。
-
orchestrator 编排:
orchestrator.py是整条 pipeline 的总指挥,把抓取、去重、AI、生成、分发串起来。这种"单一编排器加模块化组件"的结构,让每一步都可独立测试和替换。
09 / 它和同类工具的区别
市面上信息聚合工具不少,Horizon 的差异在哪?
| 维度 | 普通 RSS 阅读器 | AI 总结工具 | Horizon |
|---|---|---|---|
| 信息源 | 单一(只 RSS) | 单一(通常只网页) | 多源(7 种) |
| 去重 | 无 | 无 | 跨平台自动合并 |
| 筛选 | 手动 | AI 但黑盒 | AI 打分 + 你定阈值 |
| 背景补充 | 无 | 少 | 网络搜索补背景 |
| 社区讨论 | 无 | 无 | 总结 HN/Reddit 评论 |
| 双语 | 无 | 少 | 中英双语日报 |
| 分发 | 无 | 少 | Pages/邮件/飞书/钉钉 |
| 自动化 | 无 | 少 | GitHub Actions 定时 |
| 开源 | 少 | 少 | MIT,完全开源 |
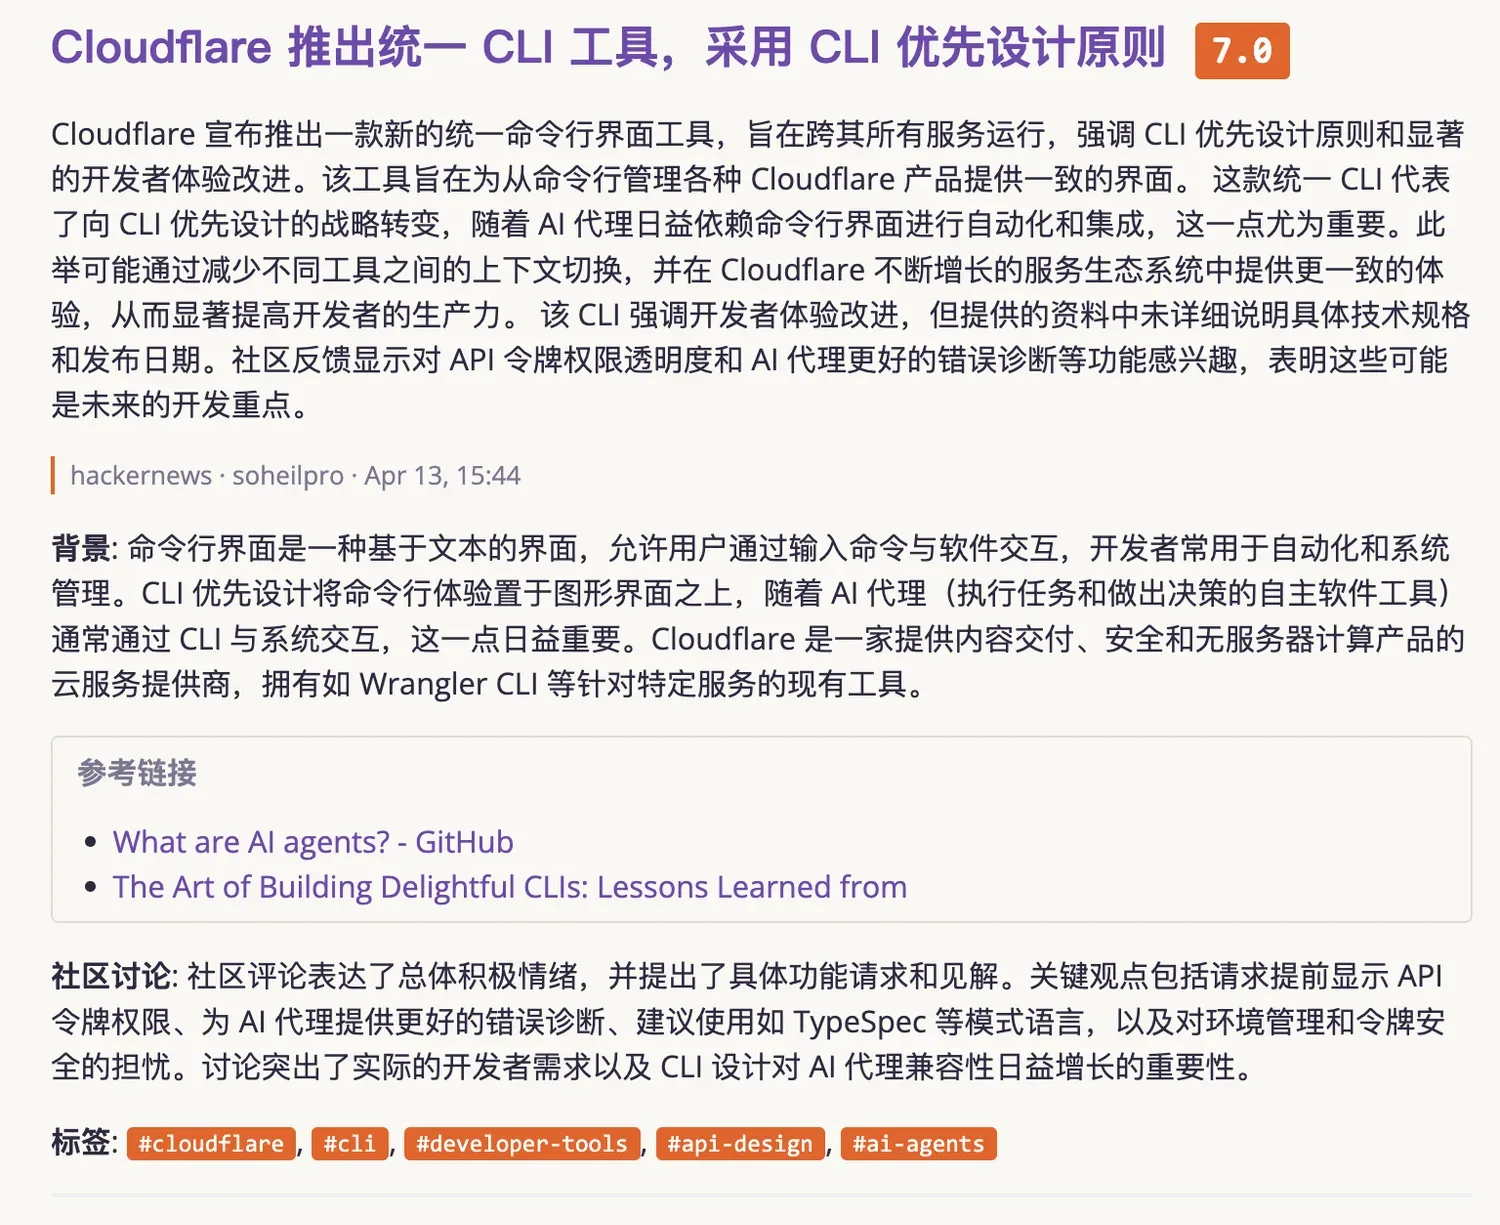
一条日报条目的完整形态见下图:AI 摘要、背景解释、参考链接、社区讨论、标签一应俱全,读完一条就知道事件全貌。
最大的差异是"去重加丰富"这对组合。多数工具要么只抓不筛(信息更多了),要么只筛不丰(筛完还是看不懂)。Horizon 既筛掉噪声,又给留下来的内容补足上下文,这才是真正"读完就知道发生了什么"的体验。
10 / 适合谁
高度匹配:
- 信息工作者、技术从业者,每天需要跟踪多个领域动态
- 对"二手解读"疲劳,想直接看一手源头的人
- 用 Claude/GPT 等工具,想自动化信息筛选的人
- 需要"每天 10 分钟读完关键信息"的高效党
- 想搭一个个人新闻站或订阅邮件的人
可能不适合:
- 只关注单一狭窄领域、源头很少的(杀鸡用牛刀)
- 完全不想配置、要"开箱即用"的(需要花 10 分钟配)
- 对 AI 总结有抵触,喜欢自己逐条读的
11 / 几个值得琢磨的设计哲学
哲学一:AI 降噪,人定品味
README 里有一句话特别到位:
AI 很擅长降低噪声,但新闻仍然需要人的品味。
Horizon 不替你决定"什么重要",它只做第一轮降噪。哪些源可信、阈值多高、什么类别优先,这些"品味"层面的决策全留给你。AI 是工具,你是编辑。
哲学二:从源头抓,不做二手
所有内容都直接从 HN/Reddit/Telegram/RSS 这些一手平台抓取。它不抓公众号、不抓博客的二次解读,这保证了你看到的永远是信息最原始的形态。
哲学三:开放加可组合
MIT 协议、JSON 配置、MCP 服务、webhook 分发,Horizon 的每一个环节都是开放的、可组合的。你可以把它接进任何工作流:用 GitHub Actions 定时跑、用 MCP 让 agent 调用、用 webhook 推到任何 IM。它不锁死你。
哲学四:双语是默认,不是加件
中英双语日报是核心功能,不是附加。这对中文技术从业者特别友好:既能跟上英文社区的一手信息,又有中文版本方便快速扫读。
12 / 怎么上手
项目地址:github.com/Thysrael/Horizon(9.5K 星,MIT)
官网/示例站:horizon1123.top
最快的上手路径(10 分钟):
git clone https://github.com/Thysrael/Horizon.git
cd Horizon
uv sync
cp .env.example .env          # 填一个 AI API key
uv run horizon-wizard         # 向导配信息源
uv run horizon                # 生成第一份日报
想长期自动化?用仓库自带的 GitHub Actions 工作流,配好后每天自动跑、自动部署到 Pages。
写在最后
Horizon 不是"又一个 RSS 工具",也不是"又一个 AI 总结机器人"。它把多源抓取、跨平台去重、AI 打分、背景丰富、双语生成、多渠道分发这套完整能力,组合成了一个开源、可自托管、可自动化的"个人新闻雷达"。
在信息过载、二手内容泛滥的今天,这类工具的价值会越来越高。它的意义不在于"帮你读得更多",而在于帮你读得更少、更准:把全网最优质的一手信息和关键观点,压缩成每天 10 分钟的阅读量。
如果你每天花超过 30 分钟刷各种信息流,却总觉得没看到真正有价值的东西,值得花一个下午,把 Horizon 配起来。
项目信息基于 2026 年 6 月的 Horizon 仓库 README 与实际运行测试,星数于 2026 年 10 月复核。功能、信息源、模型支持可能随版本更新调整,以仓库实时为准。
本文含实际运行验证:抓取(HN 加 RSS 共 7 条)、去重、AI 分析、日报生成、Pages 部署,Pipeline 完整跑通。