字节笔记本
2026年10月5日 · 约 15 分钟读完
HTTP 新增 QUERY 方法:复杂查询不再硬塞 URL
每个写过 API 的人都遇到过同一个困境:查询条件一多,GET 的 URL 就塞不下了;改用 POST,又会丢掉缓存、自动重试和语义正确性。2026 年 6 月,IETF 正式发布 RFC 10008,给 HTTP 标准新增了一个方法:QUERY。它目前是 Proposed Standard(建议标准),属于 HTTP 语义层面少有的大改动。消息公布后在开发者社区引发大量转发与讨论,不少框架作者和工程师第一时间跟进。为什么一个新方法能有这么大关注度?因为它解决的是一个所有 Web 开发者都踩过、却一直没有官方解法的老问题。本文把它讲透。
一、它解决什么老问题:GET 的 URL 长度限制
先看一个具体场景。你要做一个复杂查询:找出所有价格在 5000 到 10000 之间、品牌是联想或华为、显卡 4060 以上、内存 16G 以上、按评分降序的笔记本。
如果用 GET,所有条件都得塞进 URL query string:
GET /products?category=laptop&minPrice=5000&maxPrice=10000&brand=lenovo&brand=huawei&gpu=rtx4060&minRam=16&sort=rating desc
条件一多,URL 就爆炸。而 URL 是有长度限制的:HTTP 规范本身没规定硬上限,但浏览器(Chrome 约 2MB)、服务器(Nginx 默认 4 到 8KB)、CDN、代理,层层都有各自的限制。复杂查询很容易超长,请求直接被截断或拒绝。
那用 POST 呢?把条件放进 body,长度问题确实没了:
POST /products/search
Content-Type: application/json

{ "category": "laptop", "minPrice": 5000, ... }
但 POST 有个大问题:在 HTTP 语义里它是「不安全」的方法,意味着「我要改东西」。这带来一连串麻烦:
- 不能缓存:POST 响应默认不进缓存
- 不能自动重试:浏览器和客户端不敢随便重发 POST,怕重复创建数据
- 语义错位:你明明是「查」不是「改」,却用了「改」的方法
- 浏览器警告:刷新 POST 请求会弹「确认重新提交表单」
- 中间件行为异常:很多网关和框架对 POST 有特殊处理,比如限流、日志、CSRF token 校验
于是开发者陷入两难:用 GET 受 URL 长度限制,用 POST 失去缓存和语义正确性。这个矛盾存在了近三十年,QUERY 就是来终结它的。
二、QUERY 是什么:GET 的语义,POST 的能力
RFC 10008 给的定义很精炼。QUERY 是一个 HTTP 方法,它请求服务器「以安全、幂等的方式处理随附的内容,并返回处理结果」。三种方法的对比一目了然:
| 特性 | QUERY | GET | POST |
|---|---|---|---|
| 安全(不改服务器状态) | 是 | 是 | 否,可能改 |
| 幂等(发一次和十次效果一样) | 是 | 是 | 否 |
| 能带请求体(body) | 能 | 没有正式定义 | 能 |
| 可缓存 | 能 | 能 | 默认不能 |
| 可自动重试 | 能 | 能 | 不能 |
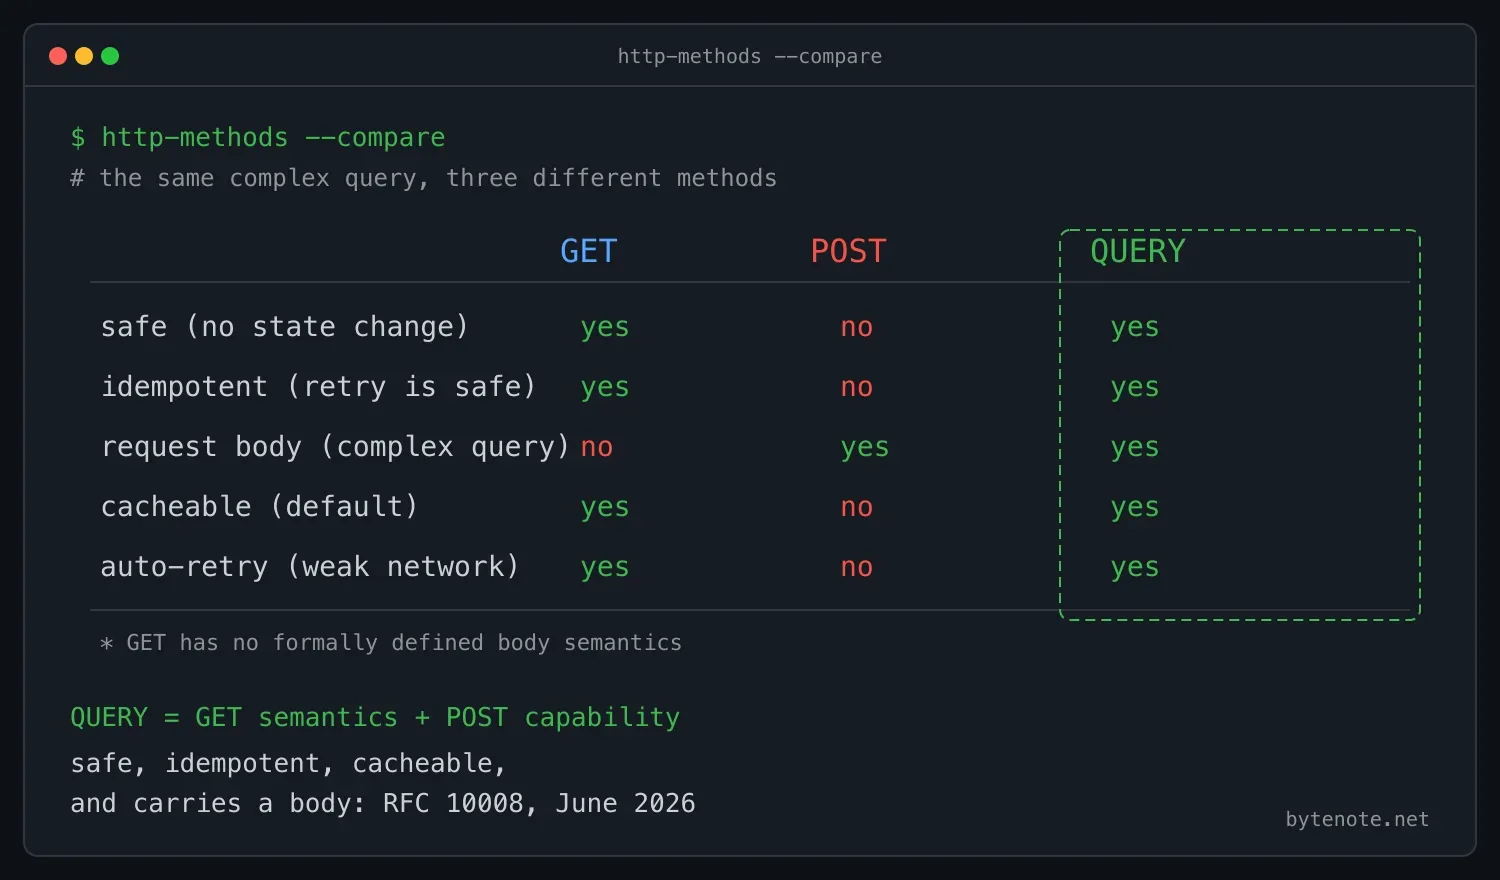
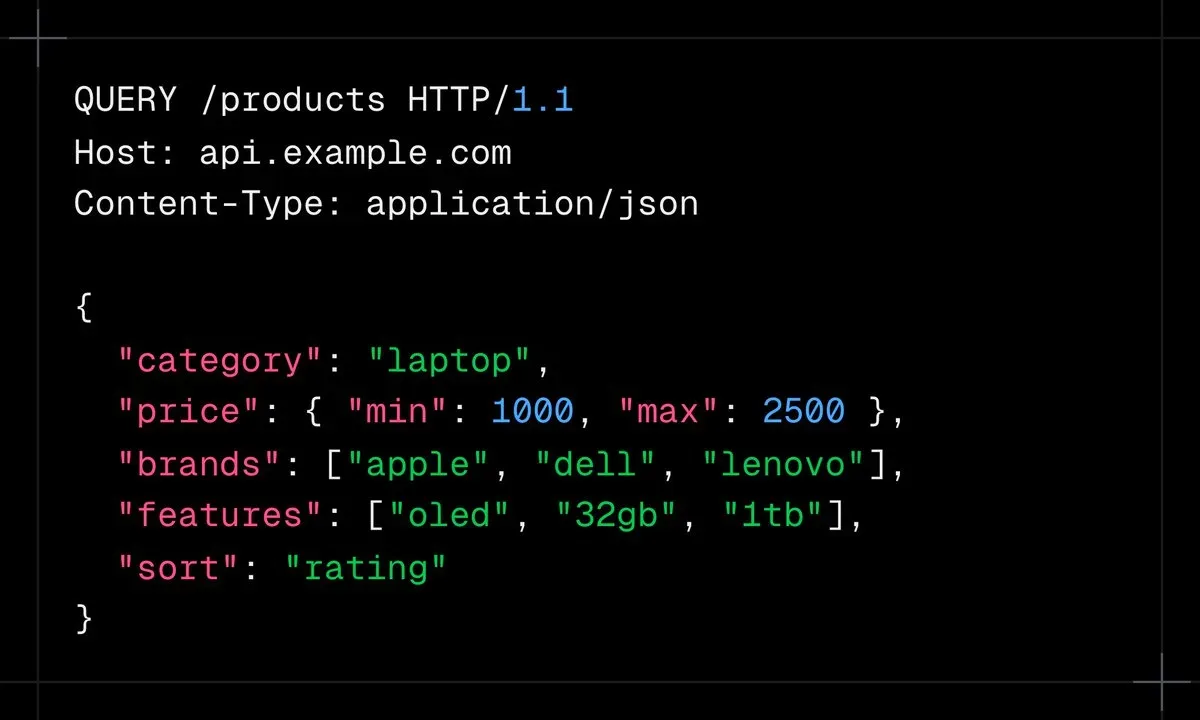
一句话总结 QUERY:像 GET 一样不改状态、可缓存、可重试,但像 POST 一样能用 body 发复杂请求。用起来长这样:
QUERY /products HTTP/1.1
Content-Type: application/json

{
  "category": "laptop",
  "price": { "min": 5000, "max": 10000 },
  "brand": ["lenovo", "huawei"],
  "specs": { "gpu": "rtx4060", "minRam": 16 },
  "sort": "rating:desc"
}
复杂的查询条件全在 body 里(JSON),URL 保持干净,响应还可缓存、可自动重试。规范同时定义了 Accept-Query 响应头,服务器可以用它声明自己支持的查询格式。
三、三个关键词,逐个解释
1. Safe(安全)
在 HTTP 语义里,「安全」不是指加密传输(那是 HTTPS 的事),而是指这个请求不改服务器状态。GET 是安全的(只读取),POST 不是(可能创建或修改数据)。
QUERY 是安全的,它只查不改。这意味着浏览器可以放心预取(prefetch)QUERY 请求,爬虫可以发 QUERY 而不担心搞坏服务器,日志系统也不必把它当敏感操作记录。
2. Idempotent(幂等)
幂等指发一次和发十次效果一样。GET 幂等(读十次结果一样),POST 不幂等(提交十次可能创建十条数据)。
QUERY 幂等,所以网络抖动时客户端可以自动重试而不担心副作用。这对移动端和弱网环境特别重要:GET 能自动重试,POST 不能,现在 QUERY 也能。
3. Cacheable(可缓存)
这是 QUERY 相对 POST 最大的优势。POST 响应默认不进缓存,因为它不安全也不幂等,缓存它可能得到脏数据。QUERY 因为安全且幂等,响应可以像 GET 一样被缓存:浏览器缓存、CDN 缓存、反向代理缓存都能用。
对一个复杂搜索接口,这意味着同样的查询条件第二次请求可以直接命中缓存,不用重新计算,对服务器压力和响应速度都是实打实的利好。
四、为什么以前没有 QUERY:一段历史
HTTP 方法的语义其实是历史包袱。1991 年的 HTTP/0.9 只有 GET;1996 年 HTTP/1.0 加了 POST 和 HEAD;1997 年 HTTP/1.1 加了 PUT、DELETE、OPTIONS、TRACE、CONNECT。然后就基本冻结了,近三十年没加过新方法。
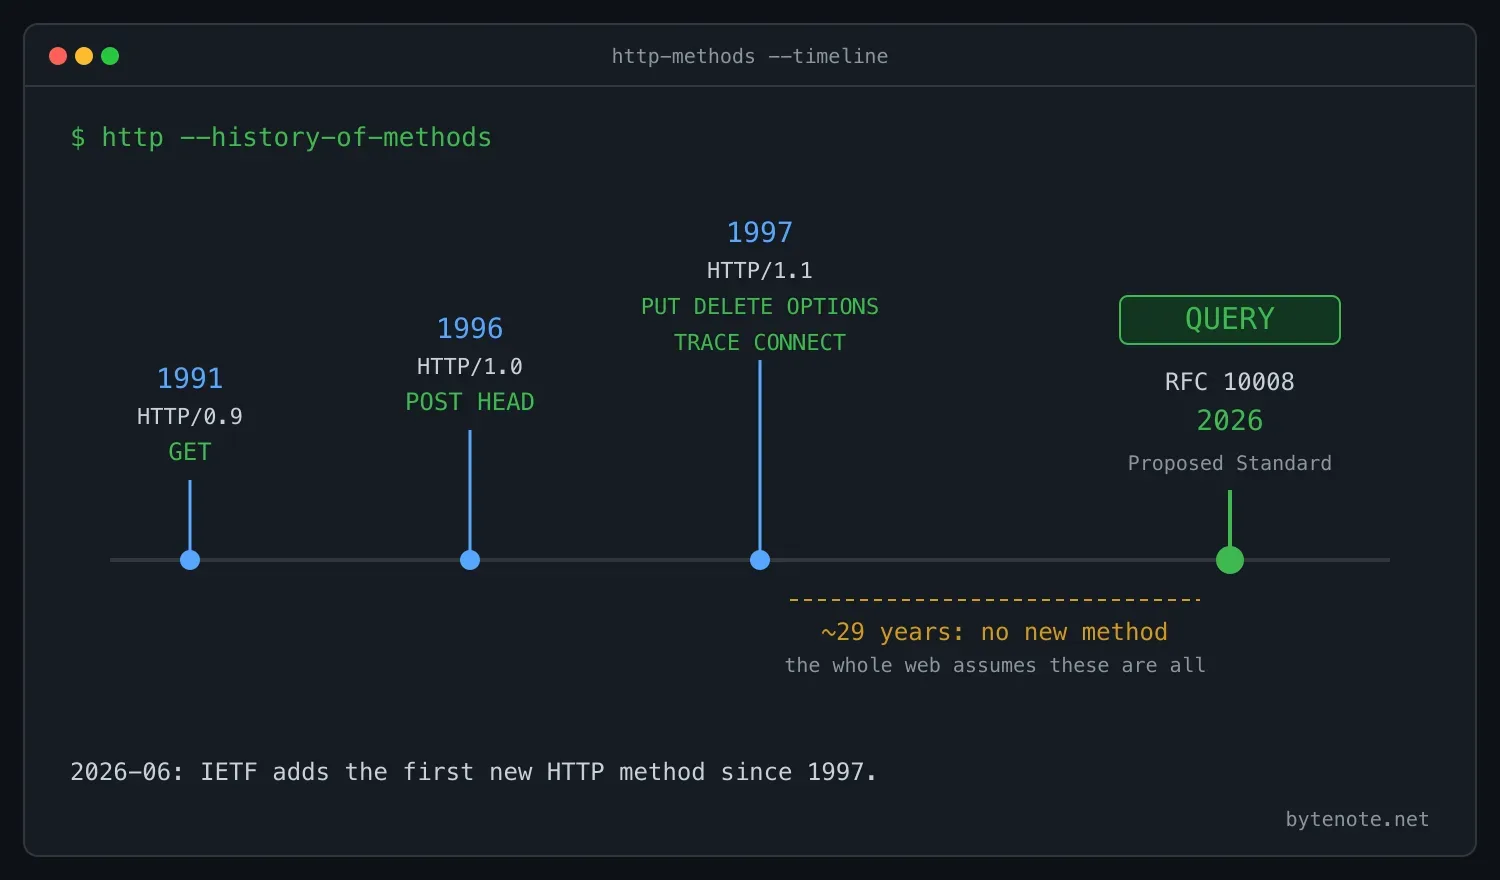
为什么不加?因为 HTTP 方法的语义是整个 Web 的基石。浏览器、服务器、CDN、代理、爬虫,所有东西都假设「方法就这几个」。加一个新方法,意味着整个生态都要跟着认,改 HTTP 方法等于动 Web 的地基,阻力极大。
那 QUERY 为什么能通过?因为它填补的是一个真实存在、影响所有开发者的空白:「安全、可缓存、又能带 body 的查询」。这个空白被讨论了很多年,2015 年前后就有草案提案,经过 HTTPbis 工作组长期打磨,终于在 2026 年成为 Proposed Standard。RFC 编号 10008 也有象征意义:五位数说明 HTTP 相关的 RFC 已经积累了厚厚一摞,这个编号本身就是标准演进的里程碑。
五、Proposed Standard 是什么意思,能立刻用吗
IETF 的标准流程分多档,简化理解就是两级:
- Proposed Standard(建议标准):RFC 已发布,规范稳定,鼓励实现和采用,但还不是最终形态。
- Internet Standard(互联网标准):经过广泛部署和验证后的最终标准。大多数 RFC 停在前一档就够用了,HTTP/1.1 当年也是先走这一步。
Proposed Standard 意味着规范已定,可以开始实现和使用了。但能不能立刻用,取决于生态支持。
浏览器方面,要能发 QUERY 请求才行。注意浏览器原生 fetch API 对自定义方法携带 body 有限制,HTML 表单又只支持 GET 和 POST,所以短期内 QUERY 更多用在 API 调用场景:服务端到服务端、移动端 App 到服务端,而不是浏览器表单。
服务器与框架方面,Express、FastAPI、Spring、Nginx 这些主流实现都需要更新来识别 QUERY。短期内大概率要手动配置放行,很多服务器默认只允许「已知」方法,会把 QUERY 当非法请求拒绝。
CDN 与代理方面,Cloudflare、Fastly、Varnish 这类都要更新缓存逻辑才能缓存 QUERY 响应,这需要时间。
务实的预期是:从 Proposed Standard 到开箱即用,大概还有一到三年的生态跟进期。HTTP/2 当年也是先有标准,再慢慢被浏览器和服务器普遍支持。
六、什么时候该用 QUERY
该用的场景:
- 复杂搜索和筛选 API:条件太多,GET 的 URL 装不下
- 图数据库、GIS 的复杂空间查询:查询条件本质是结构化数据
- 不想上 GraphQL 时的替代:用 REST 风格发复杂查询
- 报表和分析查询:查询参数是一大坨 JSON
- 一切「只读但参数复杂」的接口
不该用的场景:
- 简单查询:一两个参数用 GET 就够了,别为用而用
- 创建、修改、删除数据:继续用 POST、PUT、PATCH、DELETE
- 浏览器 HTML 表单:表单不支持,老老实实 GET 和 POST
- 需要立刻在所有环境跑通:生态还没完全跟上,短期有兼容性风险
务实的建议是:短期内在内部 API 和服务间通信里先用 QUERY,这些场景客户端和服务端都由你自己控制,兼容性可控;面向公众的 API 等生态成熟后再迁移。
七、一个微妙的争议:QUERY 真的必要吗
社区对 QUERY 并非一边倒叫好,主要有三种质疑。
质疑一:POST 也能查,何必新增方法。反驳:POST 能查,但丢失了 safe、idempotent、cacheable 三个语义。用 POST 查询是「能用但不对」,就像用螺丝刀敲钉子,能敲进去,但螺丝刀不是干这个的。QUERY 让工具和方法对齐。
质疑二:GraphQL 已经解决了复杂查询。反驳:GraphQL 解决的是复杂查询的产品形态,但它是独立协议,要求你重写整个 API 层。QUERY 是 HTTP 层的原生方法,继续用 REST 风格,只在需要时用 QUERY 发复杂查询。两者不冲突,是不同抽象层的东西。
质疑三:URL 长度限制有别的绕法。确实有,比如 POST 加 Content-Location 头再配合 303 重定向的「POST-then-GET」模式。但这些方案都很绕,各有缺陷:重定向多一次往返,缓存逻辑也复杂。QUERY 是把这些变通方案标准化、原生化的干净解法。
我的判断:QUERY 不是「必须」,但它是「应该有却一直没有」的东西。它的价值在语义正确性,让「只读复杂查询」有了自己的名字,不再寄生在 POST 上。语义清晰本身就是工程价值。
八、对普通开发者的影响
你可能觉得 HTTP 加方法关我啥事,其实关系不小:
- 以后设计复杂查询 API,有了官方推荐姿势,不用在 GET 硬塞 URL 和 POST 假装查询之间纠结。
- 缓存复杂查询成为可能。以前搜索结果基本不能缓存(因为用 POST),QUERY 让它可缓存,对高流量搜索接口是性能利好。
- 弱网体验改善。QUERY 可自动重试,移动端复杂查询请求在网络抖动时更稳。
- 面试知识要更新了。「HTTP 有哪些方法」这道经典题,答案要多写一个 QUERY。
但短期内一两年,大多数开发者可能感知不强,因为要等框架、服务器、CDN 普遍支持。这是标准先行、生态跟进的长期过程。
九、怎么跟踪和参与
- RFC 原文:RFC 10008, The HTTP QUERY Method
- 最新草案:greenbytes 维护的 working draft
- HTTPbis 工作组:ietf-http-wg 邮件列表,标准讨论的主战场
- 基础语义:RFC 9110, HTTP Semantics,QUERY 扩展的基础
如果你做 Web 框架、HTTP 客户端、CDN 或 API 网关,现在是实现 QUERY 支持的好时机:在标准早期就参与,对项目和自己都是加分项。
十、小结
一句话总结:HTTP 新增了 QUERY 方法(RFC 10008),它像 GET 一样安全、可缓存、可重试,又能像 POST 一样用 body 发复杂查询,终结了「复杂查询该用 GET 还是 POST」的三十年老难题。
这件事的意义不在「加了个方法」,而在于 Web 的地基(HTTP 语义)在三十年后终于补上了一块缺失的拼图。那些年我们用 POST 假装查询、用 GET 硬塞 URL、用各种变通方案绕过的尴尬,终于有了官方的正确答案。
生态全面支持还需要时间,但方向已经定了。下次有人问你「复杂查询用 GET 还是 POST」,你可以多说一句:标准上,现在有第三个答案了,QUERY。
本文依据 IETF RFC 10008(Datatracker)公开规范整理。QUERY 方法截至 2026 年 6 月为 Proposed Standard 状态,生态支持正在跟进中。