字节笔记本
2026年10月5日 · 约 14 分钟读完
Karpathy 的第二大脑:让 AI 替你维护知识库
你大概率有过这种经历:Obsidian(或 Notion、Logseq)用了一阵子,存了几百篇文章、几千条高亮,然后呢?然后就没有然后了。
笔记越堆越多,但它们彼此不链接、不交叉、不生长。那张漂亮的图谱视图看起来很唬人,实际上是一团死结。一年后你打开它,发现里面的东西自己早就忘了为什么存。
Andrej Karpathy(前特斯拉 AI 总监、OpenAI 创始成员)说破了这件事:大多数 vault 死于同一种方式:囤了一年的文章和高亮,没有一个被链接起来。图谱在腐烂,只是看起来还很壮观。
他的解法不是"换更好的笔记软件",而是把 vault 的维护工作,交给模型。你负责筛选来源、提出问题,Claude 负责归档、链接、对账。你保留判断,它记账。
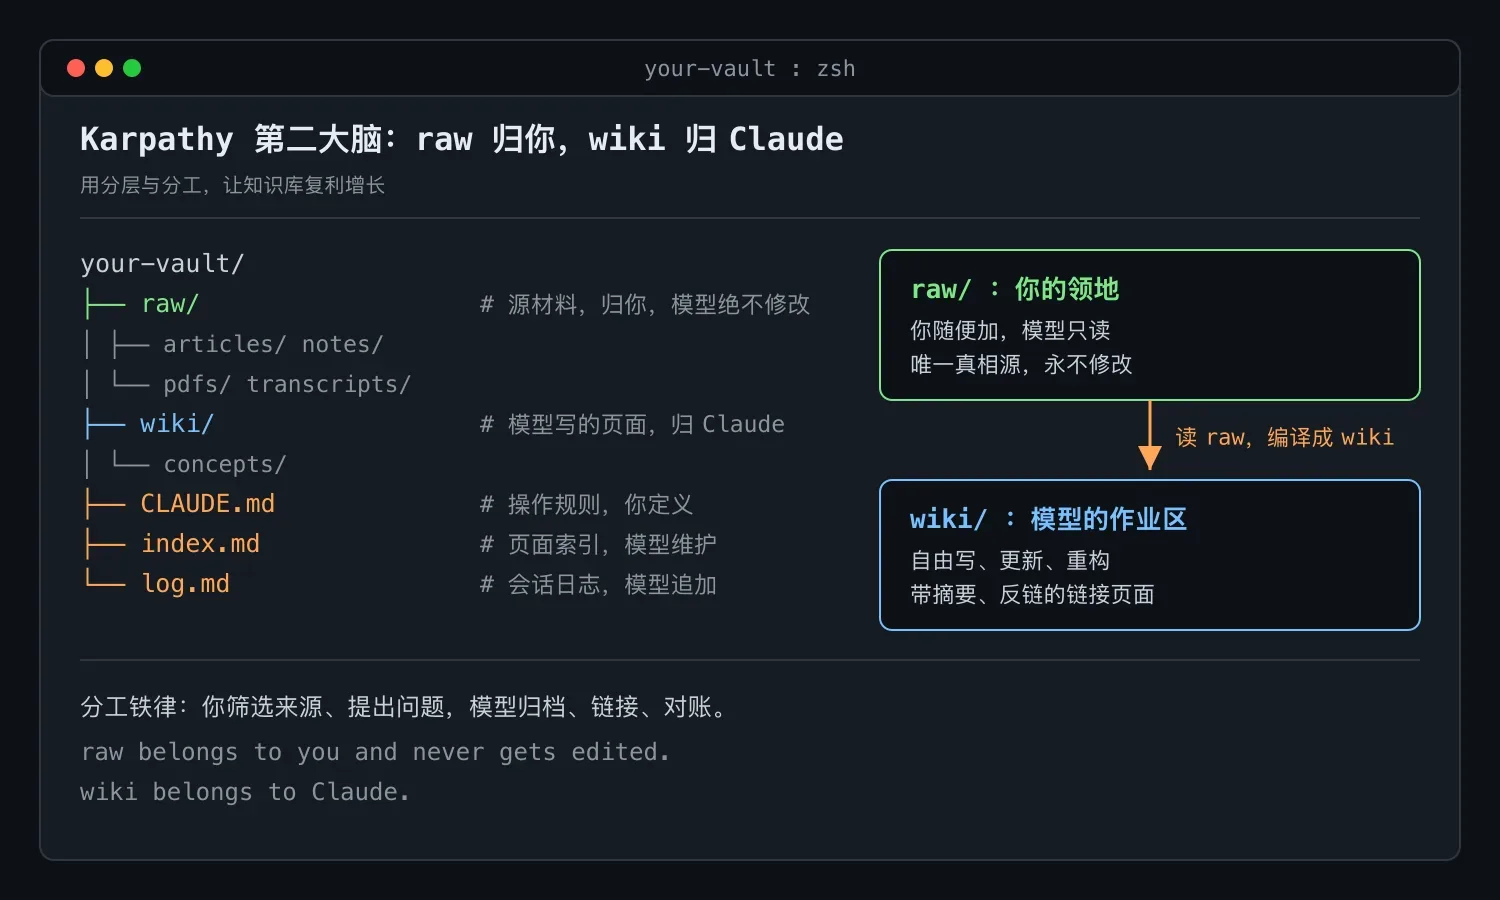
raw 归你,wiki 归 Claude:用分层和分工,让知识库复利增长。
一、核心思想:不是更好的笔记软件,是换一种分工
先理解 Karpathy 要解决的真问题。
传统第二大脑(PARA、Zettelkasten 等)的死穴在于:它们的维护成本全压在用户身上。每存一篇文章,你得:读完、提炼要点、找关联、建反链、归到合适的分类。这套动作重复几十次后,人就放弃了。于是 vault 变成"知识坟场"。
Karpathy 的洞察是:这件事不该人干。
你筛选来源、提问。Claude 归档、链接、对账。你保留判断,它记账。
这是一个分工的转移:把 upkeep(维护)从人挪到模型。人做最擅长的事(判断什么值得存、问对的问题),模型做它最擅长的事(机械地读、提炼、交叉链接、维护索引)。
二、架构:raw 归你,wiki 归 Claude
整个系统的核心是一个清晰的分层。这是 Karpathy 方法最关键的设计,多份独立教程(agricidaniel、TheToolNerd、Medium 多位作者)都一致确认:
your-vault/
├── raw/          # 源材料,归你,永不修改
│   ├── articles/
│   ├── notes/
│   ├── pdfs/
│   └── transcripts/
├── wiki/         # 模型写的页面,归 Claude
│   ├── concepts/
│   └── ...
├── CLAUDE.md     # 操作规则(给模型的指令)
├── index.md      # 已有 wiki 页面索引
└── log.md        # 最近发生了什么
每个目录的职责:
| 目录 | 归谁 | 干什么 | 能不能改 |
|---|---|---|---|
| raw/ | 你 | 存原始资料(文章、笔记、PDF、转录) | 你随便加,模型绝不修改 |
| wiki/ | Claude | 模型读 raw 后写的 Markdown 页面 | 模型自由写、更新 |
| CLAUDE.md | 你 | 定义规则、风格、分类逻辑 | 偶尔调 |
| index.md | Claude 维护 | 已有哪些 wiki 页面 | 模型自动更新 |
| log.md | Claude 维护 | 最近的变更记录 | 模型自动追加 |
这个分层的精髓是"职责分离":raw 是 single source of truth(唯一真相源),神圣不可侵犯;wiki 是模型的作业区,随便它折腾。两者互不污染。
Moysei 推文里那句 "raw belongs to you and never gets edited. wiki belongs to Claude",说的就是这条铁律。
三、为什么不是 RAG(这是最反直觉的一点)
很多人第一反应:这不就是 RAG(检索增强生成)吗?vector embedding + 相似度搜索?
不是。Karpathy 明确反对用 RAG 做这件事。
区别在于:
| RAG | Karpathy 的 LLM Wiki | |
|---|---|---|
| 工作方式 | 每次提问,实时检索向量库 | 编译一次,之后从 wiki 读 |
| 产出 | 零散的相关片段 | 结构化的链接页面 |
| 是否积累 | 否,每次都是一次性检索 | 是,复利增长 |
| 质量控制 | 靠 embedding 质量 | 模型主动整理、去重、交叉链接 |
Karpathy 的原话(agricidaniel 转述):
你把源文档索引到 raw/,然后用 LLM "编译"出一个 wiki:一组 .md 文件,带摘要、反链,按概念分类,文章之间互相链接。
关键在那个"编译"。RAG 是每次提问都重新检索,结果零散、不积累。LLM Wiki 是把源一次性加工成结构化页面,之后这些页面自己就成了知识,越加越多,复利增长。
打个比方:RAG 像每次去图书馆按关键词找书,找完就忘;LLM Wiki 像有个馆员帮你把书读完、写成卡片、按主题归类、互相标注关联,下次你直接看卡片柜。
四、工作流:编译、复利、自愈
整个系统的运转分三步:
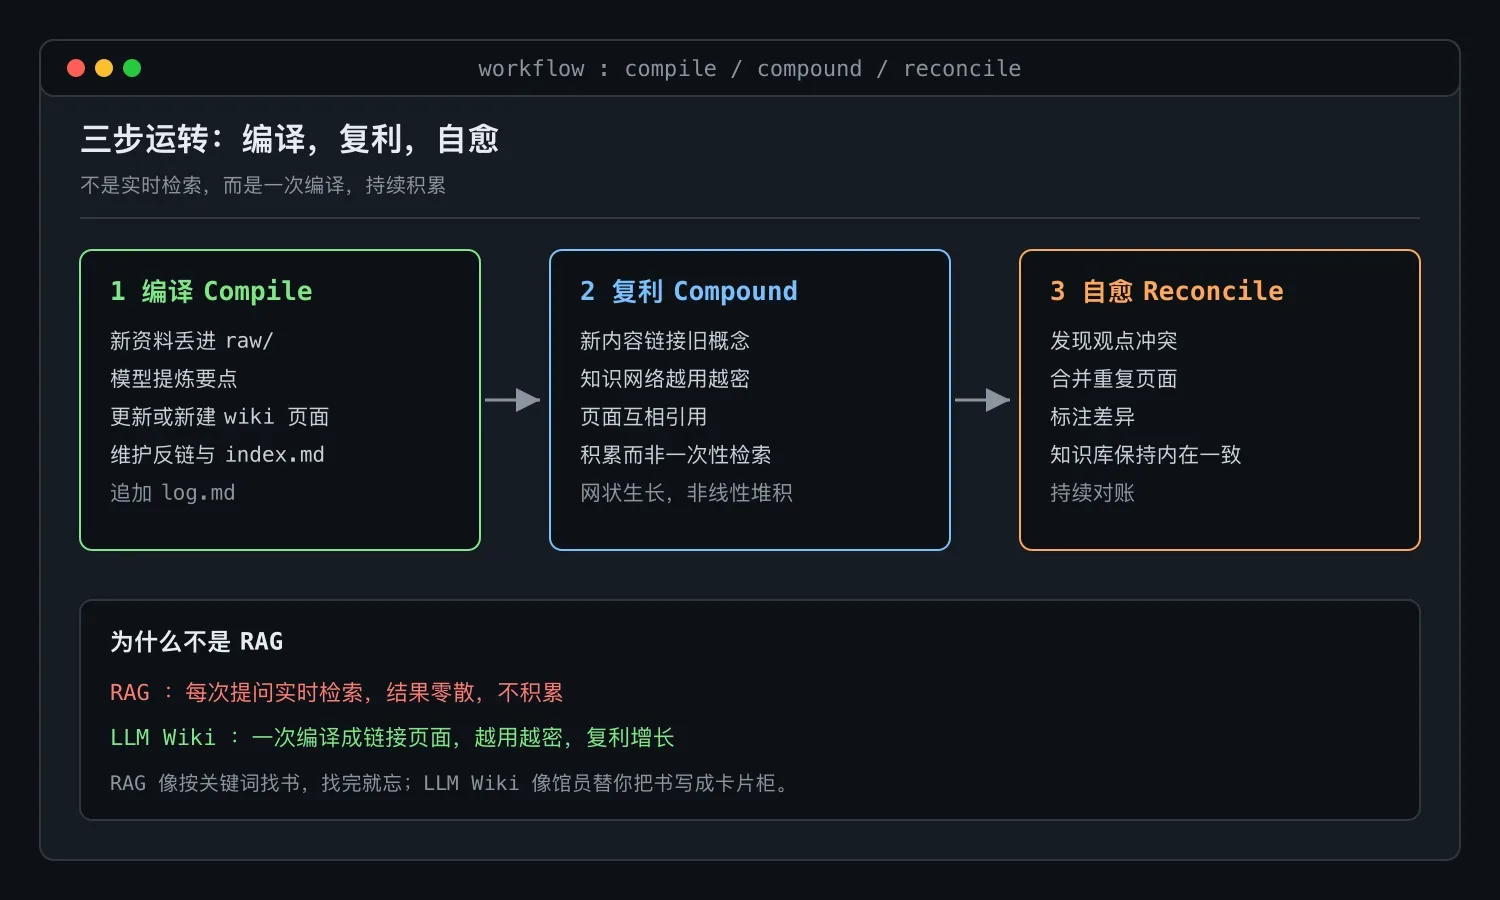
1. 编译(Compile)
你往 raw/ 丢新东西(一篇文章、一个 PDF、一段会议转录)。然后告诉 Claude:
"我往 raw/ 加了新内容,请更新 wiki。"
Claude 会:读新资料,提炼要点,看现有 wiki 有没有相关页面,要么更新已有页面,要么新建,维护反链,更新 index.md 和 log.md。
2. 复利(Compound)
这是最神奇的部分。因为 wiki 是结构化的链接页面,每次新增内容,都会让原有的知识网络更密。今天加的一篇文章,可能和三个月前存的某个概念产生关联,Claude 会主动建立这个链接。
Moysei 推文那句 "Your sources compile once into linked pages and compound from there",说的就是这个意思。知识不是线性堆积,而是网状生长。
3. 自愈(Reconcile)
更厉害的是对账(reconcile)。当两篇资料观点冲突、或同一概念被分散在多个页面时,Claude 会主动发现并合并、标注差异。这解决了知识库的"碎片化"和"自相矛盾"问题:模型在持续地让你的知识库保持内在一致。
五、会话记忆:log.md 让每次对话都"接着上次"
文章里提到一个细节:每天早上 7 点,vault 会自动"把自己归档好"。背后靠的是 log.md,它会记录:
- 上次会话你在做什么
- 做了哪些关键决策及理由
- 最近创建/更新了哪些 wiki 页面
- 你提过的开放问题和下一步
有篇分析提到:读这个 log.md 大概消耗 500 token,不到 Claude 上下文窗口的 0.25%,但能省掉每次重新建立上下文要花的 2000-3000 token。4-6 倍的回报。
这和 agentic 编程工具里常说的 context rot(上下文腐烂)是对症的:与其让上下文无限膨胀,不如用一个小的 log.md 在每次会话开始时快速恢复上下文。
六、Moysei 总结的 9 条规则(核心纪律)
Moysei 推文提到 "9 rules. Start with 10 sources, not 10,000"。综合多份教程,这套方法的核心纪律可以归纳为:
- raw 神圣不可侵犯:模型只读 raw,绝不修改你的原始资料
- wiki 是模型的工作区:它自由写、更新、重构
- 不用 RAG,用编译:一次性加工,之后复利
- 从 10 个源开始,不是 10000 个:少而精,先跑通流程
- 每加新内容,触发编译:不是实时检索,是增量更新
- 反链和分类由模型维护:人不用手动链接
- log.md 维持会话连续性:每次开会话先读它
- index.md 是页面目录:模型知道自己有什么
- 人保留判断,模型记账:你决定什么值得存、问什么问题
第 4 条尤其重要:"Start with 10 sources, not 10,000"。这是对"囤积癖"的直接反击。大多数人的 vault 之所以死,就是因为一上来就导入几千条,结果什么都没整理好。Karpathy 的建议反过来:先从 10 个你最在意的源开始,把流程跑通、把 wiki 结构搭好,再逐步扩充。
七、怎么落地:三步上手
第 1 步:装 Obsidian + Claude Code
- Obsidian(免费):当 vault 前端
- Claude Code(或 Codex / 任何带 shell 的 agent):当维护引擎
第 2 步:建 vault 目录
按上面的结构建 raw/、wiki/,写一个 CLAUDE.md 定义规则。或者直接用现成的:GitHub 上有好几个开源 starter(比如 eugeniughelbur/obsidian-second-brain,跨 Claude Code/Codex/Gemini 通用)。
第 3 步:丢 10 个源进去,让 Claude 编译
挑你最近最在意的 10 篇文章/笔记/PDF,丢进 raw/,然后对 Claude 说:"读 raw/ 里的内容,编译成 wiki。"看它怎么提炼、怎么链接、怎么分类。
之后每次加新内容,重复这个动作。坚持一周,你会看到一个会自己生长的知识网络。
八、为什么这套方法值得认真对待
拆完整个方法,它最值得学的有三点:
第一,它找到了"维护成本"这个真问题。 之前所有第二大脑方法(PARA、Zettelkasten)都假设用户会持续手动维护,但人不会。Karpathy 把维护交给模型,从根本上解决了"vault 变坟场"的宿命。
第二,它坚持 raw 不可变。 这个设计极其克制。原始资料是真相源,模型只能在它自己的 wiki 里加工,不能动你的原始数据。这保证了可追溯性:任何时候你都能回到 raw 看原始内容,wiki 只是"当前最佳理解"。
第三,它用"编译+复利"对抗"检索+遗忘"。 RAG 是一次性的,LLM Wiki 是积累的。前者像查字典,后者像养一个会自动整理的图书馆。长期看,后者的知识密度远高于前者。
九、它适合谁,注意什么
适合你,如果:
- 你已经用 Obsidian(或想用),但 vault 一直处于"囤而不整"状态
- 你有大量文章/笔记/PDF/会议记录,但它们彼此不链接
- 你愿意让 AI 介入你的知识管理(而不是纯手动)
- 你想要一个"越用越聪明"而非"越用越乱"的系统
注意几点:
- 需要 Claude Code 或类似的 agentic 工具:纯 ChatGPT 网页版做不了文件级操作
- 前期要调 CLAUDE.md:规则定义得好坏,直接决定 wiki 质量
- 不是零成本:每次编译要消耗 token,但相比 RAG 长期看更省
- raw 的质量决定一切:垃圾进,垃圾出。第 4 条"从 10 个源开始"就是为了逼你筛源
十、一个更广的信号
Karpathy 这套方法并非孤例,过去一年大量 AI 工具实践都在指向同一个趋势:
AI 不只是帮你"找信息",它在帮你"结构化地持有信息"。
- AGENTS.md、CLAUDE.md 这类项目规则文件,让 AI 一进仓库就记住项目约定
- 会话日志与复盘机制,让 AI 每次开工都接着上次的进度
- Karpathy 的 LLM Wiki 走得更远,让 AI 直接维护你的整个个人知识库
它们共享同一个内核:把"维护"这件事,从人挪到 AI;把"判断"这件事,留在人手里。
Moysei 推文最后那句总结很到位:
Most people hoard notes. This turns them into a brain that maintains itself.
(大多数人囤笔记。这套方法把囤积,变成一个会自我维护的大脑。)
如果你的 vault 正在变成坟场,不妨试试 Karpathy 这套:别再一个人扛维护了,把它交给一个不知疲倦、擅长链接的模型。
本文整理自 Moysei 在 X 上分享的 LLM Wiki 方法,转述 Andrej Karpathy 的思路;方法细节经 agricidaniel.com、TheToolNerd 与 Medium 多份独立教程交叉核实。开源 starter 可参考 GitHub 仓库 eugeniughelbur/obsidian-second-brain。