字节笔记本
2026年11月7日 · 约 3 分钟读完
两兄弟 2.1 万美元训出图像模型,权重全开源
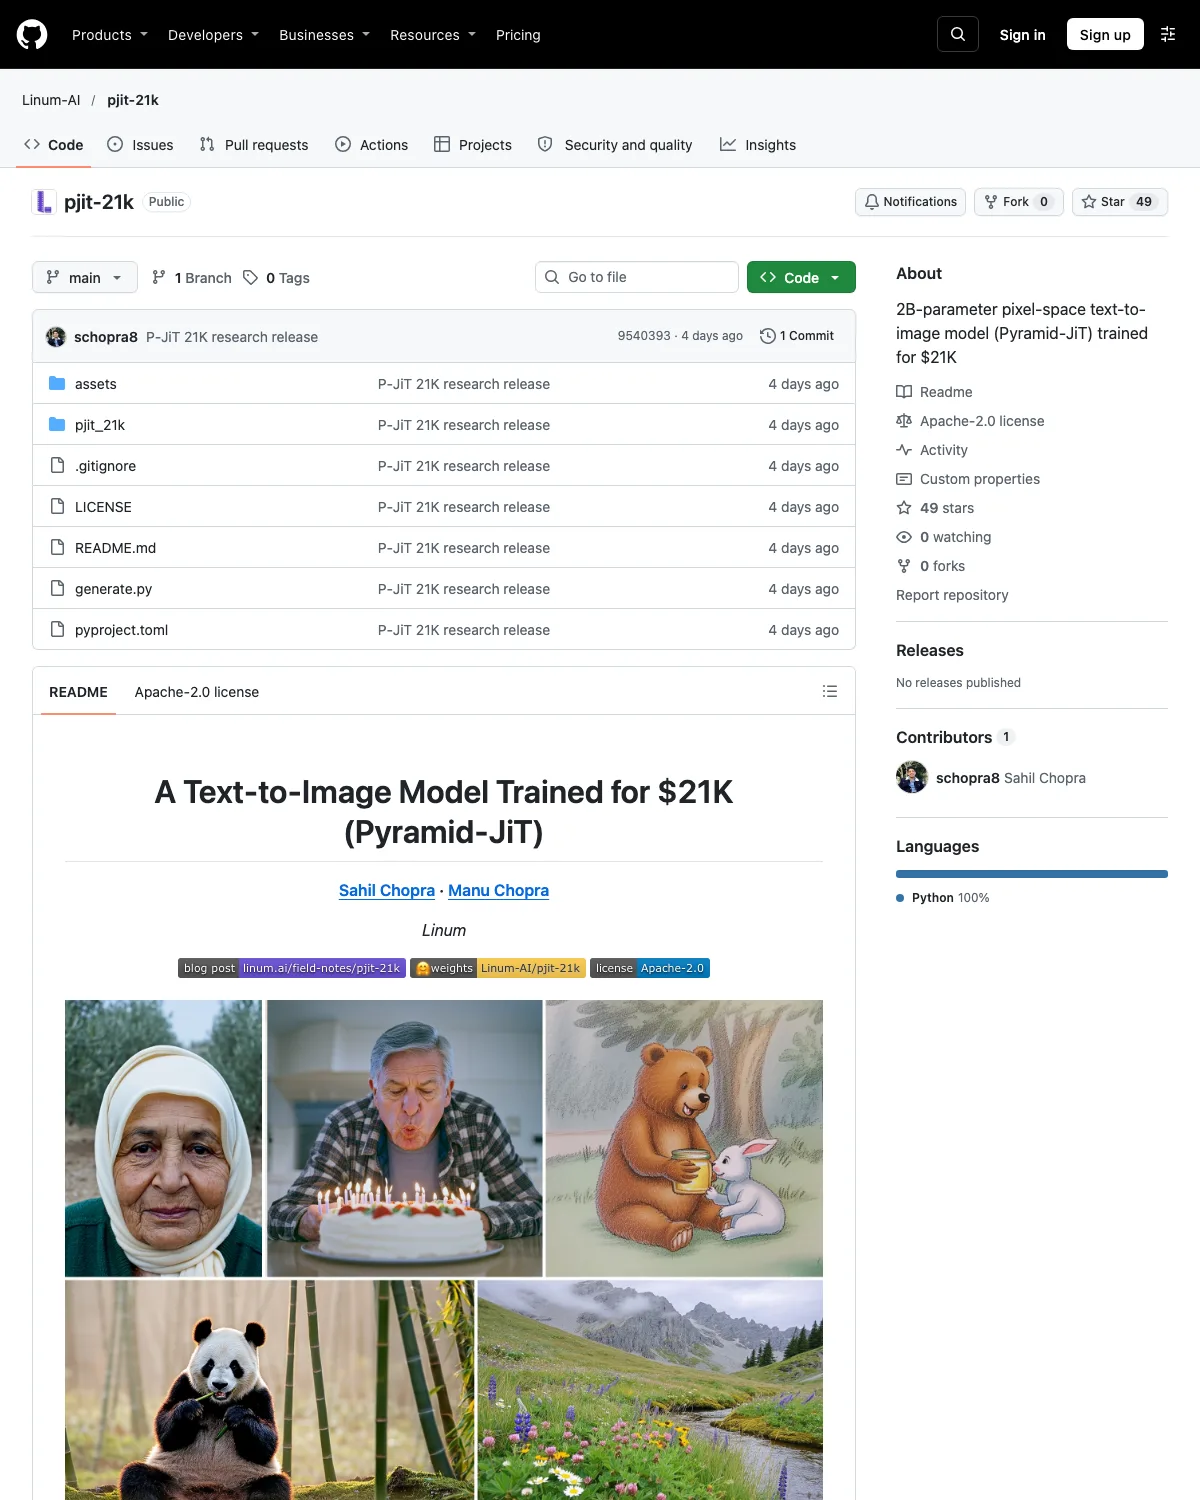
Show HN 上 11 月 6 日 267 分的一个发布:Linum——Sahil 与 Manu Chopra 两兄弟的小实验室,从零训练生成式视频与图像模型——发布了 P-JiT 21K:一个 2B 参数(21.8 亿参数,fp32 权重文件 8.7GB)的像素空间文生图模型,Apache 2.0,代码与权重全部开源。
2.1 万美元是什么口径
训练算力花费约 21,038 美元,共处理 6.6 亿样本(512 像素 6.1 亿 + 1024 像素 5000 万)。注意这只是算力成本,不是两兄弟的全部投入。架构是他们此前提出的 Pyramid-JiT:作者称该架构把注意力上下文窗口缩 4 倍、收敛所需样本少 11 倍——这次发布本身就是这套主张的压力测试。
定位要听作者自己的话
标题里作者写的是 "a decent text-to-image model"(一个还不错的文生图模型),并作为研究检查点发布,不是生产模型。文本编码器是冻结的 Qwen3.5-4B(需另行下载),附 249 张样图画廊。局限也写得很诚实:画不出可读文字——含渲染文字的数据(信息图、PDF、书页、幻灯片、海报)被有意过滤掉了,因为实验室的目标是做动画工具;2B 像素空间扩散模型打不过前沿潜空间模型;249 张精选图是演示,不是评测。
真正的目标是视频
这个图像模型是 Linum 正在做的生成式视频模型的垫脚石:如果"11 倍样本效率"在自家管线之外也成立,两人小实验室做视频模型才变得可行——这才是这个 Show HN 帖子真正的赌注。
判断
对关注"训练成本曲线"的人,这篇的信号是:文生图模型的入场门槛已经降到了个人合伙人的支票能覆盖的量级——前提是你接受"还不错的"质量、避开文字渲染、且只当研究检查点用。三点校准:① 别写成"打败前沿模型",作者自己都没这么说;② 11 倍样本效率是作者主张,待第三方验证;③ Apache 2.0 全开源 + 8.7GB fp32 权重,想验的门槛是真的低。