字节笔记本
2026年10月6日 · 约 43 分钟读完
模型微调入门:LoRA 与 QLoRA 原理与实战
本文是《AI 工作流工程师》系列的一篇,主题是模型微调。翻翻"AI 工作流工程师"的招聘 JD,加分项里大概率有这么一行:"有模型微调(LoRA / QLoRA)实践经验者优先"。很多人一看到就慌:微调?那不是算法工程师天天训模型的事吗?
先吃颗定心丸:AI 工作流工程师通常不需要"从头训大模型",那是烧几千万、几千张卡的预训练团队的事。但你应该懂原理、会跑一次基础微调:当你手头有个"通用大模型回答得不够稳、不够便宜、不够有公司味儿"的业务时,微调往往是最优解。
本篇用小白能听懂的方式,把"微调是什么、什么时候该调、为什么都在用 LoRA / QLoRA、怎么用 unsloth 在一张消费级显卡上跑完一次完整微调"全部讲透。代码基于 2025 年最新的 unsloth API(FastLanguageModel + SFTTrainer + SFTConfig),可直接复制进 Colab 运行。
本篇你将学到:
- 微调的本质,以及它和"预训练、SFT、RLHF"训练三阶段的关系
- 什么时候该微调、什么时候千万别微调(这条比上一条更重要)
- 全参数微调 vs LoRA vs QLoRA 的核心差异与显存账本
- LoRA"低秩矩阵"为什么有效的小白版数学直觉
- 用 unsloth 微调 Qwen3 / Llama 的完整可跑代码
- LoRA 超参(r / alpha / target_modules)怎么选
- 怎么评估微调效果,怎么部署(合并 / GGUF / vLLM)
- 灾难性遗忘、过拟合、学习率崩坏三大常见坑
一、什么是微调:新员工入职培训
生活类比
想象一家公司招了个新人。这个新人可不是白纸一张:他先在大学读了 4 年计算机(学的是通用知识:数据结构、操作系统、计算机网络),毕业了是个"懂点门道但啥具体业务都不会"的应届生。这时候公司给他安排了为期两周的岗前培训:学公司的代码规范、用公司的内部系统、熟悉公司的业务流程。两周后,他就能上手干活了。
- 大学 4 年 = 预训练(Pre-training):花大力气学通用知识,成本极高(公司养一个大学生要 4 年),但学完后是"通用人才"。
- 岗前培训 2 周 = 微调(Fine-tuning):用少量、针对性的数据,把通用人才改造成"公司专属人才",成本低、见效快。
- 你不会因为要让新人学会用公司系统,就让他重新去读 4 年大学,你只会给他培训。微调就是这个道理。
专业定义
放进大模型训练的三阶段(预训练 → SFT 监督微调 → RLHF)里看:
微调(Fine-tuning)= 在一个已经预训练好的"基座模型"(Base Model)上,用一份面向特定任务的小数据集继续训练,让模型在保留通用能力的同时,更适合某个具体任务/领域/风格。
SFT 和 RLHF 本质都属于"广义微调"。本篇讲的是更具体的工程场景:你拿到一个已经 SFT+RLHF 过的开源模型(比如 Qwen3-8B-Instruct),再用你自己的业务数据,再微调一次,让它变成"你公司的专属模型"。
举个最直观的例子:
基座模型 Qwen3-8B-Instruct,你问它:
  "把这段会议纪要转成 JSON"
它可能回一段啰嗦的解释 + JSON,格式不固定。

你用 500 条"会议纪要 → 标准 JSON"的数据微调后:
同样的问题,它直接吐一段干净 JSON,零废话,token 少了一半。这就是微调最常见、最值钱的价值:让模型的行为稳定下来,贴合你的格式/风格/术语。
二、什么时候该微调?(更重要的是:什么时候不该)
这是整篇最值钱的一节。太多团队"为了微调而微调",花两周训出的模型效果还不如改两行 Prompt。微调不是银弹,有明确的适用与不适用场景。
2.1 该微调的 3 种场景
场景 A:固定语气 / 风格 / 输出格式
你的客服机器人要求所有回复必须"先道歉、再给方案、最后祝您生活愉快"。这种高度固定的风格,用 Prompt 每次啰嗦一堆还容易漂;微调后模型"内化"了这个风格,Prompt 可以写得很短。
场景 B:特定领域的术语 / 行话 / 黑话
医疗、法律、金融、电商黑话……通用模型经常"听不懂"。比如把"白嫖""种草""拔草"这类电商黑话喂进模型,微调后它就懂了。
场景 C:用小模型 + 微调替代大模型,降成本
这是最务实的微调理由。GPT-4 调一次 API 要钱,用一个微调过的 Qwen3-1.7B 跑在自家 GPU 上,成本可能只有 1/50,延迟更低、数据不出门。分类、抽取、改写类任务,微调小模型完全够用。
2.2 千万别微调的 3 种场景(重要)
误区一:想给模型"补知识",应该用 RAG,不要微调
这是最大的误区。很多人以为"微调能让模型学会公司文档"。理论上能,但工程上几乎没人这么干:模型参数有限,塞进去的知识会"忘"、会和别的知识打架、产生幻觉,而且知识一更新就得重训。补知识请用 RAG(检索增强生成):文档放进向量库,检索出来塞进 Prompt。RAG 的知识是"外挂硬盘",随时可换;微调的知识是"刻进脑子",改一次脱层皮。
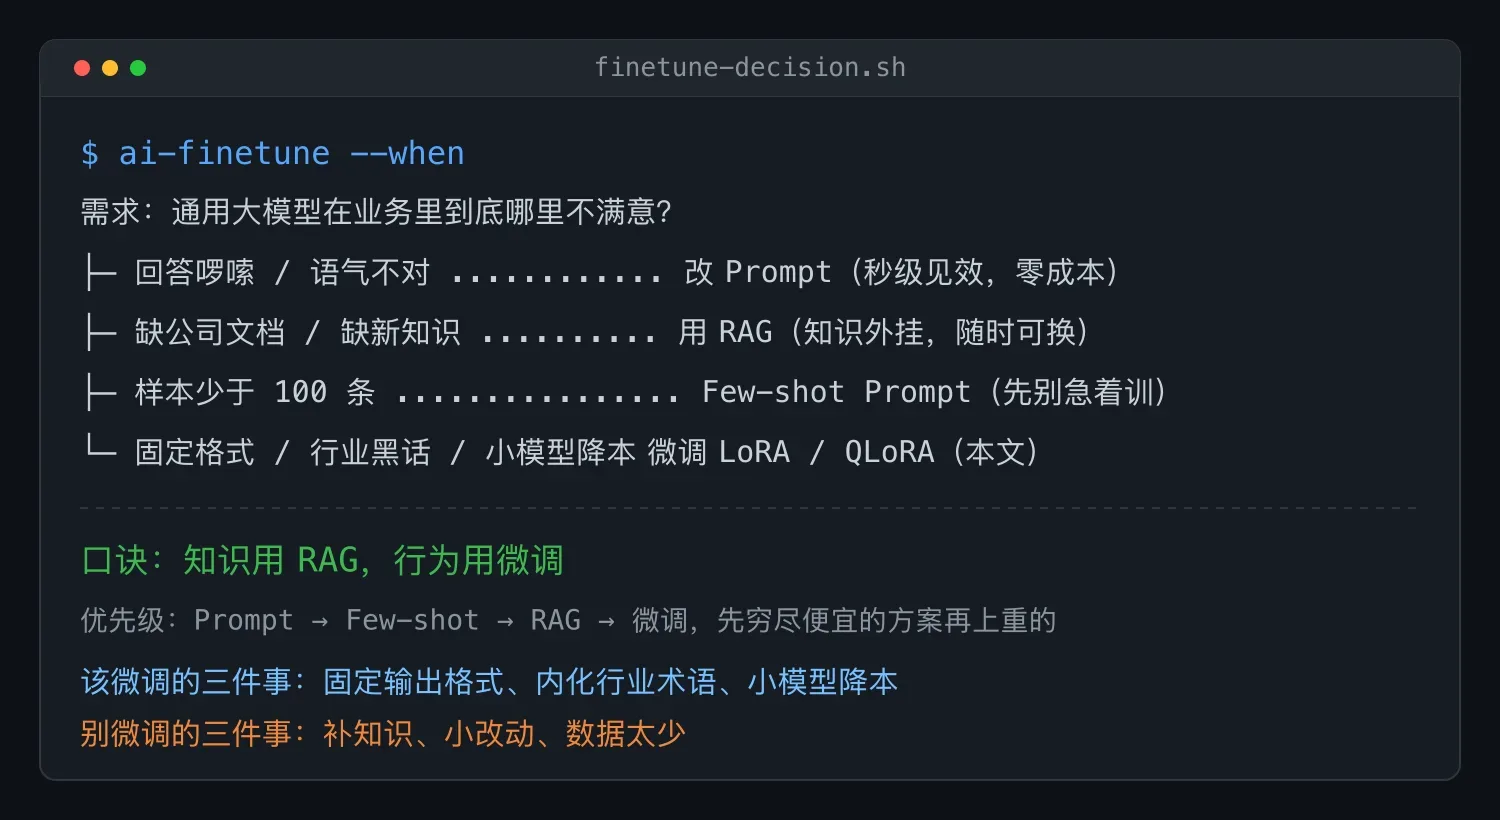
一句话口诀:知识用 RAG,行为用微调。
误区二:只想改一点点行为,改 Prompt 就够
需求是"回答短一点""加免责声明""换个语气",99% 改 Prompt 就够了,几秒见效。微调是重型武器,别用大炮打蚊子。
误区三:数据太少(少于 100 条),别微调
微调本质是让模型从数据里学规律。数据太少,要么学不到东西,要么直接"背题"(过拟合),换个输入就崩。经验门槛:少于 100 条用 Few-shot Prompt;少于 500 条慎重微调;1000 条以上高质量数据微调才稳。
2.3 一张决策表:选 Prompt / RAG / 微调?
| 你的真实需求 | 该用什么 | 理由 |
|---|---|---|
| 让模型知道公司最新文档、产品手册 | RAG | 知识易更新、可追溯、不幻觉 |
| 让回答短一点 / 加免责声明 / 换语气 | Prompt | 几秒见效,零成本 |
| 固定输出格式(永远吐 JSON) | 微调 | 行为固化,省 token |
| 学会公司黑话、行业术语 | 微调 | 术语需要内化 |
| 用小模型替代 GPT-4 降本 | 微调 | 性价比之王 |
| 数据只有 50 条 | Few-shot Prompt | 数据太少微调会过拟合 |
小白避坑提醒:先穷尽 Prompt + RAG,效果还不够再考虑微调。这是工业界公认的"性价比顺序":Prompt → Few-shot → RAG → 微调。
三、全参数微调 vs LoRA vs QLoRA
假设你已经判断"这事儿真得微调"。接下来要回答第二个问题:怎么调? 这里有三种主流方法,差别大到决定你"能不能跑得动"。
3.1 全参数微调(Full Fine-tuning)
做法:把模型的所有参数都解开,全部参与训练。
优点:效果天花板最高,能改的东西最多。
缺点:贵到离谱。7B 模型全参数微调,光是 optimizer 状态 + 梯度 + 模型本身,至少要 80–120GB 显存,得用 A100 80G 或 2–4 张 4090。消费级 8G/12G 显卡想都别想。训完模型和原模型一样大(7B 还是 7B),存储部署成本不变。
3.2 LoRA(Low-Rank Adaptation):本篇主角
做法:冻结原模型所有参数,只在每个权重矩阵旁边"加一对小矩阵 A 和 B"(叫 LoRA 适配器),只训练这对小矩阵。原模型一个参数都不动。
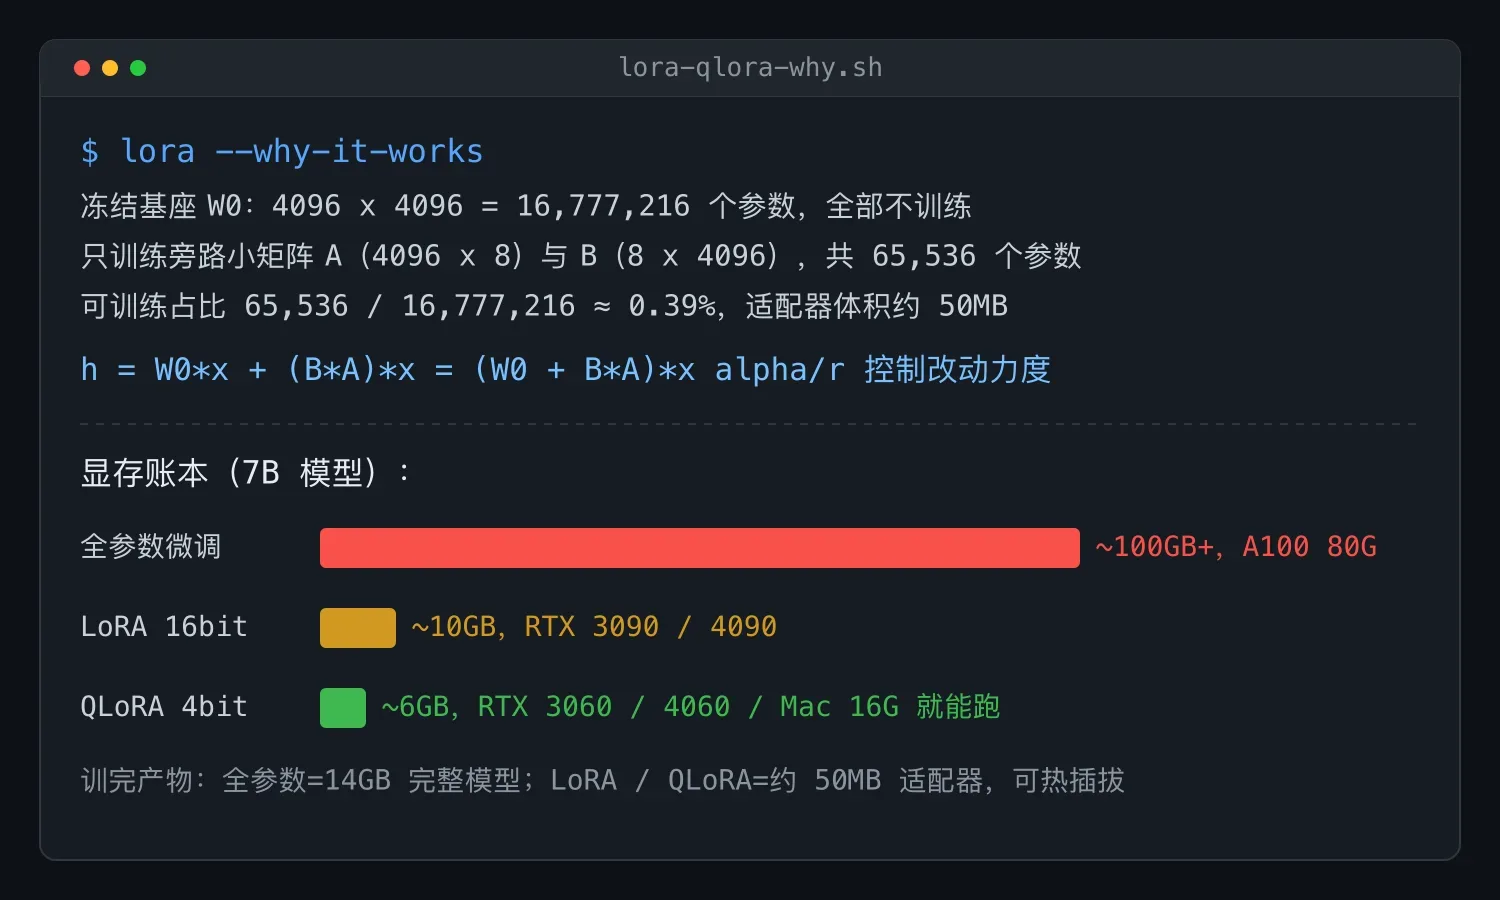
核心洞察:研究表明,模型微调时权重的变化量(ΔW)是"低秩"的。虽然 W 是 4096×4096 的大矩阵(1600 万个数),但真正有用的变化可由两个小矩阵的乘积 BA 近似:B 是 4096×8、A 是 8×4096,加起来才 6.5 万个数,是原来的 0.4%。
优点:显存暴降(7B 模型 LoRA 只要 ~10GB),训出来的 LoRA 适配器只有几十 MB,可随时插拔切换。效果接近全参数微调的 95%+。
缺点:对"学大量新知识"的任务,上限略低于全参数。
3.3 QLoRA:消费级显卡的救星
做法:LoRA + 4bit 量化。把那个被冻结的大模型本身,从 16bit 压缩到 4bit 存储(体积缩小 4 倍),LoRA 小矩阵仍然用 16bit 训练。
优点:7B 模型 QLoRA 只要 ~6GB 显存,一张 RTX 3060 / 4060 / Mac 16G 都能跑,是"人人都能微调"的技术基石。
缺点:相比 LoRA 16bit 会有 1–2% 的精度损失(unsloth 的动态 4bit 量化已基本弥补了这个差距)。
3.4 显存账本(以 7B 模型为例)
| 方法 | 7B 模型显存 | 训完产物大小 | 效果 | 硬件门槛 |
|---|---|---|---|---|
| 全参数微调 | ~100GB+ | 14GB(整个模型) | 最高 | A100 80G / 多卡 |
| LoRA (16bit) | ~10GB | ~50MB(仅适配器) | 接近全参数 | RTX 3090 / 4090 |
| QLoRA (4bit) | ~6GB | ~50MB + 4bit底座 | 略低 1–2% | 消费级显卡 |
结论:个人学习、Colab 白嫖,无脑选 QLoRA。企业级追求极致效果且有 A100,可上 LoRA 16bit 或全参数。本篇代码全程用 QLoRA。
四、LoRA 为什么有效:低秩近似的小白直觉
这一节用最朴素的方式讲清 LoRA 的数学直觉,不要求你懂线性代数。
4.1 生活类比:装修出租屋
你租了套老房子(= 预训练好的大模型 W₀),房东规定承重墙不许动(= 原模型参数冻结)。但你想让它更适合自己住(= 适应新任务)。怎么办?
- 全参数微调 = 把房子拆了重建。效果好,但要花 100 万,房东还不让。
- LoRA = 不动承重墙,只在墙上贴壁纸、挂画、摆家具(= 加一对小矩阵 BA)。花 5000 块,房子立刻有你的风格。
关键在于:贴壁纸挂画这种"表层改动",足以让房子的"使用体验"大变样,但根本不需要动结构。LoRA 就是发现了:模型微调时,真正有效的改动都发生在"表层",可以用很低维度的信息描述。
4.2 数学直觉(一句话版)
原模型权重矩阵 W₀ 是个超大矩阵。微调会让它变成 W₀ + ΔW。研究发现,这个 ΔW 虽然也很大,但它的"有效信息"集中在一个低维子空间里,可以写成两个"瘦长"矩阵的乘积 ΔW ≈ B × A,其中 A、B 的内维度 r 很小(比如 8 或 16)。
举个数字感受一下(Qwen3-8B 的某一层):
W₀ : 4096 × 4096 = 16,777,216 个数(全部冻结)
A  : 4096 × 8    =     32,768 个数(训练)
B  :    8 × 4096 =     32,768 个数(训练)
                            --------
可训练参数只有原来的  65,536 / 16,777,216 ≈ 0.39%
99.6% 的参数都被冻结了,只在训练 0.4%,这就是 LoRA 省显存的根本原因。而 r 越大(比如 64),可训练参数越多,表达能力越强,但越接近全参数,也就越费显存、越容易过拟合。
4.3 为什么 α(alpha)是缩放因子?
实际计算时,BA 的结果会乘以一个系数 α/r(alpha 除以 rank)。α 控制 LoRA 改动的"力度":α 越大,微调对原模型行为的影响越强。经验法则:α 通常设为 r 的 2 倍(r=8 → α=16;r=16 → α=32)。后面给推荐配置表。
五、微调数据准备:数据决定效果上限
行业里有句话:"Garbage in, garbage out"(垃圾进,垃圾出)。微调效果 70% 取决于数据质量,模型架构、超参数都是次要的。
5.1 两种主流数据格式
格式一:Alpaca 格式(指令式,适合单轮任务)
{
  "instruction": "把下面的会议纪要转成结构化 JSON",
  "input": "张三说下周二开评审会,李四负责准备材料...",
  "output": "{\"event\":\"评审会\",\"time\":\"下周二\",\"owner\":\"李四\"}"
}三列:instruction(要干嘛)+ input(具体内容)+ output(期望输出)。适合"输入→输出"的明确任务。
格式二:ShareGPT 格式(对话式,适合多轮对话 / 客服机器人)
{
  "conversations": [
    {"from": "human", "value": "我的订单还没到怎么办?"},
    {"from": "gpt",   "value": "很抱歉给您带来不便,请提供订单号..."},
    {"from": "human", "value": "订单号是 12345"},
    {"from": "gpt",   "value": "已为您查询,订单正在派送中..."}
  ]
}
适合做客服、聊天机器人这种多轮场景。unsloth 都支持,会自动套用对应 chat template。
5.2 数据质量 > 数量(重要)
新手最常犯的错:"我搞了 10 万条数据,肯定训得好!",错。10 万条质量参差的数据,效果远不如 1000 条人工精修的数据,因为模型会学脏数据里的坏模式,越训越歪。
高质量数据标准:
- 答案正确:output 必须是对的。错答案会直接教坏模型。
- 格式统一:要么都吐 JSON,要么都吐自然语言,别混。
- 多样性:覆盖各种输入场景,别 1000 条都是"翻译 hello"。
- 长度合理:太长(超过 4096 token)训得慢还易过拟合,太短学不到东西。
5.3 数据清洗 Checklist
# 一个最小的数据清洗脚本(伪代码思路)
def clean_dataset(samples):
    cleaned = []
    for s in samples:
        # 1. 去重(按 input 哈希)
        # 2. 过滤空 output / output 太短(< 5 字)
        # 3. 过滤超长样本(token > 2048)
        # 4. 过滤乱码、特殊字符
        # 5. (可选)用 GPT-4 给每条打分,只留高分
        if is_valid(s):
            cleaned.append(s)
    return cleaned
一个真实经验:用 GPT-4 / Claude 帮你生成 + 清洗合成数据,是 2025 年最主流的做法。先写 50 条"种子样例",让大模型照着扩到 2000 条,再人工抽检 100 条,比纯人工标注快 10 倍,质量也够用。
六、用 unsloth 实战微调 Qwen3 / Llama(重点,代码可跑)
终于到实操了。我们用 unsloth,它是 2024–2025 年最易用、最快、最省显存的微调库(官方数据:比原生 PEFT 快 2 倍、显存少 50–70%)。下面是一份完整的、可在 Google Colab(免费 T4 GPU)或本地 RTX 3090/4090 上直接跑的代码。
6.1 为什么选 unsloth?
| 维度 | 原生 HF PEFT + TRL | unsloth |
|---|---|---|
| 速度 | 1x(基准) | 2x |
| 显存 | 基准 | 少 50–70% |
| 上手难度 | 要手写一堆配置 | 一个 FastLanguageModel 搞定 |
| GGUF 导出 | 要自己折腾 llama.cpp | 一行代码导出 Ollama |
| 适配新模型 | 慢半拍 | Qwen3 / Llama4 第一时间支持 |
6.2 第一步:安装
# Colab / Linux 本地(已装好 CUDA 12.x + Python 3.10+)
pip install "unsloth[cu121-torch260]" \
    "git+https://github.com/huggingface/transformers.git" \
"git+https://github.com/huggingface/trl.git"注意:unsloth 对 PyTorch / CUDA 版本敏感,安装命令以官方 github.com/unslothai/unsloth README 为准。Colab 里直接复制上面的命令即可。
6.3 第二步:加载模型(4bit QLoRA)
from unsloth import FastLanguageModel
import torch

max_seq_length = 2048  # 上下文长度,新手用 2048 就够

# 加载 Qwen3-8B 的 4bit 预量化版本(下载快、不 OOM)
model, tokenizer = FastLanguageModel.from_pretrained(
    model_name = "unsloth/Qwen3-8B-unsloth-bnb-4bit",
    max_seq_length = max_seq_length,
    load_in_4bit = True,        # 重点:开启 4bit 就是 QLoRA;False 则是 16bit LoRA
    load_in_16bit = False,
    # token = "hf_xxx",         # 用 gated 模型时填 HuggingFace token
)
想换 Llama?把 model_name 换成 "unsloth/Llama-3.1-8B-Instruct-unsloth-bnb-4bit" 即可,其余代码一个字都不用改。这就是 unsloth 的爽点。
6.4 第三步:挂上 LoRA 适配器
model = FastLanguageModel.get_peft_model(
    model,
    r = 16,                         # 秩,新手无脑用 16
    target_modules = [              # 在哪些层加 LoRA,下面这 7 个是"全家桶"
        "q_proj", "k_proj", "v_proj", "o_proj",
        "gate_proj", "up_proj", "down_proj",
    ],
    lora_alpha = 32,                # 缩放系数,通常 = 2 × r
    lora_dropout = 0,               # 0 最快;想抗过拟合可设 0.05
    bias = "none",
    use_gradient_checkpointing = "unsloth",  # unsloth 模式再省 30% 显存
    random_state = 3407,
    max_seq_length = max_seq_length,
    use_rslora = False,             # rank stabilized LoRA,进阶可开
)
跑完会打印"可训练参数 / 总参数"的比例,你会看到 ~0.3%–1% 这个量级,这就是 LoRA 的魔力。
6.5 第四步:准备数据
这里用 Alpaca 格式做演示。你也可以换成自己的业务数据。
from datasets import load_dataset
from unsloth.chat_templates import get_chat_template

# 用 Alpaca-GPT4 数据集做演示(5.2 万条指令对)
dataset = load_dataset("vicgalle/alpaca-gpt4", split="train")

# 套用 ChatML 模板(Qwen3 / Llama3 通用)
tokenizer = get_chat_template(
    tokenizer,
    chat_template = "chatml",   # 也可选 "alpaca" / "llama-3" / "qwen-3"
)

def formatting_prompts_func(examples):
    convos = []
    for inst, inp, out in zip(
        examples["instruction"], examples["input"], examples["output"]
    ):
        # 拼成 user / assistant 一轮对话
        user_msg = inst + ("\n" + inp if inp else "")
        convos.append([
            {"role": "user",      "content": user_msg},
            {"role": "assistant", "content": out},
        ])
    texts = [
        tokenizer.apply_chat_template(c, tokenize=False, add_generation_prompt=False)
        for c in convos
    ]
    return {"text": texts}

dataset = dataset.map(
    formatting_prompts_func,
    batched=True,
    num_proc=4,        # 多进程加速;Colab 上 OOM 就改成 1
)用你自己的数据:只要把数据存成上面的 Alpaca 或 ShareGPT JSON,用 load_dataset("json", data_files="my_data.json") 加载即可。
6.6 第五步:配置训练器并开跑
from trl import SFTTrainer, SFTConfig

trainer = SFTTrainer(
    model = model,
    tokenizer = tokenizer,
    train_dataset = dataset,
    args = SFTConfig(
        max_seq_length = max_seq_length,
        per_device_train_batch_size = 2,   # 显存不够就降到 1
        gradient_accumulation_steps = 4,   # 等效 batch_size = 2×4 = 8
        warmup_steps = 10,                 # 学习率预热
        max_steps = 60,                    # 新手先用 60 步试水;正式跑用 num_train_epochs=1~3
        learning_rate = 2e-4,              # LoRA 常用 1e-4 ~ 3e-4
        fp16 = not torch.cuda.is_bf16_supported(),
        bf16 = torch.cuda.is_bf16_supported(),
        logging_steps = 1,                 # 每步打印 loss
        optim = "adamw_8bit",              # 8bit 优化器再省显存
        weight_decay = 0.01,
        lr_scheduler_type = "cosine",
        seed = 3407,
        output_dir = "outputs",
        report_to = "none",                # 不接 W&B;想监控可设 "wandb"
    ),
)

trainer.train()
跑起来你会看到类似这样的输出(loss 应该稳步下降):
{'loss': 1.85, 'grad_norm': 0.72, 'learning_rate': 1.95e-04, 'epoch': 0.01}
{'loss': 1.62, ...}
{'loss': 1.41, ...}
...
{'loss': 0.88, ...}   # 60 步后稳定在 0.8–1.0 区间,正常
6.7 第六步:测一下效果
# 切到推理模式(unsloth 推理也快 2 倍)
FastLanguageModel.for_inference(model)

messages = [{"role": "user", "content": "帮我用一句话介绍 RAG"}]
inputs = tokenizer.apply_chat_template(
    messages, tokenize=True, add_generation_prompt=True, return_tensors="pt"
).to("cuda")

outputs = model.generate(
    input_ids=inputs,
    max_new_tokens = 128,
    temperature = 0.7,
)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
对比一下微调前后的输出,你大概率能感觉到"风格更稳、格式更合你意"了。
七、LoRA 超参调优:推荐配置表
新手最头疼"r 设多少、alpha 设多少、训几个 epoch"。直接给你一张实战配置表,照抄即可。
| 超参 | 含义 | 推荐值 | 说明 |
|---|---|---|---|
r(秩) | LoRA 小矩阵的内维度 | 8 / 16 / 32 | 简单任务(分类、格式化)用 8;复杂任务(风格、术语)用 16–32;极少情况上 64+ |
lora_alpha | 缩放系数 | = 2 × r | r=8 → α=16;r=16 → α=32;r=32 → α=64 |
lora_dropout | 防过拟合 | 0(数据少时 0.05) | 0 最快;数据少于 1000 条可设 0.05 抗过拟合 |
target_modules | 在哪些层加 LoRA | 全家桶 7 个 | q/k/v/o + gate/up/down;省显存可只留前 4 个 |
learning_rate | 学习率 | 2e-4 | LoRA 标配;全参数微调用 1e-5(小一个数量级) |
epochs | 训几遍数据 | 1–3 | 数据多(超过 1 万)用 1;数据少(500–2000)用 3 |
batch_size | 每步样本数 | 2–8(含梯度累积) | 显存不够就降 per_device,加 gradient_accumulation |
max_seq_length | 最大序列长度 | 2048 | 长文本任务可上 4096/8192,但显存翻倍 |
一个万能起步配置(90% 的小项目都能用):
r=16, lora_alpha=32, lora_dropout=0,
target_modules=["q_proj","k_proj","v_proj","o_proj","gate_proj","up_proj","down_proj"],
learning_rate=2e-4, epochs=3, per_device_train_batch_size=2, gradient_accumulation_steps=4
八、评估微调效果:千万别只看 loss
模型训完怎么知道"到底变好了"?千万别只看 loss 下降,loss 下降只说明模型在"背训练集",不代表在新问题上也好。正确做法:准备一个 Golden Set(黄金测试集),即 20–100 条人工标注的标准答案,训练时绝不参与,训练前后都考一遍对比正确率/格式合格率。
# 伪代码:评估脚本
def evaluate(model, golden_set):
    scores = []
    for item in golden_set:
        pred = model.generate(item["input"])
        # 用规则或 LLM-as-Judge 打分
        score = grade(pred, item["reference"])
        scores.append(score)
    return sum(scores) / len(scores)

before = evaluate(base_model, golden_set)
after  = evaluate(finetuned_model, golden_set)
print(f"微调前: {before:.2%} → 微调后: {after:.2%}")指标怎么选:
- 格式类任务(吐 JSON):看"JSON 解析成功率""字段完整率"。
- 抽取类任务:看准确率 / 召回率 / F1。
- 开放生成:用 LLM-as-Judge(让 GPT-4 当裁判打分)或人工盲评。
合格标准:核心指标相比微调前应提升 5%–20%。提升不到 3%,说明数据不够好或任务不需要微调;暴涨到 50%+ 要警惕过拟合(务必再找新数据测)。
九、部署微调后的模型
训完的模型怎么用起来?有三种主流部署方式,对应不同场景。
9.1 方式 A:保存 LoRA 适配器(最省事)
# 只保存几十 MB 的 LoRA 适配器(不含底座)
model.save_pretrained("my_lora_adapter")
tokenizer.save_pretrained("my_lora_adapter")
之后用 vLLM / Ollama 时,底座 + LoRA 适配器分别加载,可热插拔。适合"一个底座挂多个业务 LoRA"的场景。
9.2 方式 B:合并成完整模型,转 GGUF 用 Ollama 跑(个人/本地首选)
# 1) 把 LoRA 合并进底座,存成 16bit 完整模型
model.save_pretrained_merged(
    "my_model_merged",
    tokenizer,
    save_method = "merged_16bit",
)

# 2) 直接导出 GGUF(配合 Ollama / llama.cpp 本地部署)
model.save_pretrained_gguf(
    "my_model_gguf",
    tokenizer,
    quantization_method = ["q4_k_m", "q8_0"],   # 4bit 体积小,8bit 精度高
)
导出后拿到 my_model_gguf-unsloth.Q4_K_M.gguf,接着用 Ollama 加载:
# 写个 Modelfile(Ollama 用)
echo 'FROM ./my_model_gguf-unsloth.Q4_K_M.gguf' > Modelfile
ollama create my-finetuned -f Modelfile
ollama run my-finetuned   # 你自己的专属模型跑起来了
9.3 方式 C:用 vLLM 部署(生产环境)
# 推到 HuggingFace Hub,再用 vLLM 起服务
model.push_to_hub_merged(
    "your-name/my-qwen3-finetuned",
    tokenizer,
    save_method = "merged_16bit",
    token = "hf_xxx",
)# 服务器上启动服务
vllm serve your-name/my-qwen3-finetuned \
--max-model-len 4096 \
--gpu-memory-utilization 0.9三种方式取舍:本地玩 / 隐私敏感 → GGUF + Ollama;线上并发服务 → vLLM;一个底座服务多业务 → LoRA 热插拔。
十、常见三大坑(小白必看)
坑 1:灾难性遗忘(Catastrophic Forgetting)
现象:微调后模型"变傻了":原来会写代码、会翻译,现在只会做你微调的那件事,通用能力退化。
原因:数据太单一、学习率太大、epoch 太多,把模型"原来的脑子"冲坏了。
对策:数据多样化(混入 10%–20% 通用对话防遗忘);学习率别超 3e-4;epoch 别超 3;用 Golden Set 测通用能力有没有掉。
坑 2:过拟合(Overfitting)
现象:训练 loss 降到接近 0,但模型在新输入上胡言乱语、或把训练答案原样背出。
对策:盯着验证 loss 曲线,一上升就 early stop;加 lora_dropout=0.05;降低 epoch。
坑 3:学习率崩坏
现象:loss 突然变成 NaN,或输出全是乱码(aaaaaaa)。
原因:学习率太大,权重爆炸。
对策:LoRA 学习率别超 5e-4;全参数微调用 1e-5 量级。一旦 NaN,立即降学习率重训。
一句话总结三大坑:学习率别贪大、数据别太单一、训练别太久。
小结
- 微调 = 在预训练基座上用小数据继续训练,让模型贴合特定任务,本质是"岗前培训"。
- 优先级:Prompt → Few-shot → RAG → 微调,别为了微调而微调。
- 三种方法:全参数(贵、效果最好)、LoRA(省、效果接近)、QLoRA(最省、消费级显卡能跑)。
- LoRA 原理:冻结原模型,只训练一对低秩小矩阵 BA,可训练参数仅 0.3%–1%。
- 数据 > 一切:1000 条高质量 > 10 万条垃圾,Alpaca / ShareGPT 两种格式。
- unsloth 是 2025 年最易用的微调库:
from_pretrained→get_peft_model→SFTTrainer三步搞定。 - 超参起步:r=16, alpha=32, lr=2e-4, epochs=3, 全家桶 target_modules。
- 评估用 Golden Set 对比前后,别只看 loss。
- 部署:LoRA 适配器 / 合并转 GGUF 跑 Ollama / vLLM 线上服务。
- 三大坑:灾难性遗忘、过拟合、学习率崩坏,口诀是"别贪大、别单一、别太久"。
动手练习
练习 1(入门,半小时):打开 unsloth 官方 Colab,跑通 Qwen3 微调 notebook,把输出截图下来,这是你简历上"有 LoRA 微调经验"的第一份证据。
练习 2(进阶,2 小时):找一个你熟悉的领域(比如你公司的客服问答、你常看的影评),用 GPT-4 生成 200 条 instruction/output 数据,微调一个 Qwen3-1.7B,导出 GGUF 用 Ollama 跑起来,对比微调前后的回答差异。
练习 3(思考题):如果你的业务是"让模型回答公司产品手册里的问题",你应该用 RAG 还是微调?为什么?如果改成"让模型用公司客服的口吻回答",又该用哪个?把理由写下来,这是面试高频题。
延伸阅读
- unsloth 官方文档:docs.unsloth.ai(最权威,跟版本走)
- unsloth GitHub:github.com/unslothai/unsloth(notebook 全在这里)
- LoRA 原论文:Hu et al., LoRA: Low-Rank Adaptation of Large Language Models, 2021(想懂原理必读)
- QLoRA 原论文:Dettmers et al., QLoRA: Efficient Finetuning of Quantized LLMs, 2023
微调是 AI 工作流工程师从"调 API"迈向"造专属模型"的分水岭:先穷尽 Prompt 与 RAG,确认真需求再动手,用 QLoRA 在消费级显卡上跑通第一次,你就拿到了 JD 里那句"有模型微调与本地部署经验"的入场券。系列后续将进入生产级工程化话题:模型上线之后,可观测性体系(日志、指标、链路追踪)就是 AI 工作流的"仪表盘和黑匣子",让你知道它在生产环境"到底跑得怎么样",这是从"能跑的 demo"迈向"敢上生产"的关键一跃。