字节笔记本
2026年10月7日 · 约 9 分钟读完
用一条正则链,把 Markdown 干净还原成纯文本
从 AI 对话窗口里复制一段回答,粘进微信或邮件,满屏都是星号、井号和竖线;把笔记里的段落贴进纯文本编辑器,** 和 | 有时比正文还多。Markdown 在渲染环境里是排版,离开渲染环境就是噪音。「剥掉标记、留住内容」这个需求小到不值得装软件,又大到值得认真做一次——一个单文件 HTML 工具就能把它解决得很漂亮。
为什么是单文件 HTML
这类小工具最怕「为了删几个星号先建一个 Node 项目」。单文件 HTML 是它的反面:零依赖、零构建、零安装,双击就能跑,断网也能跑,发给同事就是发一个文件。整个工具的核心只有两个函数,一个负责清理,一个负责复制,其余全是样式。也正因为小,每一条正则都值得推敲——这条链在三轮迭代里踩过的坑,比很多「正规」项目还典型。
清理流水线:十几条 replace
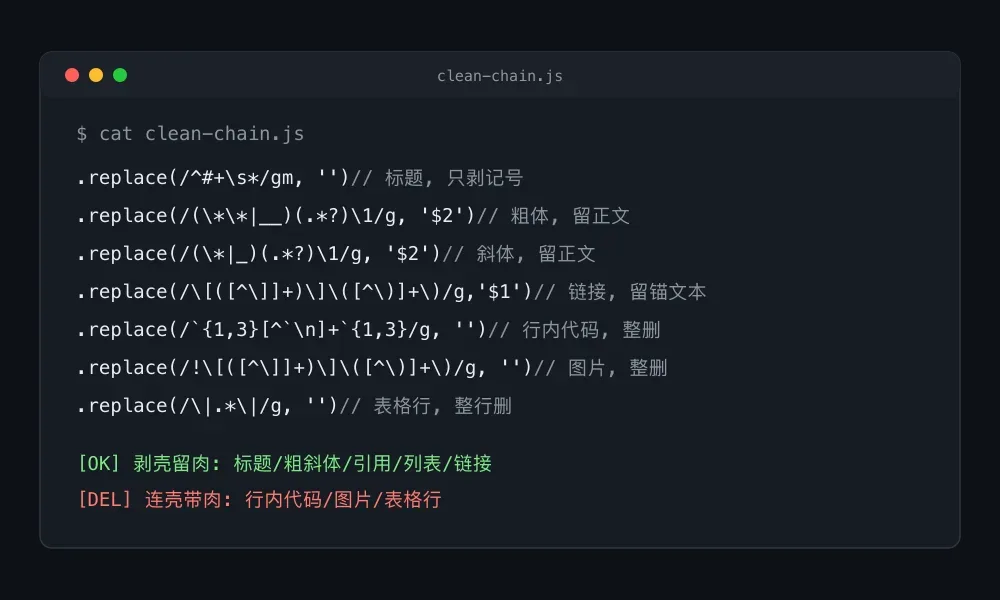
核心逻辑是一串链式 replace,每条规则对应一类 Markdown 语法:
let cleaned = input
  .replace(/^#+\s*/gm, '')                  // 标题,只剥记号
  .replace(/(\*\*|__)(.*?)\1/g, '$2')       // 粗体,留正文
  .replace(/(\*|_)(.*?)\1/g, '$2')          // 斜体,留正文
  .replace(/~~(.*?)~~/g, '$1')              // 删除线
  .replace(/`{1,3}[^`\n]+`{1,3}/g, '')      // 行内代码,整删
  .replace(/\[([^\]]+)\]\([^\)]+\)/g, '$1') // 链接,留锚文本
  .replace(/!\[([^\]]+)\]\([^\)]+\)/g, '')  // 图片,整删
  .replace(/^>+\s*/gm, '')                  // 引用前缀
  .replace(/^[-*+]\s*/gm, '')               // 无序列表符号
  .replace(/^\d+\.\s*/gm, '')               // 有序列表编号
  .replace(/^(?:[-*_]\s*){3,}/gm, '')       // 水平线
  .replace(/\[(x| )\]\s*/g, '')             // 任务列表勾选框
  .replace(/\|.*\|/g, '');                  // 表格行,整行删
这十三条规则其实是两类策略。第一类「剥壳留肉」:标题、粗斜体、引用、列表只去掉记号,正文原样保留;链接稍微特殊,剥掉 URL 但留下锚文本,因为锚文本往往正是读者要的信息。第二类「连壳带肉一起扔」:行内代码、图片、表格行整块删除——图片在纯文本里本来就没有意义,表格行单独拆出来是不成句的碎片,留着反而碍事。
实测一组输入,## Title、- item one、> quoted text 三行,输出是三行「Title / item one / quoted text」:结构感还在,只是没了记号。
几处写法也有讲究。(\*\*|__)(.*?)\1 里的反向引用 \1 要求开头和结尾是同一种记号,避免 ** 开头、__ 收尾这类不配对的组合被误删;懒惰量词 .*? 让匹配在最近的成对记号处停下,不会横跨两段加粗,把中间的普通文本一起吞掉。g 标志负责全局替换,m 标志让 ^ 按行生效——标题、列表、引用都是行首语法,没有 m 就只能删掉第一行。
顺序就是正确性:三个真坑
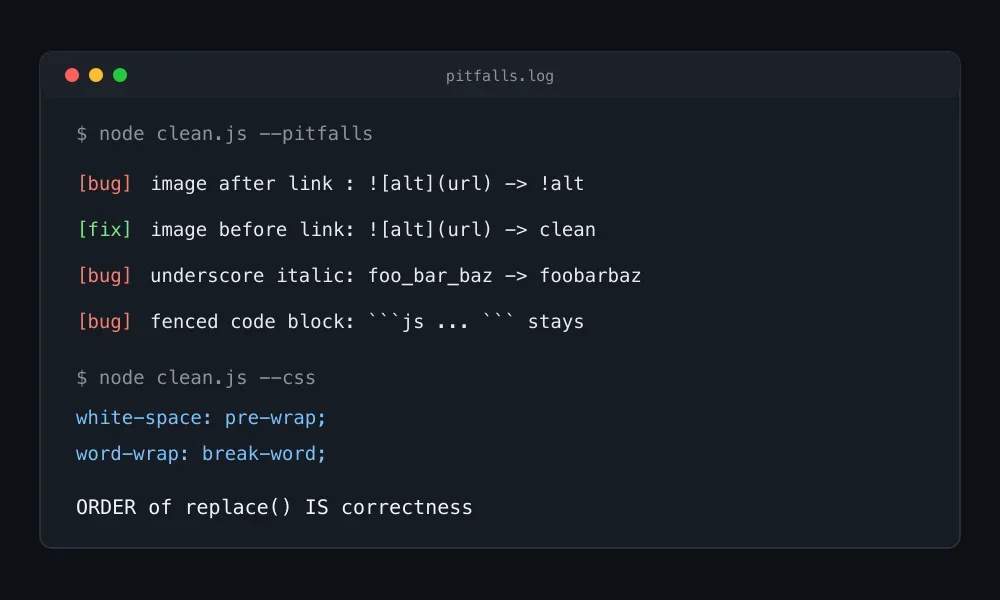
链式 replace 从左往右依次执行,规则顺序本身就是正确性。这条链上有三个坑,全部实测验证过。
坑一:图片规则必须放在链接之前。上面代码里图片规则排在链接后面,看着只是顺序问题,实际是 bug:链接的正则会先把  里的方括号对匹配掉,等轮到图片规则,只剩一个光秃秃的 !alt——实测输出正是 !alt and text。把图片规则提到链接前面,输出立刻干净。
坑二:斜体规则的 _ 会误伤下划线命名。foo_bar_baz 经过斜体规则,实测变成 foobarbaz,中间的下划线被当成了一对斜体标记。代码注释、变量名混进正文的场景并不罕见。对策是给斜体规则加边界约束,或者接受这个小概率误伤,取决于你的输入源。
坑三:行内代码规则不跨行。它的字符类里显式排除了换行符,单个反引号包住的行内代码删得干净,但三反引号围起来的跨行代码块会原封不动留在输出里。想连围栏块一起清掉,得再加一条按行匹配的规则。
表格规则是整行删除:| a | b | 清完只剩空行。对真表格这是对的,拆散了更难看;但如果一行普通文字里恰好出现两个竖线,中间的内容也会被误删,这个边界要心里有数。
换行不能丢:从 trim 到 pre-wrap
第一版工具有个不显眼的毛病:清理完顺手做了一次首尾空白裁剪,粘贴大段文本时开头结尾的空行没了。后来的版本干脆去掉这步裁剪,输出尽量贴近原稿。更关键的一处在 CSS:输出区不用 textarea 而用 div 渲染时,默认会折叠所有空白,必须补上 white-space: pre-wrap 才保得住换行,再配 word-wrap: break-word 防止长 URL 撑破容器。不用 textarea 是刻意的:textarea 意味着可编辑,而输出只承担展示和复制,div 更容易控制外观,也避免误改之后复制走一份错的。输入输出区统一用等宽字体,中英文混排的对齐立刻稳了。移动端靠一条 640px 的媒体查询收窄容器、缩小内边距,输入框补上 focus 高亮环——那属于可访问性,不算装饰。
界面三轮迭代的教训
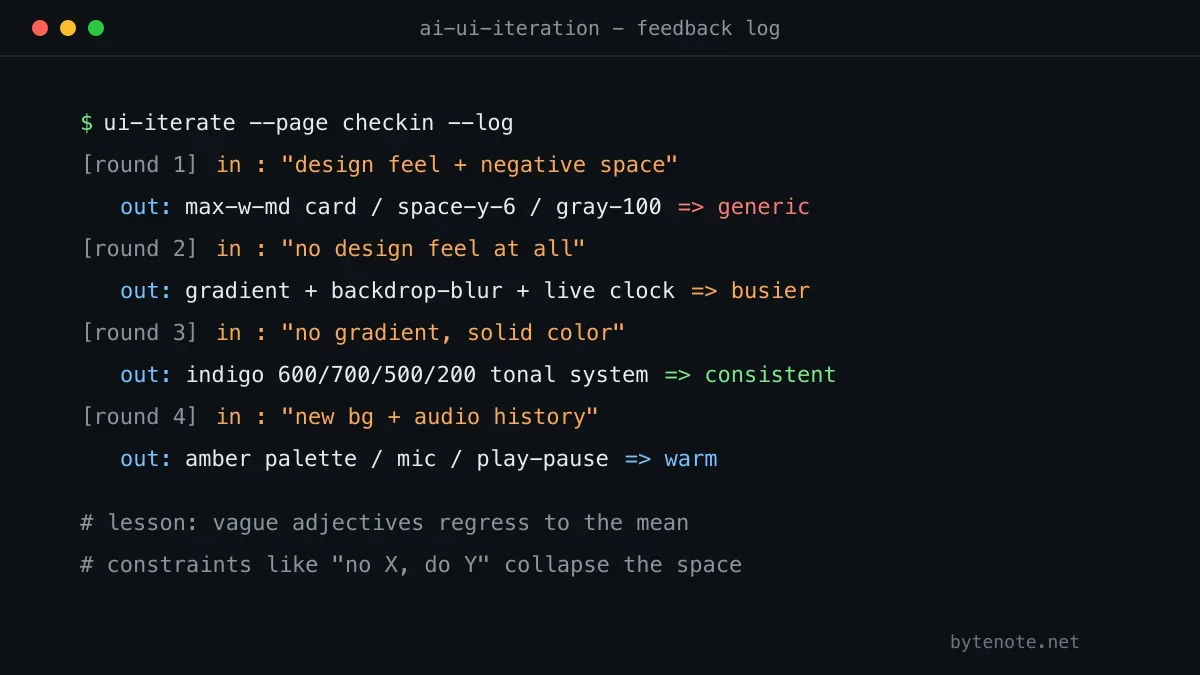
这个工具的界面改了三轮。第一版能用但平,白底灰框的默认样式。第二版追求「呼吸感」,上了流动的四色渐变背景、毛玻璃容器、悬浮上浮和标题脉冲动画,结果被一句「还是丑」打了回来。复盘很清楚:低透明度的白字压在鲜艳渐变上,对比度不够,可读性先垮掉;装饰性动画抢走全部注意力,功能退居其次。第三版全部收敛:柔和浅色渐变只当背景氛围,容器回到半透明白,按钮 hover 只做亮度微调。「呼吸感」的真正来源是留白、字号和间距的节奏,不是动画的数量。
够用就好,以及什么时候换解析器
这条正则链是典型的 80/20 方案:输入是规整 Markdown,比如自己写的笔记、大模型的回答,它足够可靠。但要处理任意脏输入,比如嵌套结构、被转义的星号、代码块里伪装成标记的字符,正则就会顾此失彼。那时该换成 marked 或 remark 这类解析器,先解析成语法树再序列化出纯文本,用复杂度换正确性。还要留意方向性:turndown 这类库做的是 HTML 转 Markdown,和这里的 Markdown 转纯文本是两个相反的工序,选工具前先确认自己站在流水线的哪一端。复制功能那侧也有个时代注脚:老代码普遍用 document.execCommand('copy'),它已被标记废弃;新代码优先 navigator.clipboard.writeText(),异步、干净,但要求 HTTPS 或 localhost 环境,老 API 可以留着做降级兜底。
同一条链,换个载体
这条链的载体也不必是网页。把它压缩成一行贴进浏览器控制台,就是随用随走的应急版;放进 Node 脚本,就能对一个目录里的 Markdown 文件做批量清洗;接在剪贴板监听或编辑器插件里,就是「粘贴前自动去格式」的一环。规则和载体是解耦的,真正值得沉淀的是那十几条正则和它们的顺序,网页只是最顺手的一件外衣。
写在最后
一个单文件 HTML,一条十几行的正则链,三个顺序坑,一次从花哨回到克制的设计迭代——这就是这个工具的全部,也是这类小工具该有的全部。花半小时写一个自己每天都会用的东西,大概是工程师最划算的投资之一。