字节笔记本
2026年10月24日 · 约 9 分钟读完
让 Claude、Cursor、Codex 共享一个大脑
你用 Claude Code 写代码,用 Cursor 改 bug,用 Codex 跑测试,每个工具都记不住你在另一个工具里说过什么。你跟 Claude Code 说的项目规则,Cursor 不知道;你在 Codex 里的调试经验,Claude Code 不记得。
每个 AI 工具都是"失忆"的。 上下文窗口一压缩,之前的对话就丢了。
Geek(@geekbb)推了一个开源项目,MCP Memory。一句话:给所有 AI 工具装一个共享的"长期记忆层",部署在 Cloudflare Workers 上,个人规模完全免费。
一、它是什么
MCP Memory(Puliczek/mcp-memory)是一个 MCP Server,让所有支持 MCP 的 AI 工具(Claude Code、Cursor、Codex、Windsurf 等)共享同一个记忆库。
- Claude Code 学会了"这个项目用 React 19" → 存进 Memory
- Cursor 连同一个 Memory → 自动知道"这个项目用 React 19"
- Codex 连同一个 Memory → 也知道
一个记忆层,所有 Agent 共享。不再每个工具各自失忆。
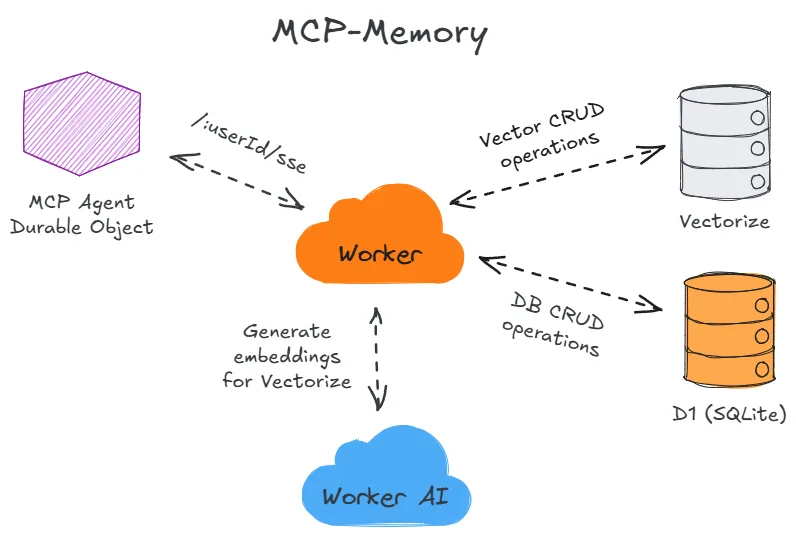
二、技术架构:全 Cloudflare 免费层
这个项目最巧妙的设计,全部跑在 Cloudflare 免费层上:
你的 AI 工具(Claude/Cursor/Codex)
    │ MCP 协议
    ▼
Cloudflare Workers(入口 + MCP 通信)
    │
    ├── Workers AI(bge-m3 模型)
    │     把文本转成向量嵌入(语义理解)
    │
    ├── Vectorize(向量搜索)
    │     存向量,按"意思"搜索(不是字面匹配)
    │
    ├── D1(SQLite 数据库)
    │     存原始文本和元数据(持久化)
    │
    └── Durable Objects(状态管理)
          保证读写一致性
存储你的记忆用到的 Cloudflare 服务,全部免费额度内:
| Cloudflare 服务 | 用途 | 免费额度 |
|---|---|---|
| Workers | 运行 MCP Server | 10 万次请求/天 |
| Workers AI | 文本转向量(bge-m3) | 1 万 neurons/天 |
| Vectorize | 向量搜索 | 3000 万次查询/月 |
| D1 | 数据持久化 | 500 万次读/天 |
| Durable Objects | 状态管理 | 含在 Workers 里 |
个人使用,免费额度绰绰有余。 数据落在你自己的 Cloudflare 账号里,不是第三方的。
三、语义检索 vs 字面匹配
这是 MCP Memory 最核心的技术点,按"意思"搜索,不是按"关键词"匹配。
字面匹配(传统做法):
- 搜"React 框架" → 只找到含"React 框架"这几个字的记忆
- 搜"前端框架" → 找不到(虽然 React 是前端框架)
语义检索(MCP Memory):
- 搜"前端框架" → 找到"这个项目用 React 19"的记忆
- 因为向量嵌入知道"前端框架"和"React"在语义上相近
原理,Workers AI 用 @cf/baai/bge-m3 模型把文本转成 1024 维向量。存储和查询都走向量,按余弦相似度匹配。即使措辞不同,意思相近也能找到。
四、怎么部署
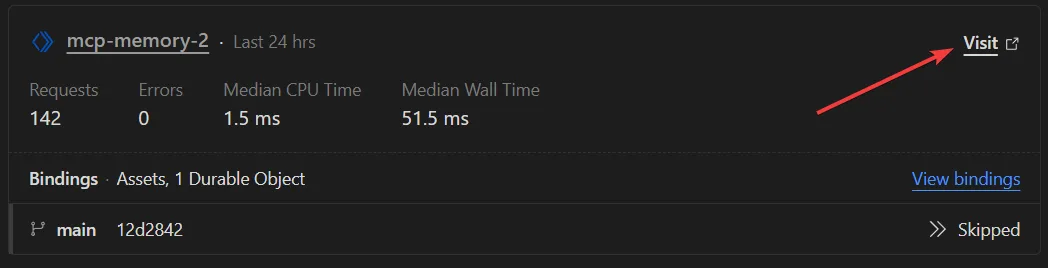
一键部署(最简)
# 点击 README 里的 "Deploy to Cloudflare" 按钮
# 或命令行:
npm create cloudflare@latest --git https://github.com/puliczek/mcp-memory
Cloudflare 自动创建 Workers + D1 + Vectorize,一键完成。
配置 Vectorize
npx wrangler vectorize create mcp-memory-vectorize \
  --dimensions 1024 --metric cosine
部署
npm install
npm run deploy
接入 AI 工具
在你的 AI 工具(Claude Code / Cursor)的 MCP 配置里,加上 MCP Memory 的 URL。所有工具连同一个 URL,就共享同一个记忆。
五、实际用法
装好后,在你的 AI 助手里:
你:记住,这个项目用 React 19 + TypeScript + Tailwind CSS
AI:好的,已记住。(存进 Memory)

(下次,换 Cursor 打开同一个项目)
你:帮我加一个新组件
Cursor:(从 Memory 读取)我注意到这个项目用 React 19 + TS + Tailwind,我用这个技术栈写。
关键,你不用在每个工具里重复说项目规则。说一次,所有工具都记住。
六、和 CLAUDE.md 的分工
| CLAUDE.md / AGENTS.md | MCP Memory | |
|---|---|---|
| 形态 | 项目里的静态规则文件 | 云端动态记忆库 |
| 检索 | 整份塞进上下文 | 语义搜索,按需取回 |
| 跨工具 | 每个工具各读各的 | 所有 MCP 客户端共享同一个库 |
MCP Memory 不是要替代 CLAUDE.md,而是补上“跨工具共享 + 按语义取回”这一层。
七、谁该用
强烈推荐,如果你:
- 同时用 2+ 个 AI 编程工具(Claude Code + Cursor + Codex)
- 受够了在每个工具里重复说项目规则
- 有 Cloudflare 账号(免费注册)
- 想让所有 AI 工具共享你的偏好/项目上下文
- 做 Agent 开发,需要"记忆层"基础设施
CLAUDE.md 是写死的静态规则;MCP Memory 是带语义检索的动态记忆,你问“前端用什么”,它也能匹配到“这个项目用 React 19”。
八、小结
一句话:MCP Memory 是一个部署在 Cloudflare 免费层的共享记忆 MCP Server,让 Claude Code、Cursor、Codex 等 AI 工具共享同一个长期记忆库,按语义检索(不是字面匹配),数据在你自己的 Cloudflare 账号里。
如果你用多个 AI 工具,MCP Memory 是"统一记忆层"的最简方案。说一次,所有工具都记住。
本文基于 Geek(@geekbb)的 X 推文及 Puliczek/mcp-memory 仓库整理。原文 https://x.com/geekbb/status/2071222081358799250 ,仓库 https://github.com/Puliczek/mcp-memory 。基于 Cloudflare Workers + D1 + Vectorize + Workers AI。仓库 2025 年 4 月后未再更新,但架构与部署流程至今适用。
推荐配合:Karpathy 第二大脑(个人知识库)、微信读书 Skill(阅读数据 AI 化)、CLAUDE.md(项目规则)、《从 0 写 Agent》第 8 章 Session(会话记忆)。