字节笔记本
2026年10月6日 · 约 10 分钟读完
迷你 Claude Code:Go 实现 SSE 流式输出
这是「从 0 实现迷你 Claude Code」系列的第四篇,主角是一个用 Go 写的迷你编程智能体。这一篇给它补上流式输出能力:在此之前,模型调用是阻塞式的,程序要等模型把整段话想完才一次性返回;改成流式之后,模型边想边吐字,用户能实时看到回答逐字长出来。对应实现是 model.go 里的 ChatStream。
为什么要有流式
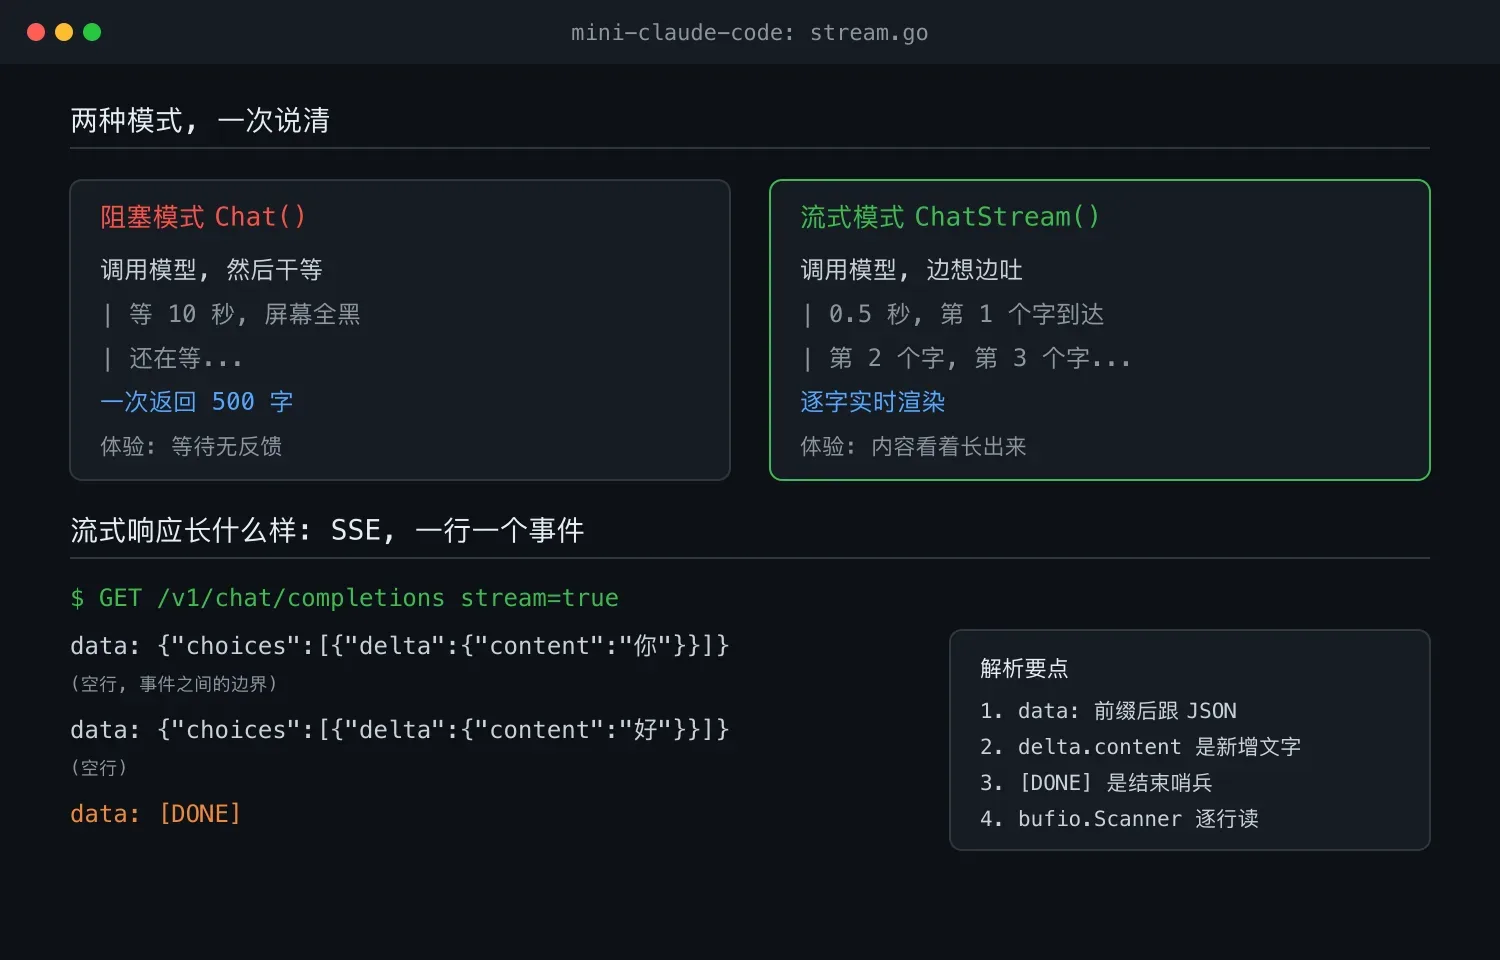
阻塞模式的问题很好理解:调一次模型,等上十秒左右,然后一次性拿回五百字。等待期间没有任何反馈,用户只能盯着空白屏幕硬扛。流式模式把同一次调用拆成连续的小片段:半秒左右第一个字就到,随后第二个字、第三个字接连抵达,内容像被逐渐写出来一样。
流式的价值是体验。ChatGPT 的打字效果就是流式,没有流式,Agent 的交互感会大打折扣。
SSE 是什么
OpenAI 的流式 API 返回 SSE(Server-Sent Events)格式,一行一个事件:
data: {"choices":[{"delta":{"content":"你"}}]}

data: {"choices":[{"delta":{"content":"好"}}]}

data: {"choices":[{"delta":{"content":"!"}}]}

data: [DONE]
每行以 data: 开头,后面跟一段 JSON,delta.content 是这次新吐出的文字片段。最后的 data: [DONE] 不是 JSON,而是协议层的结束哨兵,解析时要先判断它,再做 JSON 反序列化。还有一点容易忽略:事件之间用空行分隔,这是 SSE 规范的边界约定,按行解析时跳过空行即可。
用 Go 解析 SSE
Go 标准库的 bufio.Scanner 天然适合这件事:SSE 是按行组织的协议,Scanner 负责逐行读,循环体里做三件事,提取 data: 前缀、判断结束哨兵、解析 JSON:
scanner := bufio.NewScanner(resp.Body)
for scanner.Scan() {
	line := scanner.Text()
	if !strings.HasPrefix(line, "data: ") {
		continue // 跳过空行和非 data 行
	}
	payload := strings.TrimPrefix(line, "data: ")
	if payload == "[DONE]" {
		break // 结束
	}

	// 解析 JSON
	var chunk struct {
		Choices []struct {
			Delta struct {
				Content string `json:"content"`
			} `json:"delta"`
		} `json:"choices"`
	}
	json.Unmarshal([]byte(payload), &chunk)

	if len(chunk.Choices) > 0 && chunk.Choices[0].Delta.Content != "" {
		// 新文字, 回调给渲染器
		onEvent(StreamEvent{TextDelta: chunk.Choices[0].Delta.Content})
	}
}
整个流程就是:逐行读、提取 data、解析 JSON、拿到 delta、回调出去。每个 delta 是一小段文字,可能一个字,也可能几个字。
关键难点:流式工具调用
文字流式相对简单,每个 delta 都是一段纯文本。工具调用的流式要难一档,因为参数是分片到达的。
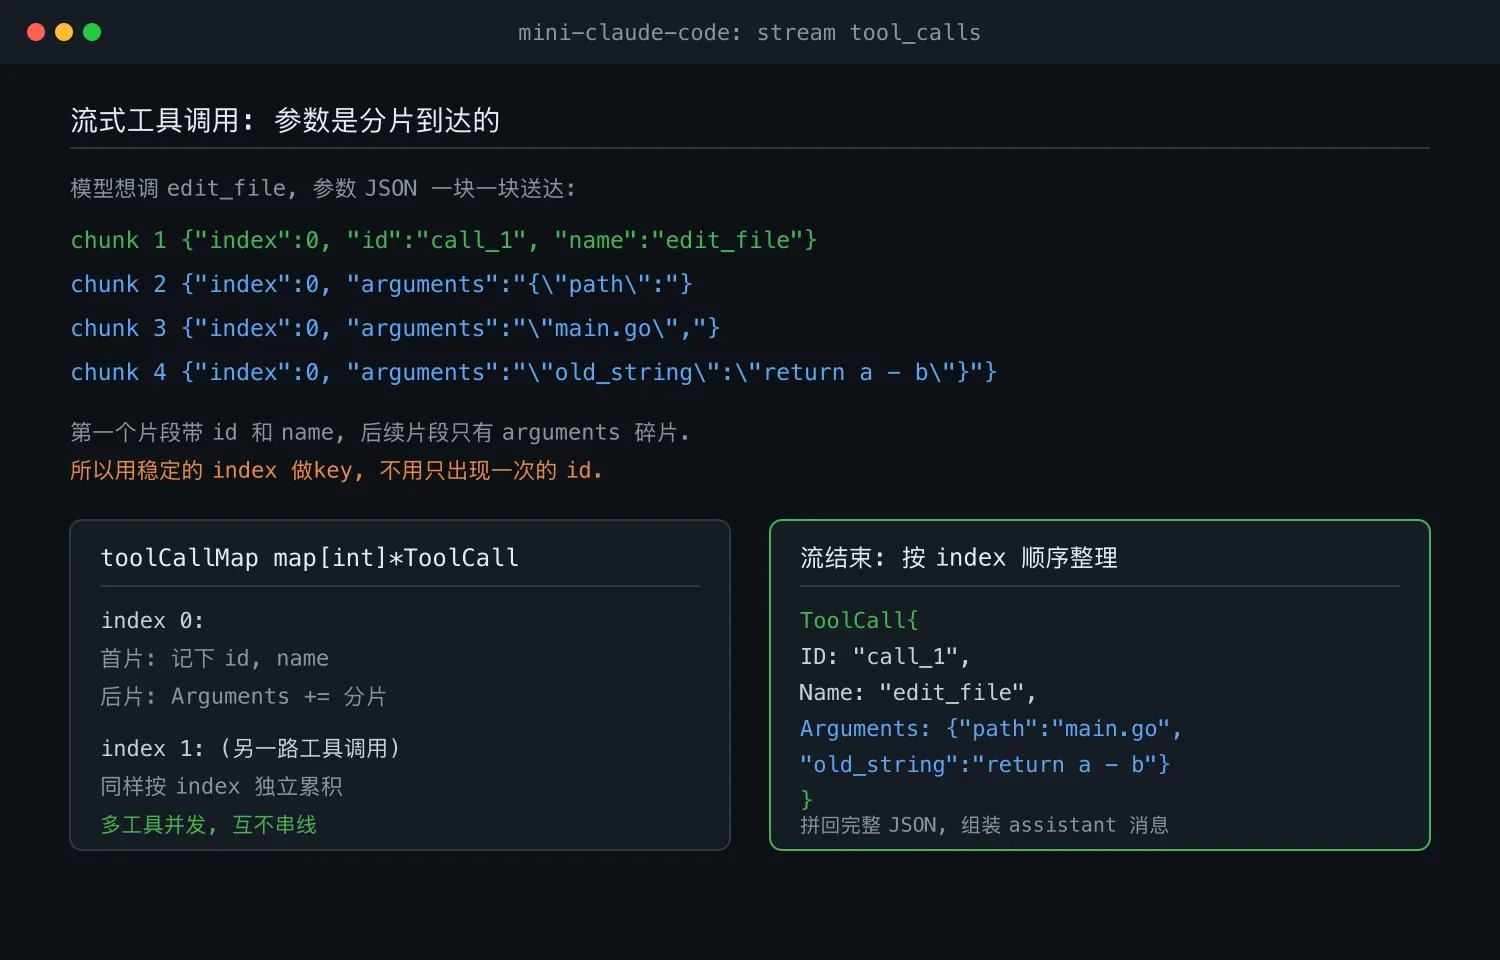
想象模型要调 edit_file(path="main.go", old_string="return a - b", new_string="return a / b")。流式之下,参数不是一口气来的,而是这样一段一段送达:
data: {"delta":{"tool_calls":[{"index":0,"id":"call_1","function":{"name":"edit_file"}}]}}
data: {"delta":{"tool_calls":[{"index":0,"function":{"arguments":"{\"path\":"}}]}}
data: {"delta":{"tool_calls":[{"index":0,"function":{"arguments":"\"main.go\","}}]}}
data: {"delta":{"tool_calls":[{"index":0,"function":{"arguments":"\"old_string\":\"return a - b\"}"}}]}}
第一个事件带 name 和 id,后续事件只带 arguments 的片段,参数 JSON 是一块一块拼起来的。
解法:按 index 累积
toolCallMap := map[int]*ToolCall{} // index 对应正在累积的 tool_call

for _, tc := range delta.ToolCalls {
	existing, ok := toolCallMap[tc.Index]
	if !ok {
		// 第一个片段: 记下 name 和 id
		existing = &ToolCall{
			ID:   tc.ID,
			Type: tc.Type,
			Function: ToolFunction{Name: tc.Function.Name},
		}
		toolCallMap[tc.Index] = existing
	}
	// 累积参数, 分片拼接
	existing.Function.Arguments += tc.Function.Arguments
}
用 index 区分多个并发的工具调用:模型一轮可能要调多个工具,每个 index 对应一个 ToolCall,参数逐步拼接。
为什么按 index 不按 id?因为只有第一个片段才有 id,后续片段只带 index,而 index 是稳定的(0, 1, 2),拿它做 key 最可靠。
流结束时整理
for i := 0; i < len(toolCallMap); i++ {
	toolCalls = append(toolCalls, *toolCallMap[i])
}
流结束后,把累积的 tool_calls 按 index 顺序整理成列表,组装成最终的 assistant 消息。
实时渲染
ChatStream 接收一个 onEvent 回调,每收到一个 delta 就调一次。Agent 循环里,回调的实现朴素得出奇:
assistantMsg, _, err := a.Client.ChatStream(messages, tools, func(ev StreamEvent) {
	if ev.TextDelta != "" {
		fmt.Print(ev.TextDelta) // 直接打印, 打字效果
	}
	if ev.ToolCall != nil {
		renderToolCall(ev.ToolCall.Function.Name, ev.ToolCall.Function.Arguments)
	}
})
fmt.Print 会立即输出每个字且不打断,这就是打字效果。这里有个小细节:不能用 Println,它会换行,字就断了;用 Print,字才能连续显示。工具调用事件则交给 renderToolCall,把工具名和参数实时画在终端上。
设计权衡:流式对比阻塞
| 阻塞 | 流式 | |
|---|---|---|
| 实现复杂度 | 简单 | 复杂(SSE 解析、分片累积) |
| 用户体验 | 差(干等) | 好(实时) |
| 错误处理 | 简单(要么成功要么失败) | 复杂(流到一半失败) |
| 首字延迟 | 高(等全部想完) | 低(第一个字立即来) |
这个迷你项目两种都实现了:Chat 阻塞、ChatStream 流式,Agent 循环用的是流式。两种实现放在一起对比着看,差异会非常直观。
小结
- 理解 SSE 格式:data 行加 JSON,空行分隔,DONE 哨兵收尾
- 用 bufio.Scanner 逐行解析流式响应
- 文字流式:delta.content 直接回调给渲染器
- 工具调用流式:按 index 累积分片参数,流结束按序整理
- 实时渲染:回调加 fmt.Print,实现逐字打字效果
到这里,这个迷你 Agent 已经能实时打字、实时显示工具调用。交互体验这一层补齐之后,剩下的就是让它去干真正的活:读代码、改代码、验证结果。