字节笔记本
2026年10月7日 · 约 7 分钟读完
从卡片到信息流:Next.js 文章列表组件三轮打磨记
列表页是内容站的门面,用户对一个站点气质的第一印象,多半来自首页那一列文章。但列表项恰恰是最容易被低估的组件:单个看很简单,拼成一整屏却极难耐看。最近帮某博客项目重构文章列表页,一个文章列表项组件前后改了三轮才定稿,顺带把分页与相关文章推荐一并落地。这里把整个过程和踩到的坑整理出来。
一、三轮样式迭代:越改越「轻」
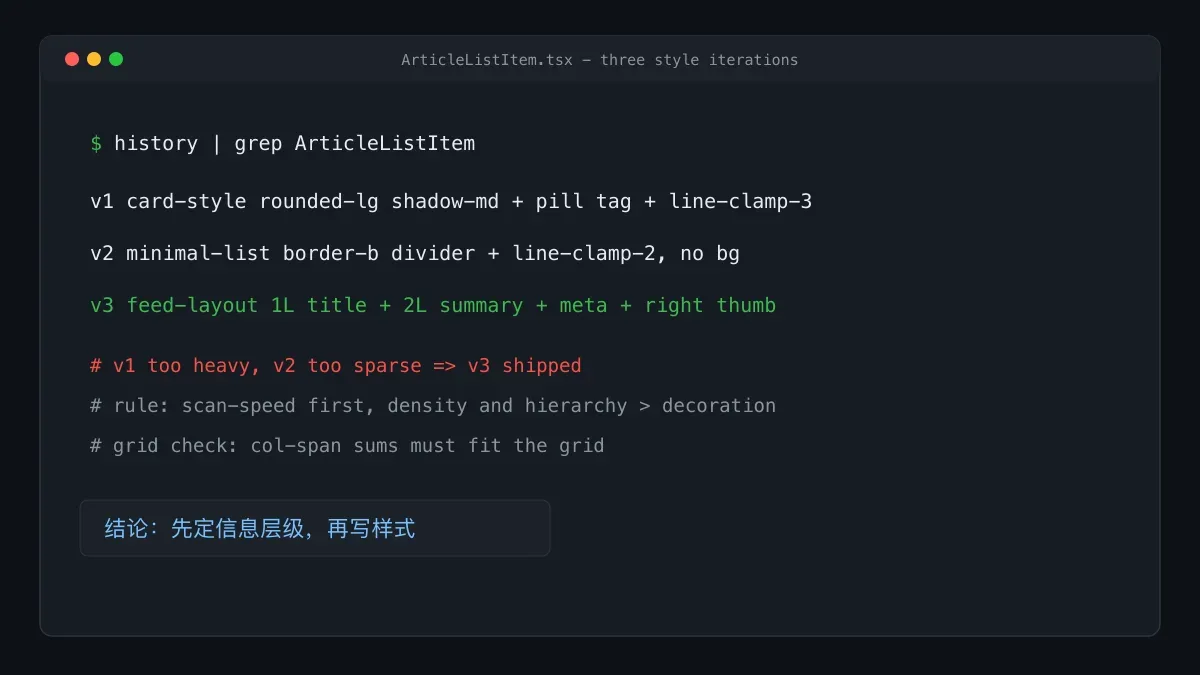
起点是一个「能用但不耐看」的版本:标题与日期一行、摘要一段,桌面端想用四列网格做分栏。这版其实埋着一个布局隐患——标题块跨三列,摘要却写了跨四列,两块相加超出四列网格,摘要必然被挤到第二行独占整行,「分栏」名存实亡。改样式之前先核对栅格的列数账,这是第一课。
第一轮改成卡片式:白色圆角卡片配阴影,分类名做成蓝底圆角胶囊标签,摘要用 line-clamp-3 截断,底部放「阅读更多」和右箭头,悬停时箭头右移、标题变蓝。单个卡片确实精神,但列表页是十几个卡片连排,阴影层层叠加之后视觉噪音很大,反馈只有一个字:丑。
第二轮走向另一个极端:去掉全部背景与阴影,改成细线分隔的极简列表,分类整个砍掉,摘要 line-clamp-2,日期缩成一行小字放在底部。清爽是清爽了,但一屏只剩标题、摘要、日期三样,信息密度太低,翻起来像目录而不是资讯流。
第三轮参考了一张目标站点的截图,落在两者之间:水平布局,左侧正文区、右侧可选缩略图,图片字段为空就不渲染,不留空洞;标题单行截断保证对齐,摘要固定两行;底部一行小字放作者、浏览量、点赞数,各配一个小图标;再往下是灰底圆角的标签组。悬停效果克制到只有一层浅灰背景变化,并用 last:border-b-0 去掉末尾多余的分隔线。这版定稿。
三种形态各有适用场景:卡片式自带视觉边界,适合带封面图、信息异质的内容,电商与社交媒体常用;极简列表几乎没有装饰,适合归档页、文档索引这类以检索为目的的页面;信息流式在密度与层次之间取平衡,最适合资讯类内容站的首页。选哪种不是审美问题,而是看用户带着什么意图来:来逛的给卡片,来找的给列表。
三轮下来有几条通用结论。列表页要的是扫读效率,密度与层级比装饰重要;具体做法是把一屏信息分成三级:标题用最大字重和最深颜色,摘要降一档灰度,日期、浏览量这类元信息缩到最小号,靠字号、颜色、留白三个维度拉开层次,而不是靠加边框和底色。line-clamp 是维持节奏感的关键,标题摘要行数一致,整页才有网格感;交互提示交给 group-hover 统一驱动,比每个元素各写一套悬停样式稳得多。另提个醒:Tailwind 在 v3.3 之前,line-clamp 需要额外安装插件,之后才收进核心,老项目报 unknown class 先查这一条。
二、加载更多:状态设计与两个坑
接着加分页。传统做法是「下一页」按钮,翻页时整页替换;这次采用追加式方案:新页数据拼接到列表尾部,用户感知不到跳页,浏览更连贯,将来也容易升级成滑到底自动触发的无限滚动。
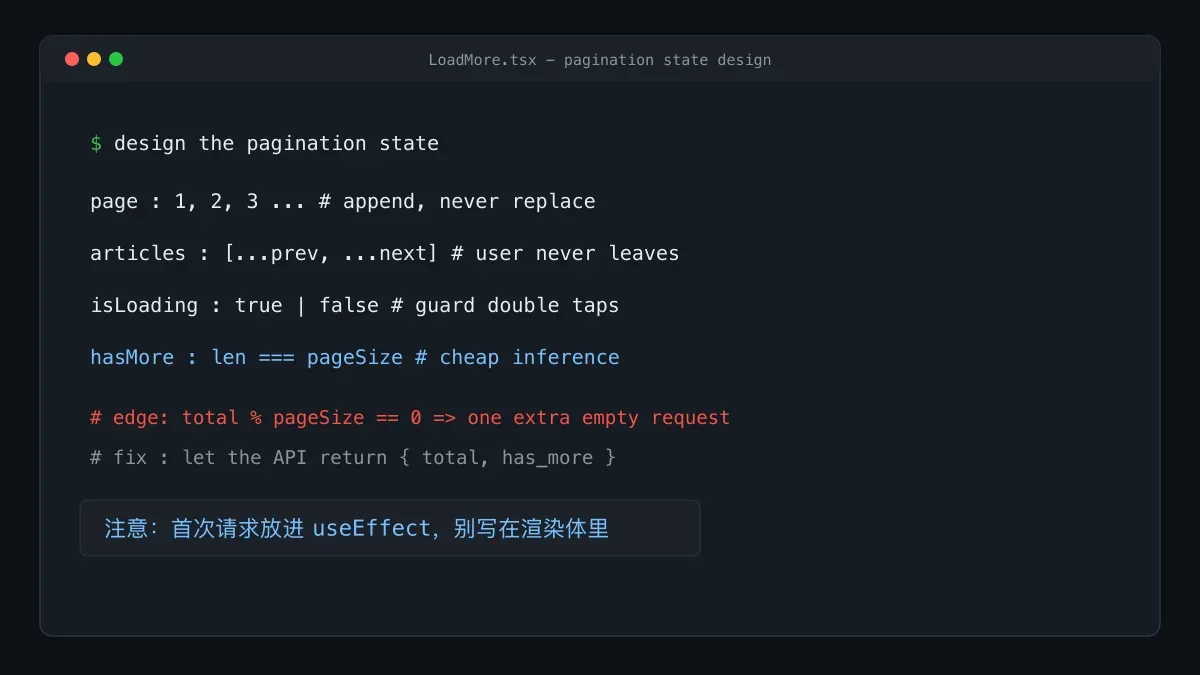
实现是状态四件套:页码、列表、加载中、是否还有。是否还有这一项用了最省事的推断——本页返回条数等于页大小,就认为还有下一页。这个推断有个经典边界:总数恰好是页大小的整数倍时,最后一页满员,要多发一次空请求才能确认到底。流量小可以接受,讲究一点就让接口直接返回总数或 has_more 字段。
顺带把三种分页形态的取舍说全:传统分页 URL 可分享、可回退,对搜索引擎最友好,适合以搜索流量为重的站点;无限滚动沉浸感最强,但用户很难记住「第几条」的位置,适合刷着看的场景;加载更多介于两者之间,实现简单、位置感还在,是内容型列表最稳妥的默认解。若站点重度依赖搜索流量,列表页还是该保留真实分页的 URL 结构,加载更多可以只做交互外壳。
两个值得记下的坑。其一,把首次请求写在组件渲染体里,形如「列表为空且没在加载就发请求」——渲染应当是纯函数,React 18 的 StrictMode 在开发环境还会双调用,等于重复请求,首拉应该放进 useEffect。其二,fetch 里写的 next: { revalidate: 60 } 是 Next.js 服务端组件与路由处理器的缓存选项,搬到客户端组件里并不生效,客户端更合适的是 SWR 或 TanStack Query 这类自带缓存的请求库。
三、Supabase 相关文章:overlaps 一个操作符
详情页想挂「相关文章」,数据在 Supabase。思路取最短路径:用标签衡量相关性——先取当前文章的标签数组,再找标签有交集的其他文章。Supabase 对数组列正好提供了 overlaps 过滤器,「标签重叠」一行就能表达:
// API 路由:/api/related-articles?articleId=xxx
const { data: current } = await supabase
  .from('articles').select('tags').eq('id', articleId).single()

const { data: related } = await supabase
  .from('articles')
  .select('id, title, summary, created_at')
  .neq('id', articleId)                  // 排除自己
  .overlaps('tags', current.tags)        // 标签数组有交集
  .order('created_at', { ascending: false })
  .limit(5)
实现上拆成两步:先按文章 ID 取到当前文章的标签数组,再拿它作为条件发起第二次查询,接口入口处校验 articleId 参数是否合法。前端配一个相关文章组件,在 useEffect 里按文章 ID 拉取渲染即可。
overlaps 对应 Postgres 数组类型的重叠判断:两侧都是数组,只要存在任一共同元素即命中。它不计算相似度,也不关心交集大小,一两个标签相同和全部标签相同在它眼里没有区别——这也是为什么想把相关性做准,最终都要在排序端补一条加权规则。另外示例里用的是匿名 key 直连,生产环境别忘了给文章表开行级安全(RLS),把匿名角色的权限收紧到只读。
要让这条查询快,有两个配套动作:tags 是数组列,在 Postgres 里为它建 GIN 索引,overlaps 的过滤才能走索引而非全表扫描;标签语义别太泛,「前端」「AI」这类大标签会让交集到处命中,相关性反而被稀释。再往上是按共同标签数排序、叠加同分类同作者加权等更复杂的算法,但对中小站点,标签重叠加时间倒序已经够用,超出这部分的收益通常配不上复杂度。
结语
回看这次改版,样式三轮迭代其实在回答同一个问题:用户在这一屏需要哪些信息、按什么顺序扫到。卡片式答非所问,极简式信息不足,信息流式刚好。组件没有一步到位的设计,只有随内容形态不断校准的版本——先想清楚信息层级,再动样式类名,往往比反复调样式收敛得更快。