字节笔记本
2026年10月7日 · 约 9 分钟读完
Next.js 文章页侧边栏:布局、随机推荐与流式加载
内容站的文章页几乎都有一个侧边栏:放导航、放推荐、放广告。它看起来只是「在正文旁边再画一列」,真动手时会接连撞上三个问题:布局上,桌面端双栏、移动端单栏怎么切换,顶栏怎么常驻;数据上,侧边栏塞「相关文章」还是「随机推荐」,随机接口怎么写才真的是随机;加载上,这块次要内容慢了,会不会把正文首屏一起拖住。最近在一次基于 Next.js App Router 的改造里,这三个问题被从头到尾走了一遍,本文把过程中的结论和踩到的坑整理出来。
一、先把骨架立起来:双栏布局与 sticky 顶栏
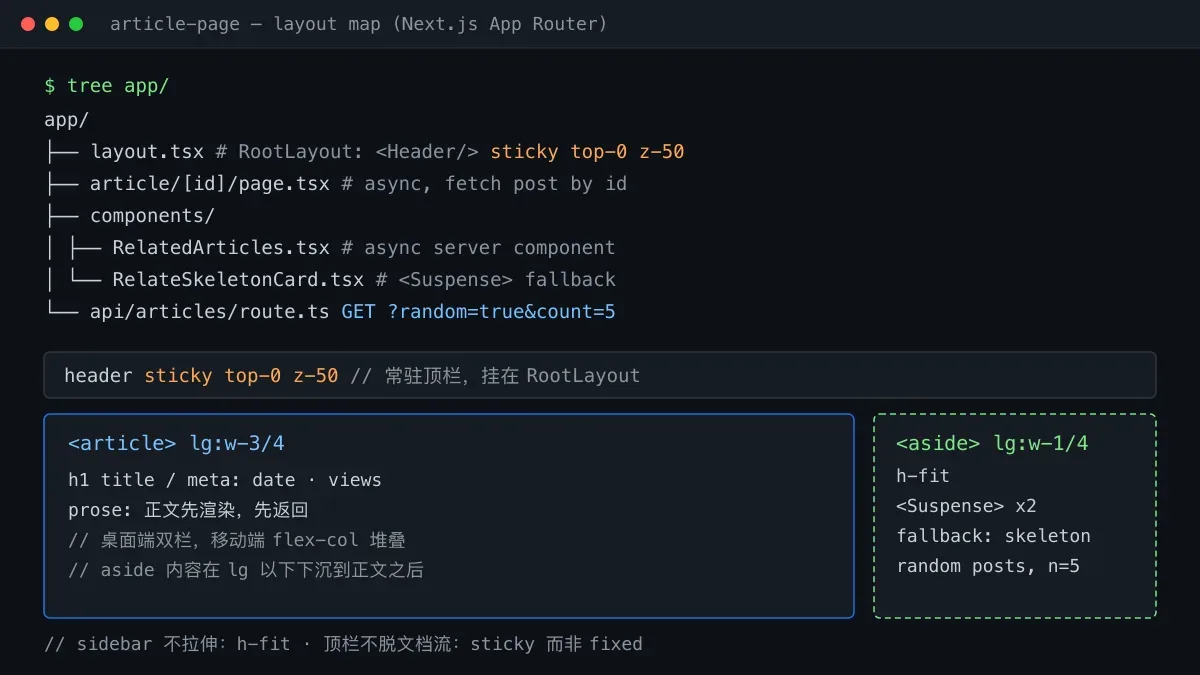
原始页面是一个全宽单栏:max-w-7xl 容器里一个 article 元素占满。改造第一步是把外层容器换成 flex flex-col lg:flex-row lg:space-x-8,正文列收缩为 lg:w-3/4,新增的 <aside> 占 lg:w-1/4。注意前缀是 lg::小屏幕上仍是上下堆叠的单栏,桌面端才分栏。这是 Tailwind 响应式布局最省心的用法——不要在移动端硬藏,而是让文档流自然换行。
两个容易忽略的细节:
- 侧边栏要
h-fit。flex 子项默认沿交叉轴拉伸,正文很长时侧边栏卡片会被拉到和正文一样高,留出大片空白。h-fit(即height: fit-content)让卡片只包裹自己的内容。 - 顶栏常驻用
sticky而不是fixed。fixed让元素脱离文档流,页面开头会凭空少一块高度,需要手动补 padding;sticky top-0 z-50的元素仍占位,滚动越过阈值才吸附,再配z-50盖住滚动内容即可。
第二个动作是把顶栏从文章页的路由布局提升到 RootLayout。路由布局只对特定路由段生效,而品牌顶栏、搜索入口应该全站可见——放进根布局,所有页面自动继承,文章页里就只剩内容本身。
顺带一提,这类文章页通常还在 generateMetadata 里再取一次同一篇文章的数据,用来生成标题、描述和 OpenGraph 图片,供搜索引擎与社交分享卡片使用。同一请求周期内,App Router 会自动合并相同 URL 的 fetch,两处取数并不会真的发两次请求;但哪天把取数改成直连数据库,这种「一处数据两处取」的写法就值得合并成单次查询了。
二、侧边栏放什么:相关文章还是随机推荐
侧边栏的经典内容是「相关文章」,常见实现是拿当前文章标题当关键词去搜索接口查一圈。这个方案在内容多了以后效果不错,但有个冷启动悖论:站内文章不多、标题又写得具体时,搜索经常空手而归,侧边栏一块醒目的「没有相关文章」比空白还尴尬。
随机推荐是更朴素的替代:不管文章多冷门,侧边栏永远有内容,旧文章也多了一条被翻牌的通道。这次改造的接口形如 GET /api/articles?random=true&count=5,一次返回五篇。
有意思的是这个接口的第一版藏着一行真 bug。最初的思路是「先查一次拿到文章总数,再按随机偏移取一篇」:
.limit(1)
.then(response => {
  const count = response.data.length;   // 永远是 1
  const randomIndex = Math.floor(Math.random() * count); // 永远是 0
  return supabase.from('blog')
    .select('id,title,created_at,content,summary')
    .range(randomIndex, randomIndex);
})
limit(1) 取回的数组长度恒为 1,随机索引于是永远是 0——所谓随机,实际上每次都返回同一篇。要拿总数,正确姿势是查询时带上 count: 'exact',或者干脆换个思路。
修正后的版本权衡了实现成本:取最近 100 篇(.limit(100)),在内存里洗牌后切前 N 篇返回。限定「最近 100 篇」而不是全表,一是控制传输量,二是让推荐偏向近期内容;在应用层洗牌,则是因为 PostgREST 的排序参数不能直接用 random() 这类函数。不过有两点值得再进一步:
sort(() => 0.5 - Math.random())是出了名的有偏洗牌,元素留在原位的概率更高。侧边栏场景无所谓,要严格随机应换 Fisher-Yates 算法;- 数据量上去之后,更好的路径是写一个 Postgres 函数(
order by random() limit n),通过 Supabase 的 RPC 调用,把随机下推给数据库。
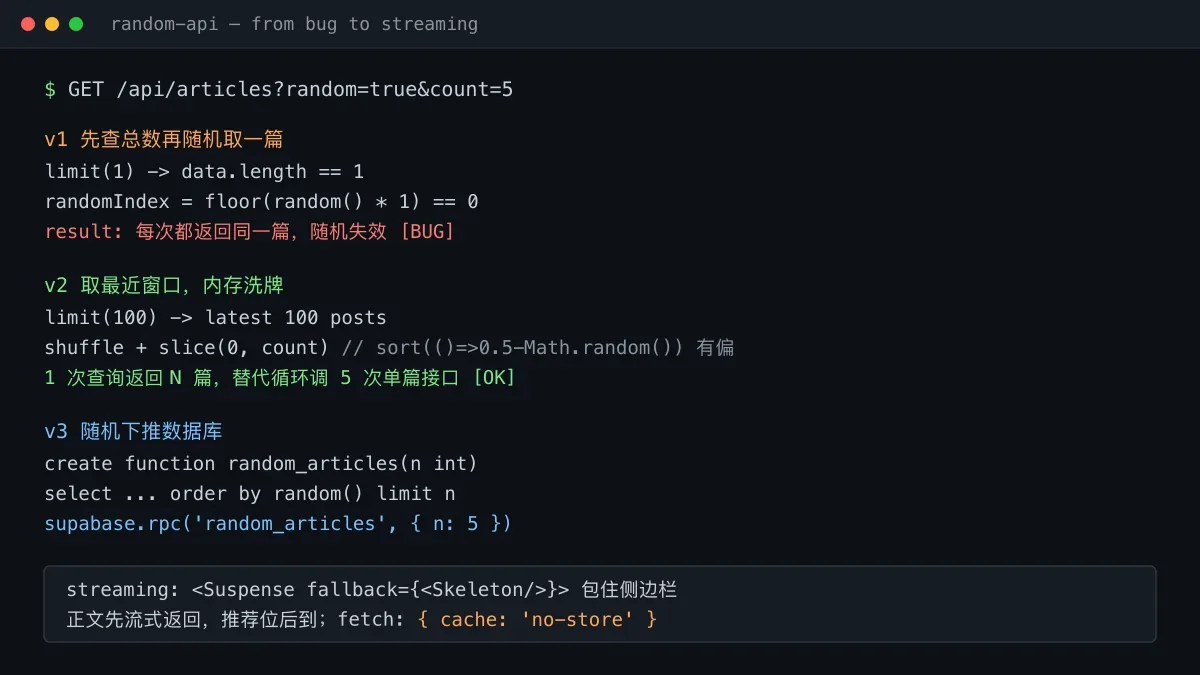
另一次迭代是把「循环调五次单篇随机接口」合并成「一次带 count 参数的多篇接口」。前者在服务端渲染时会串行发出五个 HTTP 请求,后端与序列化开销都翻五倍;合并后只剩一次往返。侧边栏这类「小而多」的数据源,接口粒度宁可粗一点。
三、别让侧边栏拖住正文:Suspense 流式加载
数据就位后,下一个问题是加载时序。Next.js 的服务器组件可以直接写成 async 函数在组件里 await 数据——但如果页面组件和侧边栏组件各自 await,整页的返回时间就被最慢的那条链决定,50 毫秒的正文查询可能因为推荐接口慢 300 毫秒而整体变慢。
解法是把侧边栏包进 <Suspense>:
<div className="lg:col-span-1 space-y-6">
  <Suspense fallback={<RelateSkeletonCard />}>
    <RelatedArticles id={post.id} />
  </Suspense>
</div>
正文外壳先渲染先返回,侧边栏作为独立的流式块,数据好了再补上。用户看到的是:正文秒开,侧边栏位置先出现骨架屏,随即填充。骨架屏用 animate-pulse 的灰色块模拟真实卡片的标题和列表行,占位尺寸要和最终内容一致,否则内容到达时页面跳动,CLS 就上去了。
两个配套细节:
- 随机内容不希望被缓存,fetch 要显式
{ cache: 'no-store' }。App Router 下 fetch 默认走缓存语义,忘了这条,用户每次刷新看到的可能是同一批「随机」文章; - 同一个组件可以被
<Suspense>包两次,生成两个独立推荐位,各自流式到达,互不阻塞。
四、踩坑清单与延伸思考
把这次改造里值得记下的点收拢一下:
sticky的祖先链上有overflow: hidden会失效。卡片常写overflow-hidden裁圆角,如果它套在 sticky 元素外层,粘性会退化成随容器滚动。顶栏要挂在没有 overflow 裁剪的容器下。dangerouslySetInnerHTML渲染富文本前先消毒。文章内容若来自多人投稿或外部导入,直接注入 HTML 是标准 XSS 入口,入库前应过一遍白名单清洗。- 服务器组件里
fetch('http://localhost:3000/...')自己的 API 能跑,但绕了一圈:多一跳 HTTP 和一次序列化,同进程直接查库更快;接口层留给客户端组件用。 - 随机内容与缓存天生相克。推荐位上了 CDN 或 ISR 之后,用户看到的其实是缓存快照;可以折中成「主文档放心缓存 + 推荐位实时」——这正是 Suspense 流式块的另一个好处,推荐位单独成块、单独请求。
- 移动端别一刀切隐藏。
hidden lg:block最省事,但随机推荐在移动端往往是有效的「继续读」入口,把它挪到正文末尾比直接藏掉更划算。 - 列表型接口别拖正文。随机接口的 select 里带着
content整列,五篇文章的正文全塞进一个侧边栏请求;列表型接口只取id、title、created_at这类摘要字段,正文留给详情页按需加载,带宽和序列化时间一起省。
收尾
一个侧边栏,从 CSS 布局写到 API 设计,再落到 React 的流式渲染模型——它小到一个下午能做完,又完整覆盖了内容站技术栈的三个层面。更值得带走的是决策顺序:先定布局与信息架构,再定数据策略并为「看起来能跑」的实现较真(那行恒为 0 的随机索引就是教训),最后才考虑加载时序。下次给自己的文章页加侧边栏,不妨按这条链路走一遍。