字节笔记本
2026年10月7日 · 约 9 分钟读完
Next.js 文章页实战:布局与页面该分还是合
App Router 是 Next.js 13 之后争论最多的改动之一:它把「布局」从页面里抽出来,变成约定俗成的 layout.tsx。项目里从此有两种文件——layout 管骨架,page 管内容。听起来很优雅,但真到写文章详情页这种一个页面顶一个小站的时候,很多开发者会犹豫:这两个文件,到底有没有必要分开?
最近整理一个内容站的文章页时就面对了这个选择:一边是带着站点头部、搜索框和回到顶部按钮的 ArticleLayout,一边是负责取数和正文渲染的 ArticlePage,最终我把两者合并成了单个文件。这篇文章记录拆与合各自的逻辑,以及合并过程中真正值得注意的几个坑。
一、App Router 为什么把布局和页面分开
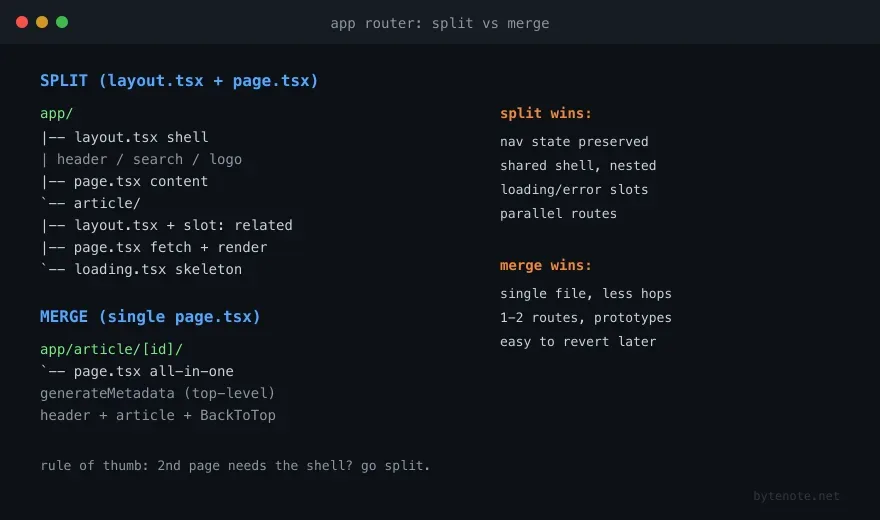
App Router 的目录约定是:app 目录下每个路由段都可以有一个 layout.tsx 和一个 page.tsx。page 是路由的终点,负责渲染这一页的内容;layout 是包裹 page 的外壳,在同一段布局内的路由之间跳转时,layout 不会卸载、不会重新执行。
这个设计带来三个直接收益:
状态保留。 导航栏里搜索框输入到一半、侧边栏的展开状态、滚动位置,在页面切换时都不会丢。如果布局写在每个页面里,每次跳转都会重建整棵组件树,这些状态全部归零。
复用与嵌套。 后台应用常见「整站一个壳、某个板块再套一层壳」的结构,用嵌套 layout 表达非常自然;内容站也可以让文章板块拥有独立于首页的布局,改动互不影响。
职责边界清晰。 改导航不用碰正文,改正文不用关心外壳,样式排查的范围也随之变小。
还有一个容易被忽略的细节:layout 组件除了 children 还可以声明额外的插槽,比如 related。这对应 App Router 的 parallel routes 能力——同一个 URL 由多个独立区块并行渲染、互不阻塞,文章页的「相关推荐」就是典型用法。
分离模式还有一圈配套约定可以按需挂到同一个路由段上:loading.tsx 提供整段加载骨架,error.tsx 接住渲染异常,template.tsx 则和 layout 长得很像但行为不同——template 在每次导航时都会创建新实例,适合做逐页动画这类「进页面就要重放」的效果。这些约定都建立在「布局与页面分家」之上,合并成单文件后自然全部失效。
二、什么情况下值得合并
拆分不是教条。有几类场景把 layout 和 page 写在一个文件里反而更合理:
- 单页或极少页面的应用。 整个站就一两个路由,为它维护两层目录结构纯属增加跳转成本。
- 原型验证阶段。 先在一个文件里把页面跑通,等长出第二个、第三个页面时再抽布局,重构路径反而更顺。
- 迁移目标不支持文件路由约定时,单文件结构更容易搬运和部署。
合并本身是机械劳动,但要做得干净,有几件事必须处理对。
三、合并文章页的四个关键点
1. 结构拼接与导入去重
把布局组件的内容作为外层容器,页面组件的输出填进原来 children 的位置;两份代码里重复的 React、图标等导入只保留一份;generateMetadata 这类 Next.js 约定的导出必须留在文件顶层——挪进组件内部不会生效。
2. 元数据与正文的重复请求
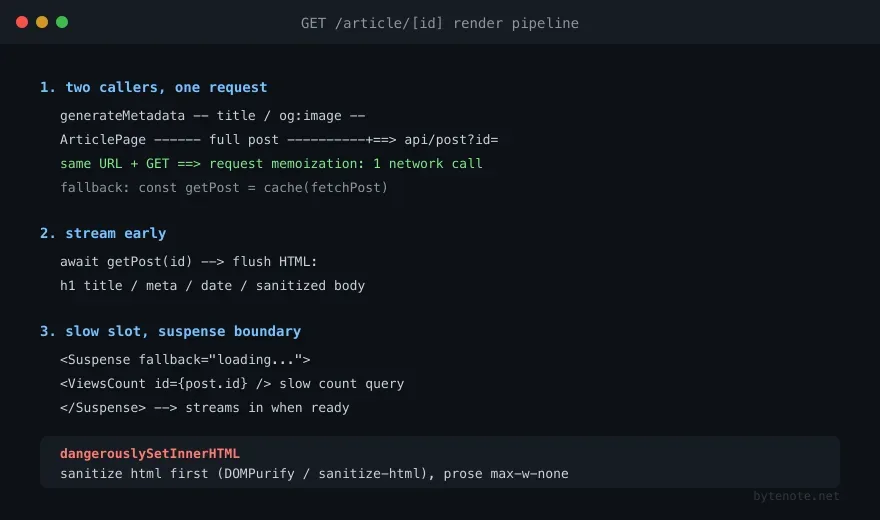
合并后的文件里通常有两处几乎相同的 fetch:generateMetadata 取标题、摘要和分享图,页面组件取完整文章。这不是合并引入的问题,分离时同样存在,只是合并后两段代码贴在一起,冗余变得刺眼。
顺带说一句为什么服务器组件会去调自家的 HTTP 接口而不是直接查库:接口层往往已经封装了鉴权、缓存和字段拼装,页面层复用它可以少维护一份取数逻辑。代价是必须搞清请求的时机和次数,否则同一篇文章会被请求好几遍。
Next.js 对同一次渲染中 URL 和配置完全相同的 GET fetch 做了请求去重(request memoization),两次调用同一地址只会真正发出一次网络请求。但去重的匹配条件很严格:URL 拼接方式不同、多传一个 header,去重就会失效。想要更明确的语义,用 React 的 cache() 把取数函数包起来是更稳的做法:
import { cache } from "react";

const getPost = cache(async (id: string) => {
  const res = await fetch(`http://localhost:3000/api/post?id=${id}`);
  if (!res.ok) throw new Error("post not found");
  return res.json();
});

export async function generateMetadata({ params }: Props) {
  const post = await getPost(params.id);
  return {
    title: post.title || "文章",
    openGraph: {
      title: post.title,
      images: [{ url: post.image || "/logo.png", alt: post.title }],
    },
  };
}
顺带提醒:openGraph 里的图片和标题记得写兜底值,否则分享到社交平台时卡片可能拿到空值。
3. 用 Suspense 圈出慢数据
文章页的阅读量统计需要查库计数,如果和正文串在同一个 await 里,标题就要陪着一起等。更好的组织方式是:正文数据在服务端组件里取好后立即渲染,把阅读数单独包成一个 async 组件,再用 Suspense 圈住:
<Suspense fallback={<span>加载中...</span>}>
  <ViewsCount id={post.id} />
</Suspense>
Next.js 会先把这个位置连同 fallback 一起流式发出去,等数据就绪后再补充推送。整页的首屏时间不再被最慢的那一小块数据拖住,这是 App Router 流式渲染最实惠的用法。
4. 富文本渲染的两道关卡
数据库里存的是编辑器产出的 HTML 字符串,最终通过 dangerouslySetInnerHTML 注入页面,再配 typography 插件的 prose 类解决排版。这里有两道关卡不能省:
- 出口必须消毒。 正文里可能混着用户可控的内容,dangerouslySetInnerHTML 是 XSS 的直通车,渲染前务必过一遍 sanitize-html 或 DOMPurify。
- 解除限宽。 prose 默认给内容限宽,放进已有的栅格布局会打架,需要 max-w-none 让它跟随外层容器。
四、合并的代价要想清楚
单文件跑起来很爽,但放弃分离等于放弃了第一节列出的三件事:导航间的布局状态、多页面共享外壳、parallel routes 插槽。文章详情页自己无所谓,等列表页、标签页、归档页都要同一个站点头部时,你要么到处复制粘贴,要么把这段布局再抽回去。
好消息是这条路不设单向门:合并后的文件里,布局部分天然就是一个完整的组件片段,日后抽回 layout.tsx 只需要把它挪回文件顶层、把正文部分塞回 children 插槽,导入关系原样保留。真正的成本不在重构,而在团队里每个人都要记住「这个项目没有走标准约定」这件事本身。
所以判断标准可以很简单:布局是否需要在页面之间保持状态?是否有第二个页面会用它?两个答案都是否,放心合并;只要有一个是,就老老实实 layout.tsx 加 page.tsx。
对内容站而言,多数情况下答案是后者。但完整走过一遍合并流程——导入去重、请求去重、流式边界、HTML 消毒——比背诵「应该分离」的结论有价值得多:无论拆还是合,这四个点都是文章页绕不开的工程细节,也是把一个页面从「能跑」做到「可靠」的全部距离。