字节笔记本
2026年11月6日 · 约 2 分钟读完
一步出图追平八步教师,判别器这次盯住了文本流
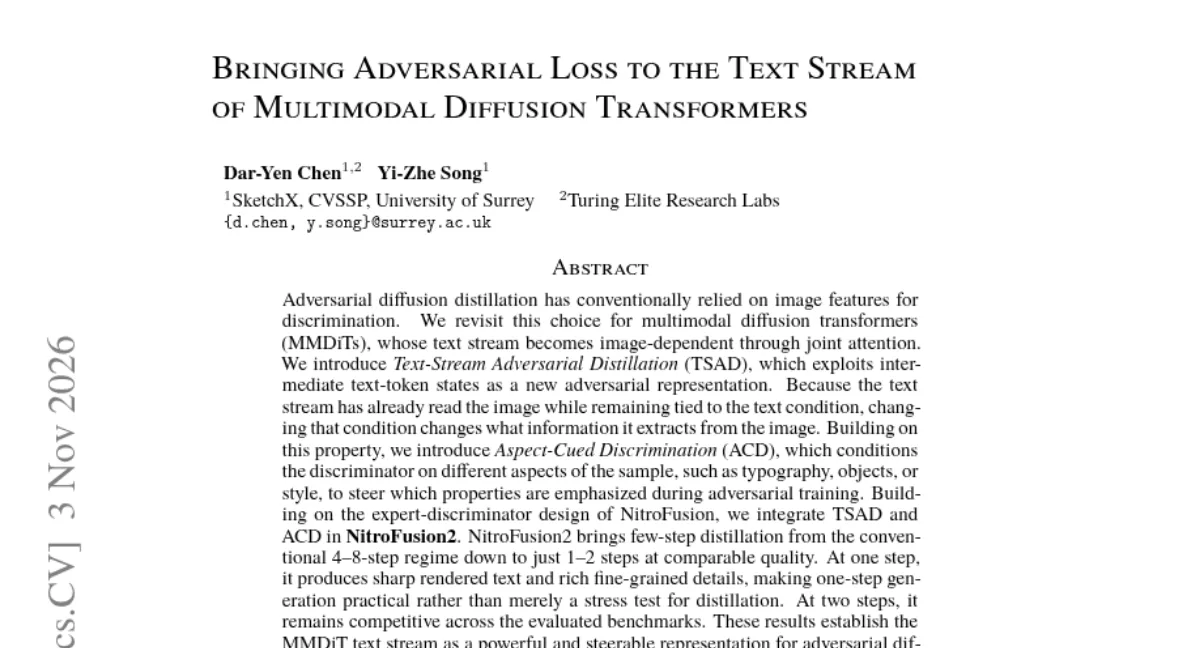
少步扩散蒸馏的对抗损失,历来只用图像特征做判别。萨里大学 SketchX 团队的 NitroFusion2(arXiv 2611.05648)注意到一个被闲置的金矿:多模态扩散 Transformer(MMDiT)的联合注意力让中间文本 token 的状态依赖图像内容,条件一变,它从图像里抽取的信息就变。把判别器挂到这条文本流上,判别信号会灵敏得多。
设计分两层。TSAD(文本流对抗蒸馏)在冻结骨干的中间文本流注意力输出上挂轻量判别头,学生和判别器骨干都从 Z-Image-Turbo 初始化。ACD(方面提示判别)更巧:为每张参考图生成六个图像支撑的字段(排版、物体、风格、背景、动作、布局),每步从 caption 或非空字段里采样一个提示去条件化判别器,学生保持原 prompt,信号路由到对应方面的专属判别头,零额外骨干前向成本就得到了「专家判别器」。
数字按论文口径:单步(1 NFE)生成在全部五个基准(LongText-Bench 英中两版、OneIG、GenEval、DPG-Bench)领先所有基线;对比 TwinFlow 单步,LongText-EN 高 14.2 分、LongText-CN 高 10.9 分;单步 DPG-Bench 86.48 分,超过了 8 步教师 Z-Image-Turbo 的 84.86,等于用八分之一的采样成本追平教师。两步档则与 12B 参数的教师增强版打平,而 NitroFusion2 任意步数只用单个 6B 模型。
局限作者也列了:单步处理复杂场景仍吃力,样本多样性有下降,ACD 的提示之间存在跷跷板效应。但「把判别器从图像流挪到文本流」这个观察,对所有做 MMDiT 蒸馏的团队都是一个可以立刻试的位移,成本只是加一个轻量判别头。