
字
字节笔记本
2026年11月6日 · 约 1 分钟读完
Strict 指标下最高分只有 23%,医疗 AI 出了照妖镜
API中转
¥120
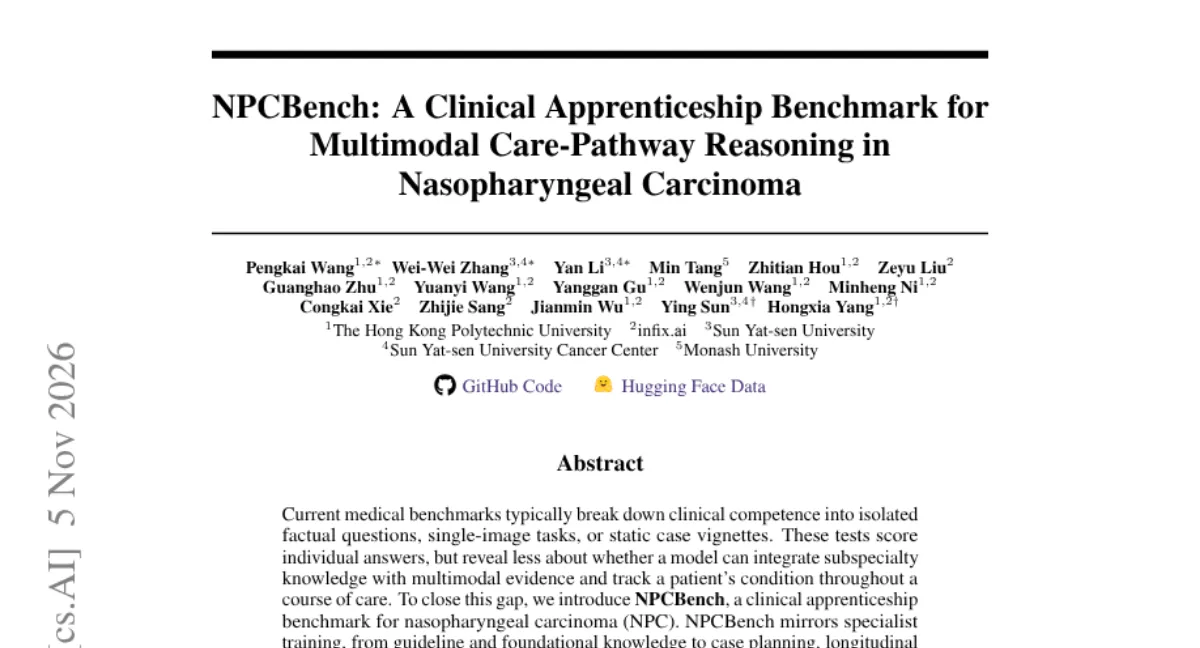
医疗 AI 的评测大多是「孤立问答题」:问一条指南、看一张图、答一个病例,分数都不低。但真实的临床是连续的:同一患者的病理、影像、分期与治疗决策必须连起来都对。港理工、InfiX.ai、中山大学肿瘤防治中心与莫纳什大学的 NPCBench(arXiv 2611.08369,IRB 批准协议 B2026-465-01,数据 CC BY 4.0)把鼻咽癌诊疗做成了「学徒式」考场。
考卷模仿专科医师培训设了六个递进层级加一个开放式会诊套件:指南记忆、原子化应用、多模态证据扎根、病例级计划、纵向决策修正,最后是 CarePath 病程片段:100 名患者、417 个评分任务,Strict 指标要求病理、T 分期和所有治疗答案全部正确。数据脱敏、多学科专家审核,评估了 30 个模型。
成绩单按论文口径相当不留情面:指南召回超过 92%,但最高病例规划准确率只有 71.9%,暴露「组成缺口」;视觉扎根最弱,完整 18 结构侵犯的正确率与证据扎根的 T 分期成功都低于 5%;Strict 全对率最高的 Claude-4.6 也只有 23%;Gemini-3.1 Care 单项 89.9% 但 Strict 仅 11%。会诊安全上,GPT-5.1 得分最高(58.4),主评审仍在其 14.6% 的回复里发现重大错误。
对医疗 AI 产品团队的启示很具体:单项分数高不等于能在真实诊疗流程里连续答对,「联合正确率」才是部署前该看的指标;视觉扎根(病理与分期的证据阅读)是当前最大的短板。这个基准的分层设计本身,也值得其他高风险领域的评测借鉴。
相关文章

分享: