字节笔记本
2026年10月7日 · 约 8 分钟读完
Ollama 拉取模型 503 错误排查与自救指南
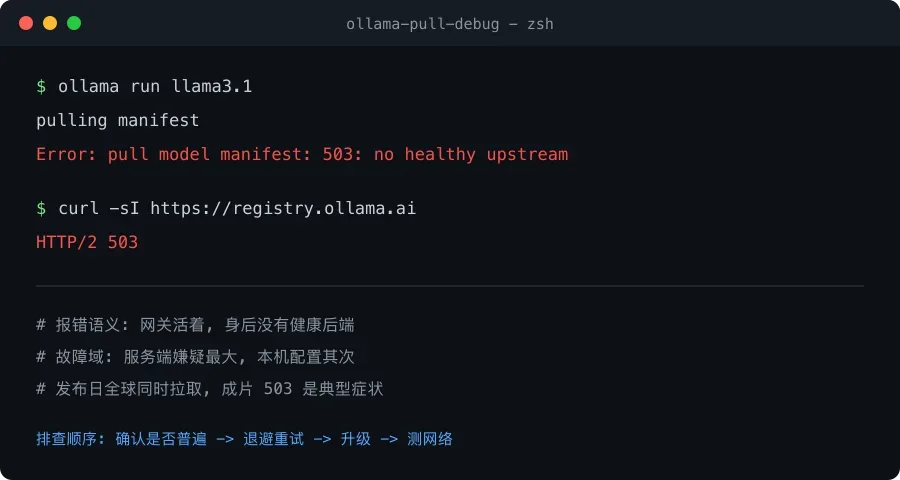
2024 年 7 月 23 日,Meta 发布 Llama 3.1 系列(8B/70B/405B),开源模型圈迎来少见的"全员冲榜"时刻。发布次日就有用户在 Windows 终端敲下 ollama run llama3.1,命令卡在 pulling manifest 几秒后,吐出一行报错:
Error: pull model manifest: 503: no healthy upstream
很多人的第一反应是"我的 Ollama 是不是装坏了"。其实这条报错的信息量比看起来大,它基本已经替你排除了大部分本机嫌疑。本文以这次踩坑为样本,拆解报错背后的拉取流程与网关语义,整理一条由近及远的排查阶梯,并附上官方源不可用时的自救办法。
先读懂报错:503 说的是谁的问题
ollama run 背后是两段式拉取:客户端先从模型仓库 registry 拉取 manifest——一份描述模型由哪些层组成、每层哈希和大小的清单;再按清单逐个下载真正的权重 blob。采用"清单加内容寻址"的设计,好处是同一层可以跨版本去重、断点续传有据可依,代价是任何一步都可能在网络上失败。报错停在 pull model manifest,说明权重还没开始下载,问题出在"读清单"这一跳。
再看状态码本身。503 Service Unavailable 通常由网关或负载均衡层返回,而 no healthy upstream 是反向代理的原话:网关自己活着,但它身后没有一台健康后端可用。这背后还有一层机制值得知道——负载均衡器会定期对后端做健康探测,响应超时或报错的后端会被摘出池子;服务一旦过载,响应变慢,探测失败,后端被摘除,剩余机器压力更大,进而更多后端被摘除,形成恶性循环。如果此时客户端还在疯狂重试,就是火上浇油的"重试风暴"。
时间点也佐证了这是服务端的问题:新模型发布首日,全球用户同时涌向 registry,动辄数百 GB 的下载洪峰冲向同一个域名,后端扩容不及,成片的 503 是典型的发布日症状。
顺带记一组对照,报错定位会快很多:
| 报错 | 大致含义 | 故障域 |
|---|---|---|
| 404 | tag 不存在或模型名写错 | 客户端 |
| 401 / 403 | 认证或权限问题 | 客户端 |
| timeout / DNS 失败 | 网络不通或被拦截 | 本机网络 |
| 503 no healthy upstream | 网关活着、后端不健康 | 服务端 |
由近及远的排查阶梯
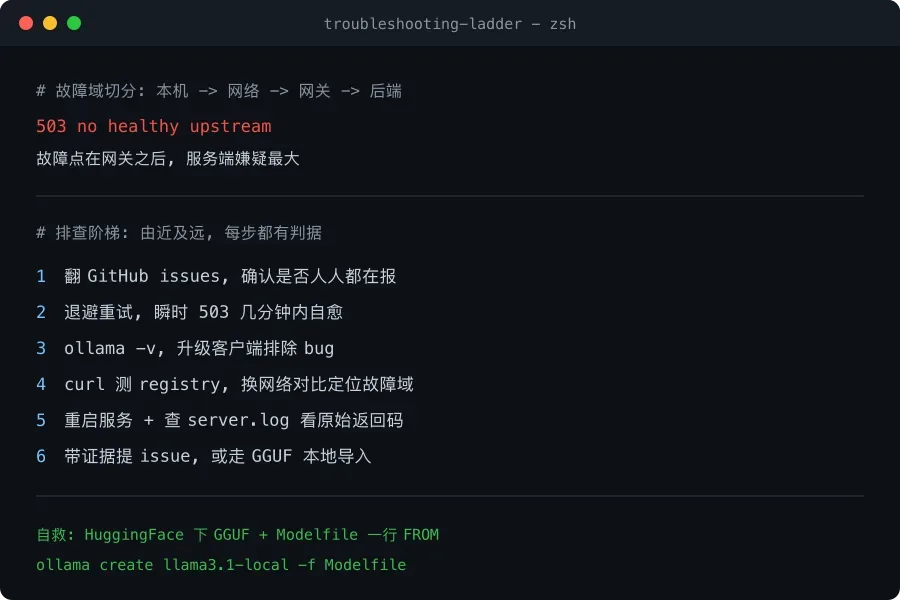
把当时收到的排查建议按"先查自己、再查网络、最后等服务端"重排成六步。原则是每一步只验证一件事:判据不通过就进入下一步,通过了就把问题锁定在对应故障域,避免东一榔头西一棒子。
第一步,确认是不是"大家的问题"。 翻 Ollama 的 GitHub issues 或社区动态,如果同一时段大量用户报同样的错,答案就是等,其余折腾都能省掉。这一步成本最低、收益最高。
第二步,退避重试。 瞬时 503 通常几分钟内自愈。手动隔几分钟再试即可,不要写脚本高频重试——除了给过载的服务端添堵,还容易触发限流,把小故障拖成大麻烦。
第三步,升级客户端。 ollama -v 看版本,旧版客户端对新模型的 manifest 格式、大文件下载支持可能有缺陷,升级到最新版再试。Windows 用户注意:升级安装包后要确认托盘里的 Ollama 服务也重启了,光装新包不重启进程,跑的还是旧代码。
第四步,验证网络路径。 公司防火墙、代理、DNS 都可能拦下 registry 域名。用 curl -I https://registry.ollama.ai 测连通性,再换个网络环境(比如手机热点)对比:换网就好,问题在你的网络;哪儿都 503,回到服务端。受限网络下挂 VPN 也值得一试。
第五步,重启服务并查日志。 常驻服务里的陈旧连接也可能出问题,重启清掉。日志位置:Windows 在 %LOCALAPPDATA%\Ollama\server.log,macOS 在 ~/.ollama/logs/server.log,Linux 用 journalctl -u ollama 查看。日志里记录着请求 registry 的具体 URL 和返回码,是判断"哪一跳出错"的原始证据。如果日志里反复出现对同一个 manifest 地址的非 200 返回,基本可以坐实服务端故障,转回第一步确认即可。
第六步,带上证据提 issue。 版本号、操作系统、完整报错、发生时间,四样凑齐再提交,维护者才有机会复现。
官方源拉不动时的自救
等不及,或长期身处受限网络(内网、跨境)时,可以完全绕开 registry。Ollama 官方支持从 GGUF 权重文件直接建模型:从 HuggingFace 下载对应量化版(例如 Llama 3.1 8B Instruct 的 Q4_K_M),写一个只有一行的 Modelfile:
FROM ./Meta-Llama-3.1-8B-Instruct-Q4_K_M.gguf
社区仓库通常按量化档位列出多个文件,挑一个和自己内存、显存匹配的,下载完对一眼文件大小或哈希,避免拿半截文件建模失败。然后 ollama create llama3.1-local -f Modelfile,再 ollama run llama3.1-local,同一套命令行体验就回来了。
选量化档位时按硬件量力而行:8B 模型的 Q4_K_M 体积约 5 GB,普通笔记本内存就能跑,是默认之选;Q8 档位体积翻倍、质量更接近原版,适合内存宽裕的机器;再往上的 FP16 属于"发烧友专属",收益不大。量化档位每降一级,体积和显存占用都在让步,下载时间也成倍缩短——在"就想赶紧跑起来"的故障场景里,低档位反而是更聪明的选择。
Modelfile 也不止一行 FROM,还能追加 SYSTEM 设定默认人设、TEMPLATE 调整提示词结构、PARAMETER 固定温度等推理参数。也就是说,本地导入不是降级方案,而是一条完全可控的定制路径。权重文件本身是可迁移资产,llama.cpp、LM Studio 同样能直接吃 GGUF——工具链可以换,权重不用重下。
这条后路的价值不止应急:它意味着"本地优先"玩家的模型资产不绑定任何单一 registry。仓库挂了、限流了、域名被墙了,都有替代路径。
延伸:报错原文就是最好的排错文档
这次复盘最大的收获在方法论:先读报错,再动手。no healthy upstream 这半句话已经把故障钉在网关之后,直接排除"重装 Ollama""改环境变量"这类常见无效操作。
通用顺序是:读报错原文,切分故障域(本机、网络、服务端),用最小代价的验证手段(curl、换网络、查日志)确认落在哪个域,最后才改配置。多数 503 的正确动作是等,而不是重装;多数"拉不下来"的正确动作是先 curl 一下,而不是先怀疑硬盘。
站在服务提供方的视角,发布日尖峰也有一套成熟的应对姿势:提前预热缓存和镜像节点、把大权重分发交给 CDN、对拉取请求排队限流,甚至像一些分发项目那样走 P2P——让下载者之间互相分担流量。而作为普通用户,最实用的启示只有两条:新模型发布日错峰拉取,以及平时就留好"权重文件在手、随时可重建"的后路。错峰并非让你错过什么——发布热度通常在一两天内回落,届时 registry 恢复正常,一条普通的 pull 命令就能解决战斗,而你在高峰期省下的是一整晚的无效重试。
下次新模型发布日再遇到同样的报错,按这张阶梯走一遍——大概率第一步就能收工。