字节笔记本
2026年11月8日 · 约 4 分钟读完
OpenAI 的模型自己挖 Linux 内核漏洞:948 个能拿到 root,账单 121 万美元
OpenAI 的模型自己挖 Linux 内核漏洞:948 个能拿到 root,账单 121 万美元
OpenAI 11 月 4 日发布研究文章《A thousand fewer paths to root》:Cyber 团队搭了一条五阶段流水线(漏洞发现→动态验证→可利用性评估→补丁生成→人工复核),用一个未发布的新 cyber 模型在受控研究环境里扫最新 Linux 内核——2,308 个去重候选、1,724 个动态复现、最终 948 个不同的本地提权漏洞与 948 个候选补丁,全程端到端约 121 万美元 API 积分。先定性:这是研究文章,不是产品发布、不是工具开源——补丁发给维护者、利用技术细节未公开。
流水线与账单(官方原文口径,本文整理成卡)
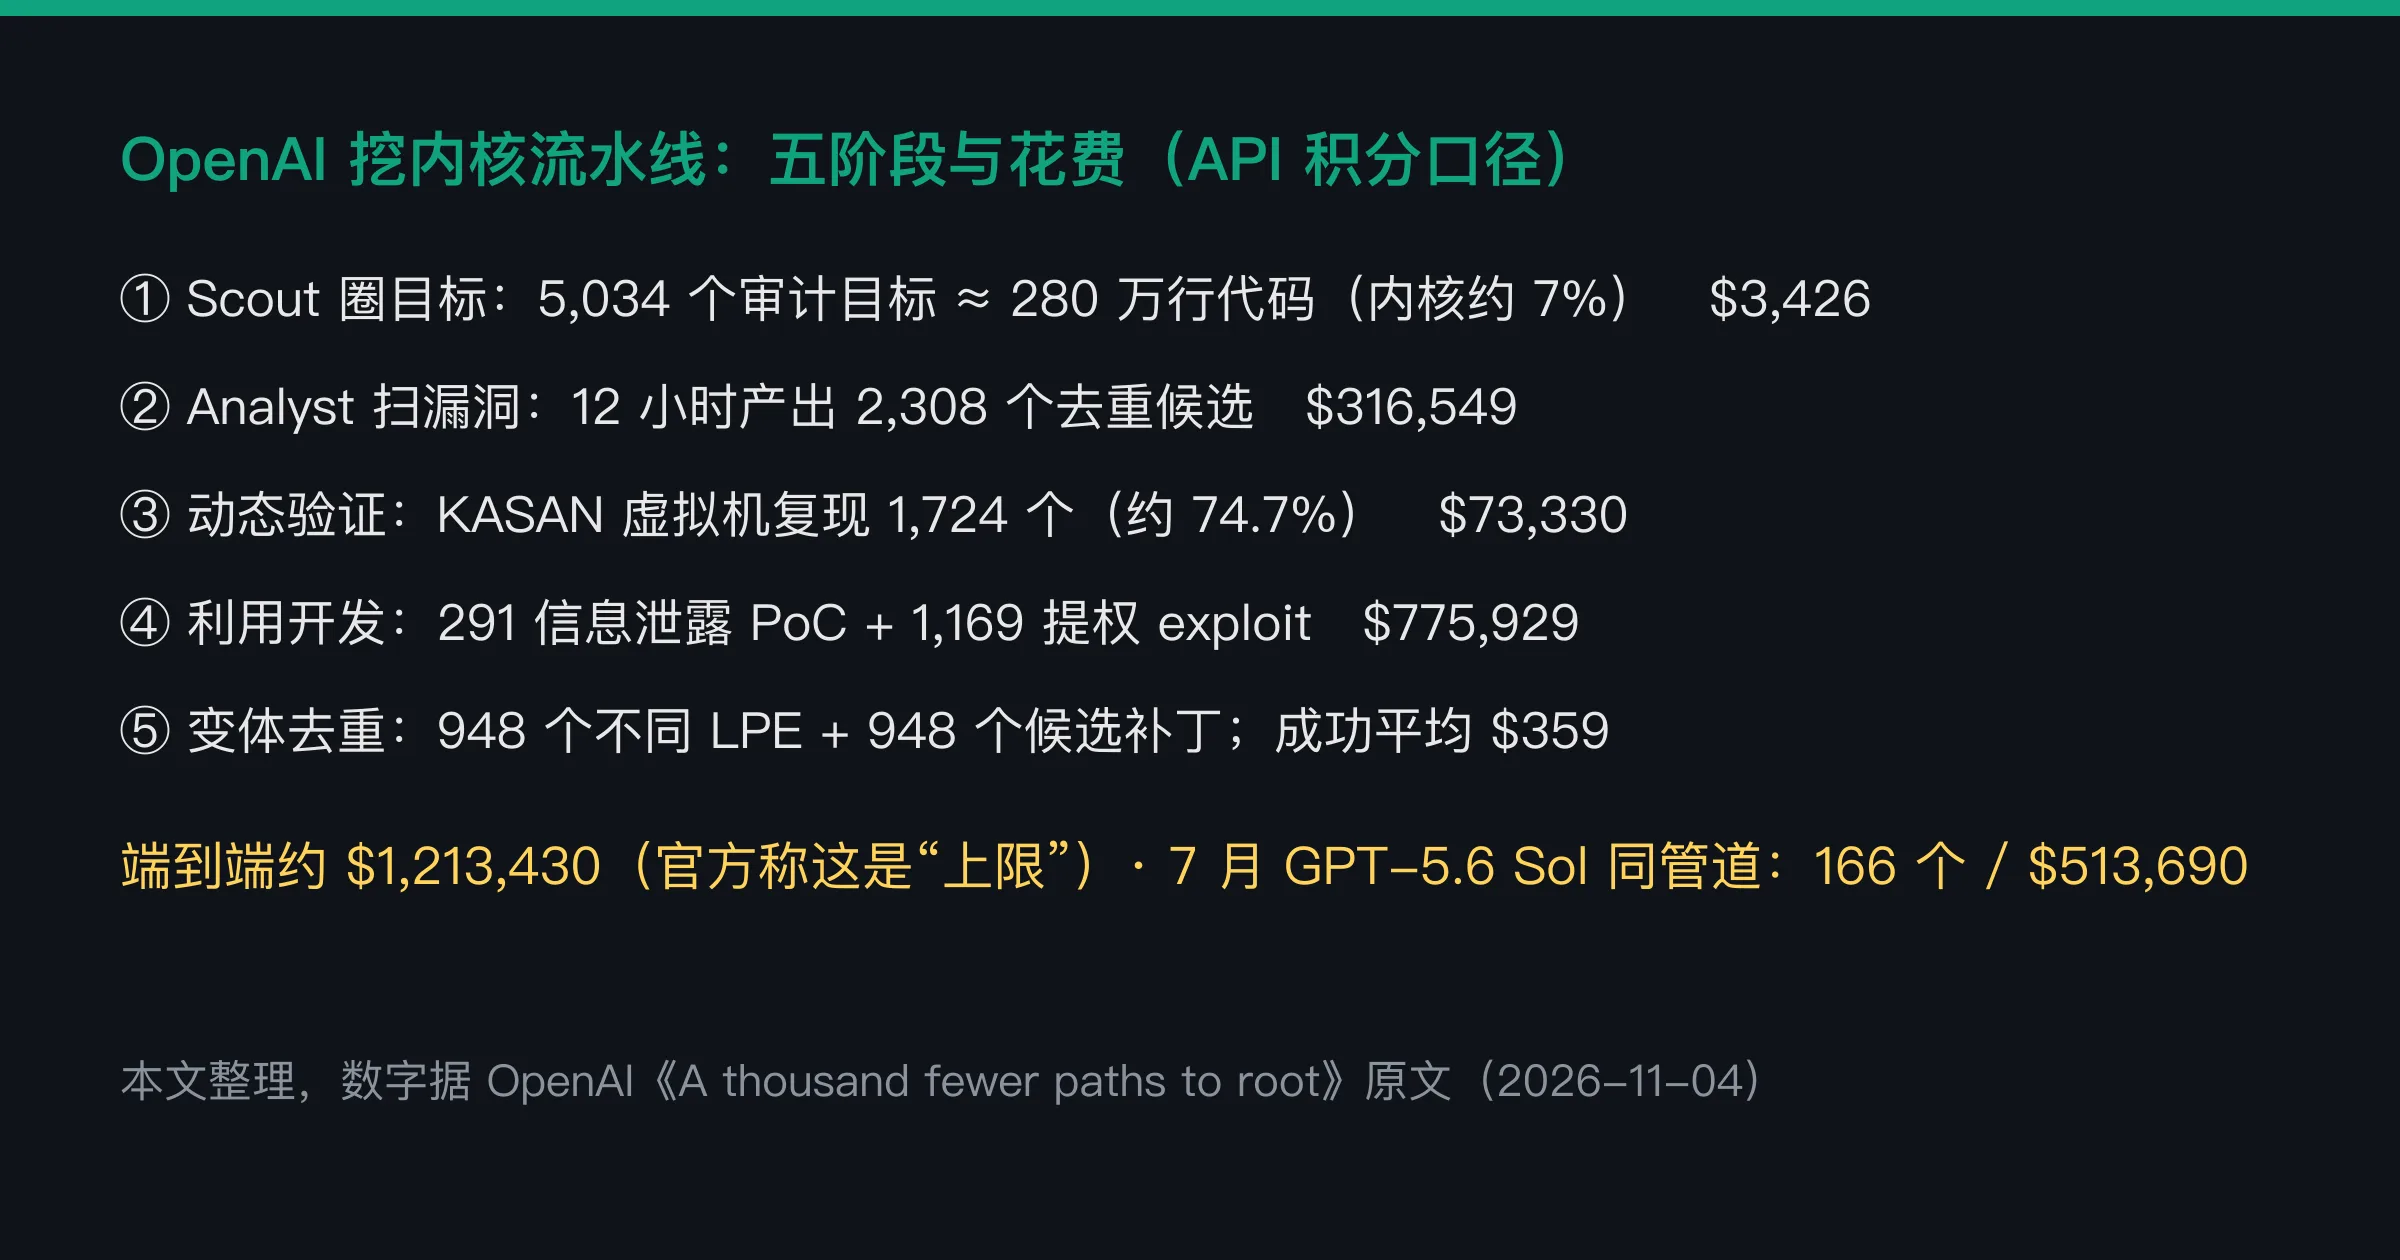
- Scout 先圈出 5,034 个审计目标(约 280 万行代码,占内核约 7%),花费 $3,426;
- Analyst 12 小时产出 2,308 个去重候选发现,$316,549;
- 动态验证:在 KASAN 虚拟机里跑 PoC,30 小时复现 1,724 个(约 74.7%),$73,330;
- ExploitDev 从 313 个信息泄露 + 1,238 个提权候选里,产出 291 个信息泄露 PoC 与 1,169 个可用提权 exploit,$775,929;
- 变体分析去重为 948 个不同 LPE + 948 个候选补丁;成功一个 exploit 平均 $359;
- 端到端约 $1,213,430——官方自称这是“上限”(充分做 harness 工程还能降),别写成“挖一个洞 121 万”。
两个更有意思的发现
模型越强,旧代码越值得重扫:7 月下旬 GPT-5.6 Sol 跑同一套 harness 找到并利用 166 个不同 LPE($513,690);10 月中旬的新 cyber 模型找到 948 个($1,213,430)——同一段代码,两扫之间差了近 6 倍。维护者在飞快打补丁:扫描加人工分析结束 10 天后,61 个 LPE 已在上游修复、43 个有 staging 补丁、299 个正在公开报告讨论。此外抽查 166 个 exploit 发现 10 种新的利用技术(2 种新型持久弹性对象、2 种页面整理、5 种 data-only 提权、1 种任意类型混淆),经第三方内核利用专家确认是新的——完整细节出于安全原因未公开。
判断
三点校准:① 数字别混:2,308 是候选、1,724 是复现、948 是去重后的不同 LPE——三个口径三层含义;② 与第三十二批“GPT-6 Cyber”(安全模型发布)区分:这篇是该模型及更新模型的规模化实战;与第十批 X 轮一笔带过的“948 个提权”也不同:那次是帖子提及,这次是官方全文深挖;③ 真正值得记的是两条:防御侧第一次有了“发现→验证→利用→补丁”全链路的单位成本标价($359/个成功 exploit,对防守方做可利用性测试反而便宜);以及那句 Takeaway——升级模型之后,扫过的代码也该重扫。
参考来源
- OpenAI《A thousand fewer paths to root》:https://openai.com/index/a-thousand-fewer-paths-to-root/