字节笔记本
2026年10月7日 · 约 11 分钟读完
MySQL 迁 Postgres:pgloader 踩坑记
把业务从 MySQL 搬到 PostgreSQL,是近年很常见的一类迁移:有人冲着 Supabase 这类 BaaS 平台去,有人要用 pgvector、PostGIS 这些 Postgres 独有的扩展,也有人只是想要更强的 JSON 处理能力和查询优化器。可选路线不少——mysqldump 加手工转换、各类 ETL 工具、云厂商的数据传输服务——但对中小型库来说,最省事的往往还是 pgloader:一份 .load 配置文件,它就能自动完成建表、类型转换、搬数据、建索引、重置序列这一整套动作。
pgloader 的工作方式值得先了解:它先从源库读取元数据,把 MySQL 的表结构翻译成 Postgres 的等价定义,再用并行的批量拷贝搬数据,最后按配置建索引、恢复外键、把自增序列拨到正确位置。换句话说,它做的不只是导数据,而是尽量把整个 schema 一并搬过去,这也是它比 mysqldump 路线省事的核心原因。
不过 pgloader 用 Common Lisp 写成,报错风格相当吓人:一句 KABOOM! 加一屏 ESRAP-PARSE-ERROR,第一眼像出了大事故,实际多数只是配置语法的小问题。最近把某项目的一个 MySQL 库迁到 Supabase,短短半小时内就接连踩了四个坑。这里把每个报错的来龙去脉拆开讲清楚,最后附上一份验证过能跑通的配置模板。
坑一:SET 子句不是 SQL,值必须加引号
按写 SQL 的习惯,很容易在配置里写出这样的段落:
SET wal_buffers TO '64MB',
    max_wal_senders TO 0,
    statement_timeout TO 0;
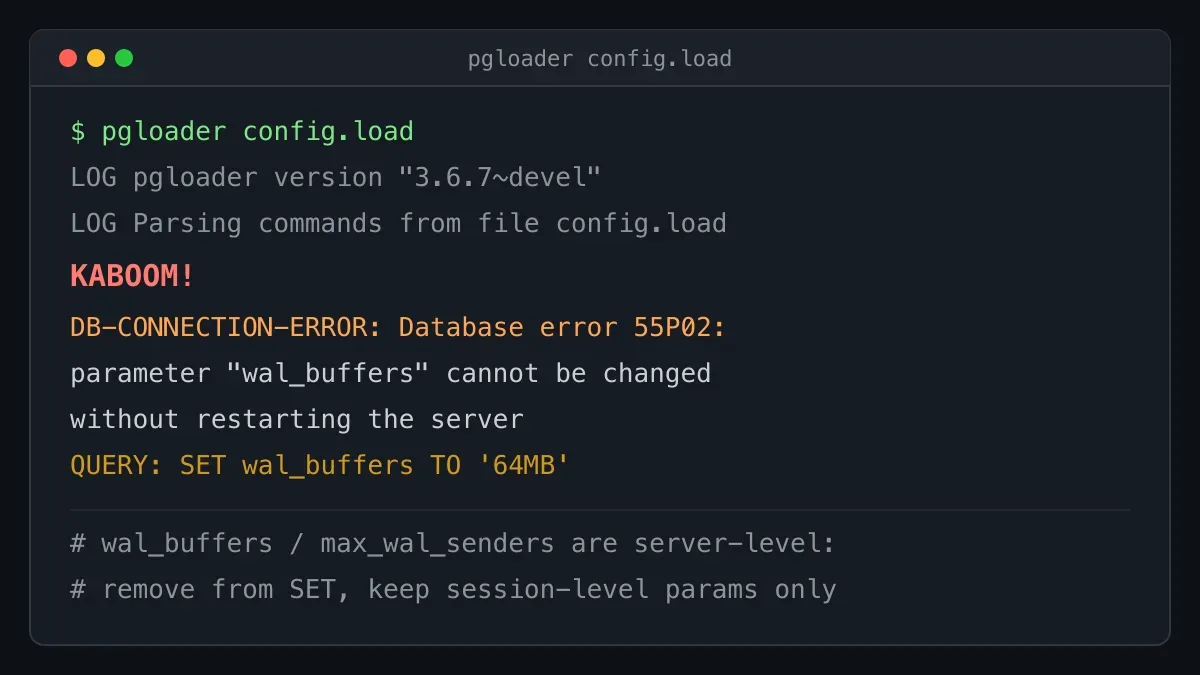
pgloader 会直接抛出 ESRAP-PARSE-ERROR,箭头指向第一个没加引号的数字。原因是 pgloader 的配置是一种自有 DSL,解析器要求 SET 子句里的所有值——包括数字——一律用单引号包起来,写成 TO '0'。顺带一提,KABOOM! 是 pgloader 对所有解析类错误的统一开场白,见得多了就知道它不代表数据出了问题,只代表配置没过解析这一关,从箭头指向的位置逐行检查即可。这是第一层;更隐蔽的是第二层问题:这几个参数里,有两个根本就不该出现在这里。
坑二:服务级参数,托管库改不了
wal_buffers 和 max_wal_senders 属于服务级参数,修改后必须重启实例才能生效。把它们写进 SET 子句,pgloader 在连接阶段就会被数据库拒绝,收到错误码 55P02:
parameter "wal_buffers" cannot be changed
without restarting the server
PostgreSQL 的参数按生效范围分层:一类是会话级,随时可以 SET,只影响当前连接;另一类是服务级,改了要重启整个实例,常规会话里根本碰不到。pgloader 的 SET 子句本质是连上目标库后执行 SET 命令,天然只能落在会话级这一类里。
Supabase 这类托管 Postgres 更进一步:普通账号没有 superuser 权限,服务级参数无论用什么方式都改不了。耐人寻味的是,一些迁移文档的示例模板里恰好就带着这行 SET,照抄必挂。正确的做法是只保留会话级参数:statement_timeout 设为 '0' 取消语句超时(大表导入时几乎必需),work_mem、maintenance_work_mem 适当调大,其余交给服务端默认值。一个简单的判断标准:凡是 PostgreSQL 文档里标注需要重启生效的参数,都不要放进 pgloader 配置。
坑三:密码里的 @,会让整条连接串变成 SQLite 文件
这次最诡异的报错:配置里明明写的是 mysql:// 开头的连接串,pgloader 的日志却显示:
Migrating from #<SQLITE-CONNECTION
  sqlite:///root/.../mysql:user@host:3306/db.load>
ERROR sqlite: Failed to open sqlite file ... Code CANTOPEN
pgloader 竟然试图把 MySQL 连接串当作本地 SQLite 文件打开。排查了半天数据源类型,最后发现根因是密码里含有一个 @ 字符。拆开一条标准连接串看会更直观:mysql://user:password@host:port/db,解析器靠协议头判断数据源类型,靠 @ 分隔凭据与主机。URL 规范里 @ 是保留分隔符,凭据里出现不转义的 @,整条 URL 的结构判断就全错了——pgloader 识别不出这是远程数据库,就退化成按文件类数据源处理,给路径拼上 .load 后缀去本地找文件,自然一无所获。
解法很简单:密码里的特殊字符做百分号编码,@ 写成 %40,冒号、斜杠、井号、问号同理。这里有一条排错经验:只要日志里出现 SQLITE-CONNECTION,而你根本没有配置 SQLite 数据源,几乎可以断定 FROM 的连接串没有被正确解析,第一件事就是去检查密码里的特殊字符。
坑四:裸 SQL 不能出现在配置顶层
后来参照文档想补一句 ALTER SCHEMA 'public' OWNER TO 'postgres';,又是一屏解析错误。pgloader 的配置文件顶层只认 LOAD 命令,它不是 SQL 脚本;要执行 SQL 语句,必须写进 BEFORE LOAD DO 或 AFTER LOAD DO 的 $$ ... $$ 代码块,而且这个块属于同一条 LOAD 命令的组成部分,要放在整条命令结尾的分号之前。散落在命令外面的任何 SQL 都会被解析器拒绝。还要注意,BEFORE/AFTER LOAD DO 在不同版本的 pgloader 里支持程度不一,遇到解析错误时,把语句挪到迁移结束后用 psql 手工执行,是最稳妥的兜底。
一份能跑通的配置模板
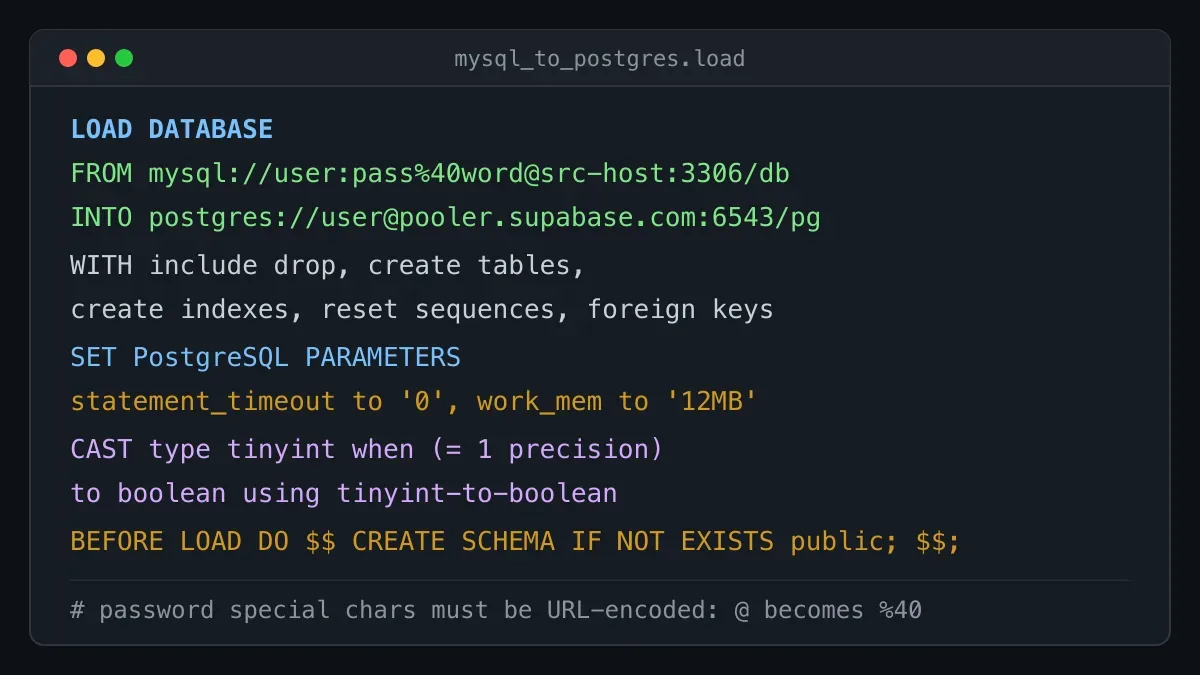
去掉所有不该出现的东西之后,一份干净可用的配置长这样:
LOAD DATABASE
    FROM mysql://user:pass%40word@source-host:3306/dbname
    INTO postgres://user:pass@pooler.supabase.com:6543/postgres

WITH include drop,
     create tables,
     create indexes,
     reset sequences,
     downcase identifiers,
     foreign keys

SET MySQL PARAMETERS
    net_read_timeout  = '120',
    net_write_timeout = '120'

SET PostgreSQL PARAMETERS
    maintenance_work_mem to '128MB',
    work_mem to '12MB'

CAST type datetime when default "0000-00-00 00:00:00"
        to timestamptz drop default using zero-dates-to-null,
     type tinyint when (= 1 precision) to boolean
        using tinyint-to-boolean

BEFORE LOAD DO
    $$ CREATE SCHEMA IF NOT EXISTS public; $$;
几个要点:include drop 会先删掉目标库的同名表再导入,指向生产库时务必三思;downcase identifiers 把标识符统一转小写,符合 Postgres 惯例;MySQL 侧的 net_read_timeout、net_write_timeout 调大,是为了避免拉取大表时连接被掐断;CAST 规则处理两类最常见的类型陷阱——MySQL 的零日期 0000-00-00 在 Postgres 里是非法值,需要显式转成 NULL,tinyint(1) 常被当作布尔使用,也要用 tinyint-to-boolean 显式转换。ALTER SCHEMA 这类语句,放进 AFTER LOAD DO 或迁移结束后手工执行。
还有一个容易忽略的细节:模板里的 6543 是 Supabase 的连接池端口,走的是事务级连接池,跑大规模导入时更稳的做法是改用直连端口,把连接池留给日常运行时流量。
方案对比与延伸思考
如果 pgloader 实在跑不通,还有两条路线。一条是 mysqldump 导出、sed 清洗、psql 导入:可控性最强,不依赖 pgloader 的版本行为,但 ENGINE=InnoDB、LOCK TABLES 这些 MySQL 方言要自己清理,序列值和布尔类型也得自己收尾,适合 schema 简单的场景。另一条是云厂商的数据传输服务,适合大库、停机窗口敏感的业务,但托管库的权限限制同样绕不过去。
选型的粗略经验是:库小、追求快,直接上 pgloader;pgloader 反复报错且时间紧,退回 mysqldump 路线;库大、停机敏感,交给专业迁移服务。几点通用建议:动手前先用 mysql 客户端和 psql 分别验证两条连接串,把网络与权限问题排除在外;大库导入放在 tmux 里跑,防止 SSH 断连毁掉数小时的工作;迁移完成后逐表核对行数、抽查自增序列的当前值,应用侧再完整回归一遍读写。序列尤其值得单独强调:如果 reset sequences 没有生效,新插入的行会立刻主键冲突,而这类问题往往要等到第一次写入才暴露,是最容易被忽略的迁移后遗症。
pgloader 的报错看着唬人,把这四个坑排掉之后,中小型库的迁移本身只要几分钟。工具的"难用"往往不是能力问题,而是它有一套自己的语法假设——读懂这些假设,比换工具更重要。