字节笔记本
2026年11月3日 · 约 4 分钟读完
引导 vs 规则:写 skill 之前先看模型和样本
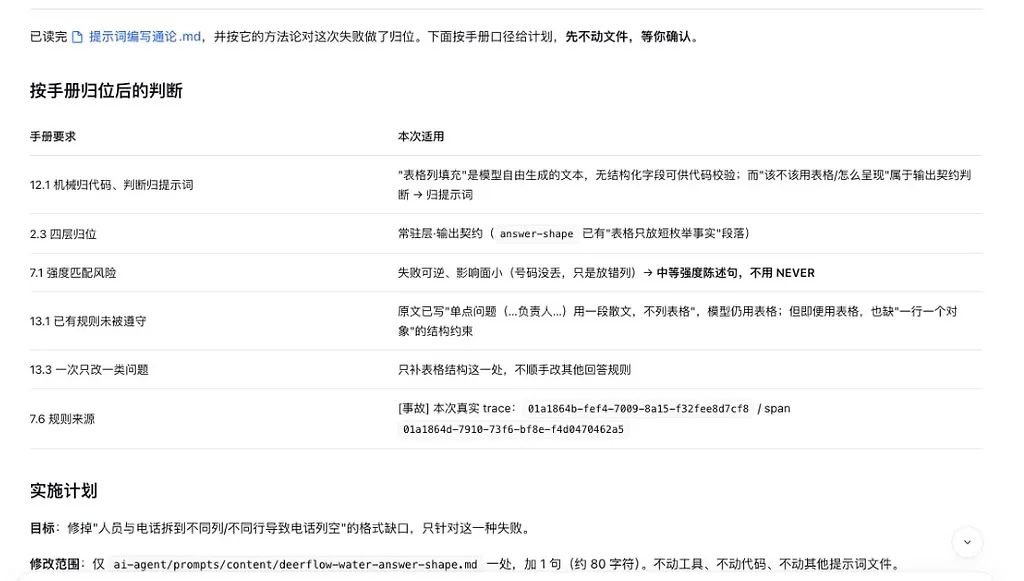
写 agent 的 skill 和提示词,「写得越细越好」是大多数人的第一直觉。LINUX DO 网友月城(@chinalives)11 月 3 日发帖,用自己公司的实践把这个直觉翻了个面:他克隆了 Codex、ZCode、DSH 三家的源码让 AI 学习后生成了一份《提示词编写通论》,核心发现是:规则该写多细,取决于模型能力和样本干净程度,不是一层不变的。
一、来源:源码学习加 AI 总结
这份通论不是手写的方法论文档,而是「源码学习加 AI 总结」的产物:作者克隆了 Codex、ZCode 和 DSH 三家的源码,让 AI 学习后生成通论,用来优化公司 agent 的 skill 和提示词。附件《提示词编写通论_脱敏版.md》97.3 KB,需登录才能下载;帖子本身 5 个赞、6 条回复,但讨论区的价值远超文档本体。
二、两条路线:引导与规则
月城自己的路线偏「引导」:他的项目环境跑 27B 模型,通论偏引导型,规则是弱性规则。实践做法是先给 agent 一份「业务世界观」(各业务的关联、主子级关系、名词解释),再加常见问题的引导思路,效果反而不错。他的对比经验是:用 DeepSeek 和 GPT 优化过的 skill 和系统提示词偏向强规则约束,反倒会让 agent 表现过于死板生硬。
评论区获赞最多的技术回复来自 steeeverlerer,他把这个观察整理成了一个显式的「能力-样本」框架:模型能力强就以引导为主,能力弱就以规则为主;接触的数据和样本干净,就让模型自己从样本中提炼规律;脏的话,事先过滤、事中避免脏资料扭曲模型注意力方向、事后设置测试保证效果。引导的具体手法是用模型预训练过的术语(如渐进式披露、浅模块、接口契约)直接告诉模型基本目标和背景,加少量高质量样本激发能力,不必讲述大量执行过程和注意事项。无人值守长跑另有补充:工作产物本身会污染上下文,需要规则加渐进式披露、必要测试打回不合格动作、子代理机制和止损机制。终极结论一句话:控制 AI 的行为,还得把它的工作环境搞好。
三、渐进式披露的先例
steeeverlerer 还推荐了 Matt Pocock 的 writing-for-agents skill(mattpocock/skills 仓库,MIT,直读已到 31.1 万星),核心思路与上述框架同频:入口文档保持精简,用指针指向深层材料;删掉 no-op 指令(不改变模型输出的废话)。渐进式披露在这里不是新概念,但把它和「模型能力 vs 样本质量」的选型挂钩,是这份讨论的增量。
四、冷水:四条都得泼
一,方法论的科学性存疑:通论是 AI 生成的,生成过程本身没有公开方法,评判标准也没建立。二,「引导型」的适用边界很窄,作者自己承认前提是「模型能力稍强」:27B 本地模型、干净业务数据,别把引导写成放之四海的银弹。三,附件看不到全文,只能写讨论区披露的方法论,不要假装读过 97.3 KB 的原始文档。四,样本量:一个人的公司项目经验加一个帖子的讨论,标题里的「通论」二字本身就值得打引号。
五、判断
社区讨论比文档本身更有价值。这不是贬低月城的工作,而是这类帖子的正确打开方式:文档提供素材,讨论提炼框架。「引导 vs 规则」的选型第一次被做成显式决策表:先看模型能力,再看样本干净程度,然后才决定写多细。对 skill 作者来说,这张表比任何模板都好用。
来源:LINUX DO 原帖 linux.do/t/topic/3113331/1(第一手,2026-11-03,@chinalives);Matt Pocock skills 仓库 github.com/mattpocock/skills(2026-11-04 直读)。