字节笔记本
2026年10月7日 · 约 10 分钟读完
Proxyman 脚本实战:把抓到的请求数据自动存成文件
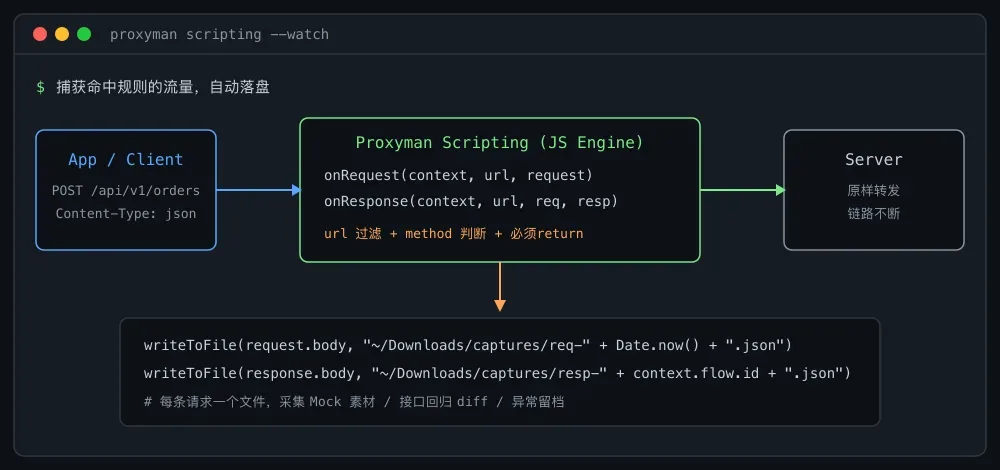
调试移动端或桌面应用的接口时,最重复的劳动莫过于在抓包工具里逐条翻看请求:找到目标接口,复制请求体,粘贴存档。一两条尚可,当你需要对比同一个接口在不同版本间的请求差异,或者要为后续的 Mock 准备一批真实样本时,手动导出就撑不住了。抓包工具自带的单条导出解决不了规模问题,你要的从来不是某一条请求,而是凡是命中规则的请求,全部自动写成文件落盘。macOS 上的抓包工具 Proxyman 为此提供了 Scripting 机制,用 JavaScript 就能把这件事做成全自动流水线。
Scripting 是什么,怎么挂到流量上
Proxyman 是 macOS 平台主流的 HTTP/HTTPS 抓包调试工具,多数开发者只用它看请求列表、改改请求头。它其实还内嵌了一个 JavaScript 脚本引擎:每一条请求或响应经过代理时,都会触发你写的回调函数。入口在 Tools 菜单的 Scripting(快捷键 Option+Command+I),新建一个 Script Entry,配上 URL 匹配规则,勾选 Run Script on Request 和 Run Script on Response,代码写完点 Save & Activate 即刻生效。脚本是热更新的,改完保存就作用于后续流量,不用重启抓包会话。
有两个容易忽视的细节。其一,脚本不是全局生效的,它必须挂在一个匹配规则上,URL 匹配不上,脚本一行都不会执行,调试时先确认规则写对了;其二,同一个条目里请求和响应两个阶段可以独立开关,只想抓响应就把请求侧关掉,省去无谓的执行开销。
同类能力在别的工具里也各有实现:Charles 的断点修改每次都要人工点击确认,适合偶发的一次性改动;mitmproxy 靠 Python 插件扩展,功能强大但需要单独维护一个脚本工程,还要在终端里起进程。Proxyman 的脚本直接挂在某条 URL 规则上,编辑器与代理融为一体,改代码和看效果在同一个窗口里完成,适合调试现场快速迭代。
顺带一提,抓 HTTPS 流量的前提是先在手机或电脑上安装并信任 Proxyman 的 CA 证书,这一步与脚本无关,却是所有抓包工作的地基,换了新设备或新环境时先检查它,免得脚本写好了却抓不到密文。
两个回调,一条铁律
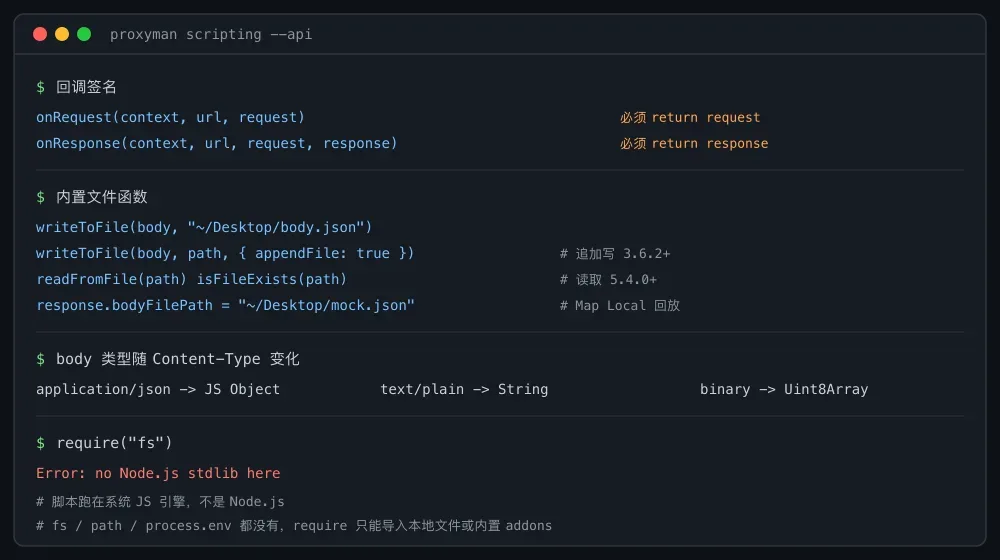
Scripting 的核心只有两个回调:onRequest(context, url, request) 在请求转发前触发,onResponse(context, url, request, response) 在响应返回时触发。request 对象上有 method、scheme、host、path、queries、headers、body 等字段,response 对象上有 statusCode、headers、body。
一条铁律必须记住:两个回调都要把对象 return 回去。Proxyman 的脚本不是旁观者而是加工者,你不 return,这条请求的转发链路就断了,客户端拿到的就不是正常响应。只想观察、不修改,就原样返回 request 或 response。也因为这个设计,脚本里的修改会真实地发给下游服务,调试时一定要分清自己处于观察模式还是改写模式,别把测试流量原封不动打进了生产。
body 的类型随 Content-Type 变化:JSON 和表单进来是 JS 对象,纯文本是字符串,二进制是 Uint8Array。想统一处理,先判断类型,再决定要不要做序列化。context 里则带着脚本名、命中的规则,以及这条请求在会话内的唯一标识 flow.id,给落盘文件命名时非常好用。
落盘脚本:从手动导出到自动存档
写文件不需要任何第三方库,Proxyman 内置了 writeToFile 函数,三种常用形态覆盖大多数场景:
// 覆盖写,同一个路径会互相顶掉
writeToFile(response.body, "~/Desktop/body.json");
// 用 flow.id 命名,一条请求一个文件
writeToFile(response.body, "~/Desktop/sample-" + context.flow.id);
// 追加写,适合日志式收集
writeToFile(request.body, "~/Desktop/log.txt", { appendFile: true });
文件命名策略值得想一想:用时间戳命名,文件按产生顺序天然可排序,适合观察时序;用 flow.id 命名,请求和响应能凭同一个 id 配对成组,适合做请求响应的成对分析。按需选择,必要时把两者拼进同一个文件名。
把回调、过滤和落盘拼起来,就是一个完整可用的采集脚本:
function onRequest(context, url, request) {
  if (request.method === "POST" && url.includes("/api/v1/orders")) {
    var name = "req-" + Date.now() + ".json";
    writeToFile(JSON.stringify(request.body, null, 2),
                "~/Downloads/captures/" + name);
    console.log("saved: " + name);
  }
  return request;
}

function onResponse(context, url, request, response) {
  if (url.includes("/api/v1/orders")) {
    var name = "resp-" + context.flow.id + ".json";
    writeToFile(JSON.stringify(response.body, null, 2),
                "~/Downloads/captures/" + name);
  }
  return response;
}
脚本里的 console.log 会输出到脚本编辑器的日志面板,写盘成功与否、走到了哪个分支,都靠它确认,比反复翻文件夹快得多。配套的读取接口是 readFromFile 和 isFileExists,前者把本地文件读回脚本,后者判断文件是否存在。再配合 response.bodyFilePath,可以把磁盘上的某个文件直接映射成响应体,等价于 Map Local 工具。于是采集和回放就闭环了:先落盘真实响应,稍作整理再交给 Map Local 回放,脱离后端环境也能复现完整链路。
最大的坑:这不是 Node.js
网上流传的示例,包括不少 AI 生成的代码,常按 Node.js 的思路写:require('fs') 读文件,require('path') 拼路径,process.env 取环境变量。在 Proxyman 里这些一行都跑不通。它的脚本跑在系统 JavaScript 引擎里,没有 Node 标准库;require 只有受限用途,用来导入本地 JSON 或文本文件,以及内置 addons(比如生成 UUID)。文件读写只认 writeToFile、readFromFile、isFileExists 这几个内置函数,路径用波浪号开头。可写位置也有讲究,桌面、下载这类用户目录最稳妥,往系统目录里写大概率因沙盒权限失败。
这类 Node 思路的示例往往长得很像正确答案:结构工整、回调齐全、还替你处理了时间戳命名,唯独运行环境假设错了。识别的办法是先问一句这个环境有没有 Node 标准库,没有的话,fs 和 path 一概不可信。
理解了这一点,报错时才有排查方向:遇到 require 报错,八成是按 Node 习惯引了标准库,换成内置函数或内置 addons;写文件失败,先检查目标目录是否存在、有没有写权限,别一股脑往系统目录里塞。
适用场景与三个提醒
自动落盘最典型的用法有三类。一是接口回归对比:同一个接口在新旧版本里各采一批样本,落地成文件后用 diff 工具比对,参数漂移一眼可见,比肉眼在抓包界面里逐字段对比可靠得多。二是给 Mock 采集素材:真实响应落盘之后稍作整理,就是 Map Local 的数据文件,前端联调不再被后端进度卡住。三是异常留档:联调扯皮时最有说服力的就是现场证据,把请求体和响应体原样存下来,责任边界立刻清晰。
三个提醒值得放进你的脚本模板。第一,过滤条件尽量前置,脚本对每条命中规则的流量都会执行,先判断 URL 和 method 再写盘,别让无关流量陪着读写磁盘。第二,序列化前先确认 body 的类型,JSON 对象再 stringify,二进制直接写 Uint8Array,别徒劳地转字符串。第三,抓生产环境流量时,落盘文件里可能带着 token、手机号这类敏感字段,注意存档位置,并定期清理。
把重复的调试动作脚本化,正在成为开发工具的共同方向:mitmproxy 的 Python 插件、Postman 的前置脚本、Chrome DevTools 的本地覆盖,都在把人肉重复变成代码自动。为常用调试动作维护一个小小的脚本库,下次再遇到千奇百怪的网络问题时,就能少点几次鼠标,把精力留给真正的问题本身。