字节笔记本
2026年10月7日 · 约 8 分钟读完
React 信息流组件演进:从三十行原型到生产级
打开任何一个内容类产品——社交媒体、新闻客户端、技术社区——几乎都是同一副面孔:一列内容卡片往下排,底部一个"加载更多",或者滑到底自动续上。信息流是前端最常见、也最容易被低估的界面模式:内容平台把整个产品压进这一列卡片里,排序决定用户看到什么,交互决定用户停留多久。写一个能跑的原型只要三十行代码,但要扛住真实用户和真实数据量,中间隔着数据层与性能层两道坎。本文从最小可用的 React 组件出发,把这条演进路线完整走一遍。
一、最小可用原型:卡片、状态与限宽
一个能跑的信息流原型,只需要回答三个问题:内容用什么展示、数据放在哪里、新内容怎么进来。
展示层选卡片式布局,组件库用 shadcn/ui。它基于 Radix UI 原语构建,可访问性有保障,样式由 Tailwind CSS 驱动,Card、CardHeader、CardContent、Button 四个现成组件就能拼出一致的视觉。更关键的是它的分发方式:组件代码直接落在自己的仓库里,想改就改,没有黑盒。
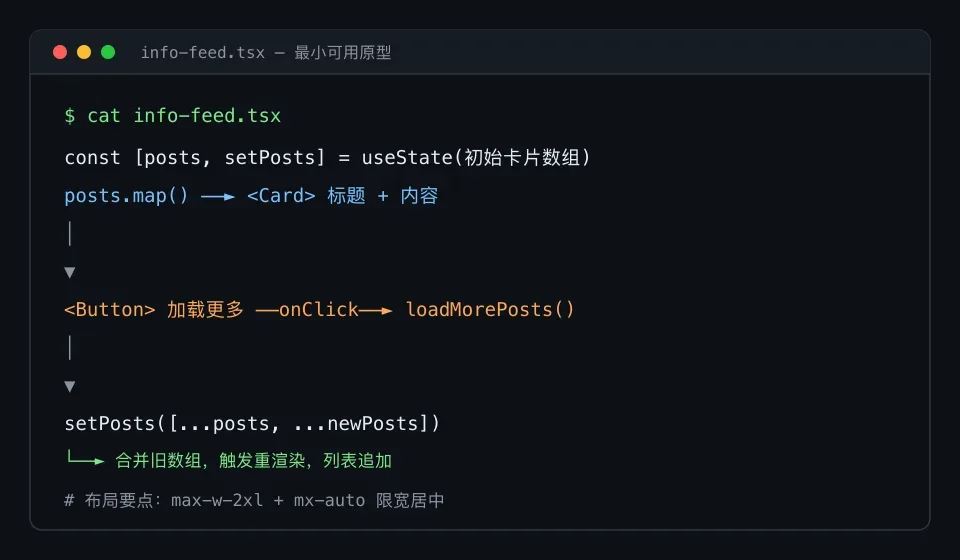
状态层用 useState 存一个帖子数组,每条帖子带稳定的 id、title 和 content;加载逻辑是一个 loadMorePosts 函数,把新帖子和旧数组合并后 setPosts,界面随之追加。原型阶段在本地造数模拟请求,足够验证交互。核心结构如下:
const [posts, setPosts] = useState(initialPosts);

const loadMorePosts = () => {
  const newPosts = fetchMore(); // 原型阶段本地造数
  setPosts([...posts, ...newPosts]);
};

<div className="max-w-2xl mx-auto p-4">
  {posts.map((post) => (
    <Card key={post.id}>
      <CardHeader><CardTitle>{post.title}</CardTitle></CardHeader>
      <CardContent><p>{post.content}</p></CardContent>
    </Card>
  ))}
  <Button onClick={loadMorePosts}>加载更多</Button>
</div>
别小看原型里定下的数据形状:每条帖子必须带稳定 id。它现在是列表 key,往后是分页游标、请求去重和埋点关联的主键。原型阶段把数据契约定对,后面每一层演进都能平滑接上;反过来,若一开始就拿数组下标当身份,换游标分页时状态管理几乎要重写一遍。
布局上还有个容易被忽略的细节:max-w-2xl 配 mx-auto。信息流不是越宽越好,单列内容限宽居中后,行长落在舒适区间,长文阅读体验明显更好——几乎所有内容型站点都这么做,不是巧合。
二、数据层:加载更多、无限滚动与游标分页
原型的"加载更多"点一下就出新内容,因为它没有网络。接上真实接口后,第一件事是选加载交互,常见的是两种模式:
- 按钮式加载更多:用户主动触发,实现最简单,请求失败重试成本低,适合内容更新不频繁的场景;
- 无限滚动:用 IntersectionObserver 监听底部哨兵元素,进入视口就请求下一页,浏览沉浸感强,是社交产品的默认选择。代价是页脚永远点不到,要补一个"回到顶部",并给列表底部留兜底内容。
无论选哪种交互,分页策略都比交互本身更关键。常见的 offset/limit 分页有个天然缺陷:用户浏览期间若有新内容插入,页码整体错位,出现重复或漏读。生产环境更推荐游标分页(cursor-based pagination):每页返回一个游标,通常是最后一条的 id 或时间戳,下一页请求带着游标走,插入新内容不影响已有页。
举个具体场景:用户刷到第 20 条时,顶部插入了 5 条新内容。offset 方案下一次请求 offset=20,会把刚插入的 5 条再拉一遍,列表出现重复;游标方案带着"第 20 条的 id"去要下一页,上游插了多少条都影响不到这次请求。聊天记录、动态列表普遍采用游标,就是这个原因。
配套地,数据获取不要手写 fetch 塞进 useState,交给 React Query 或 SWR 这类请求库更稳:缓存、去重、失败重试、加载状态都是现成的。加载中的占位用骨架屏(Skeleton)代替转圈动画,用户对即将出现的内容有预期,感知等待时间会短很多。这类库的缓存按查询键组织,游标变了查询键就变,天然把不同页的结果分开存;窗口重新聚焦时自动重拉,还能让停留很久的用户拿到新内容。
还有一个高频 bug 值得提前防:快速连点"加载更多"会同时发出多个相同请求,列表出现重复项。防护很简单——请求进行中置 loading 状态并禁用按钮,结果合并时按 id 去重。
三、性能层:列表变长之后的真正瓶颈
性能问题在数据量上去之后集中爆发。几百条卡片同时挂在 DOM 里,滚动掉帧、内存上涨都会找上门。标准解法是虚拟滚动:react-window、react-virtuoso 这类库只渲染视口内及其附近的条目,DOM 节点数恒定,列表再长滚动依然顺滑。其中 virtuoso 对动态高度内容支持更好,图文混排的信息流优先考虑。
它的原理并不复杂:容器固定高度,内部用一块总高度占位撑出滚动条,只把视口内加上下各留一段余量的条目真正渲染进 DOM,滚动时窗口随之平移。代价是每个条目要报得出高度:固定行高最好办,动态高度要么先预估再修正,要么渲染完成后回填,这正是 virtuoso 比 react-window 用起来省心的地方。
另外几件小事同样值得做:
- 列表项的 key 必须用稳定且唯一的 id,绝不用数组下标。插入新内容时,下标 key 会让 React 错误复用组件状态,这类问题平时看不见,一插数据就现形;
- 图片一律懒加载,用 loading="lazy" 或 IntersectionObserver 驱动,别让首屏之外的图抢带宽;
- 长页面的屏外区域可以交给 CSS 的 content-visibility 属性,让浏览器跳过不在视口内的渲染工作。
四、更远的方向:个性化与渲染架构
再往上走就到了产品与架构层面。信息流的内容排序通常由后端推荐系统决定,前端要做的不是把排序逻辑写进组件,而是把不同方案跑在 A/B 测试框架里,用埋点验证改动的真实收益。
渲染架构上,React Server Components 正在改变信息流的实现方式:首屏在服务端渲染并结合流式传输,用户更早看到内容,后续内容滚动到位再按需拉取。对信息流这种首屏即列表的场景尤其合适:服务端把第一批卡片直接输出成 HTML,首屏不再受 JS 包体积牵制;流式传输还能让页面框架先返回,卡片流、侧边栏按顺序补齐,首屏性能与交互体验可以兼得。
写在最后
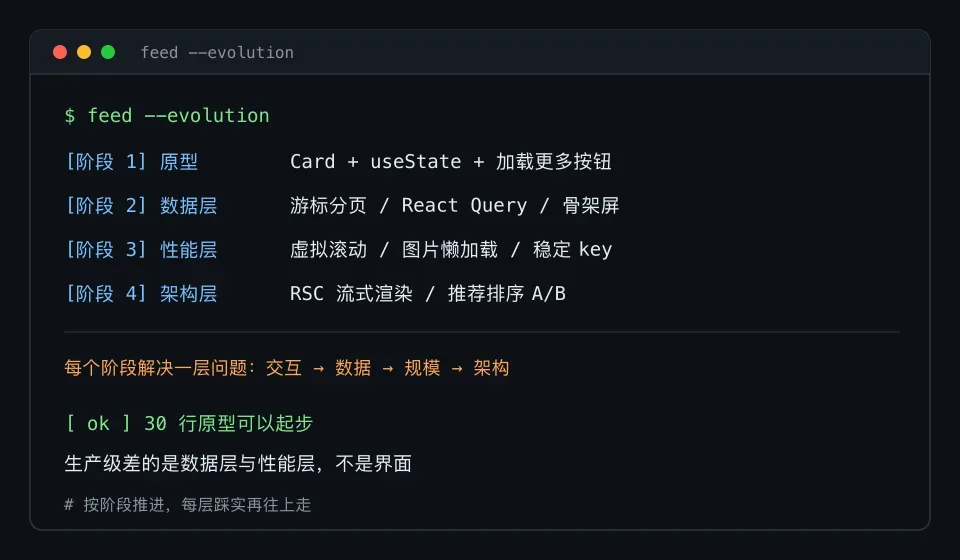
回头看,信息流界面的演进路径非常清晰:先用卡片组件加 useState 搭出最小可用原型,验证交互;然后换上游标分页和请求库,把数据层做扎实;再上虚拟滚动和懒加载,解决规模问题;最后才是推荐接入与渲染架构升级。三十行代码的原型与生产系统之间,差的从来不是界面本身,而是数据与性能这两层。下次动手之前,不妨先把这条路线画在纸上,按阶段推进,每一层都踩实了再往上走。