字节笔记本
2026年10月7日 · 约 9 分钟读完
别急着写背单词 App:先把复习调度设计对
做背单词应用,多数人的第一版都从增删改查写起:一张单词表、一个收藏接口、一个学习记录接口,半天就能跑通。真正的分水岭在后面——什么时候让用户复习哪个词。这决定了产品是「电子生词本」还是「学习工具」。最近完整走过一遍这样的需求:从单词列表和收藏起步,补上音标、发音和配图,再把艾宾浩斯遗忘曲线纳入调度,最后落成一整套 API。这里把最值得沉淀的后端部分抽出来,以 Go、Gin、GORM 和 PostgreSQL 为例。
五张表,一条关键拆分
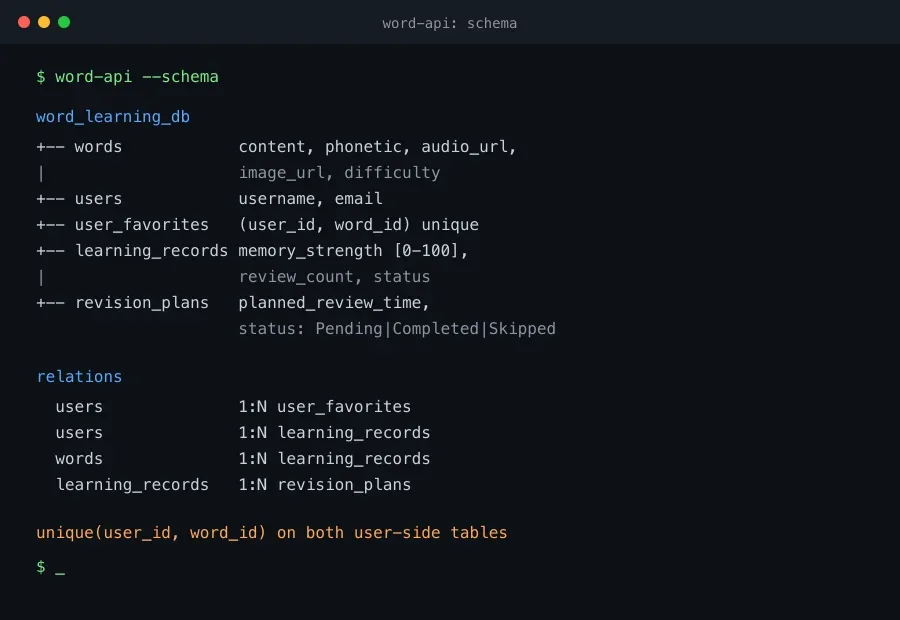
数据模型一共五张表:words、users、user_favorites、learning_records、revision_plans。
words 承载单词本体:拼写、音标、发音音频、多词性释义、例句、配图、词频、难度等级。音标和图片不是锦上添花——视觉记忆与发音输入是背单词的基本盘,建模阶段就要进表,否则后面迁移很痛。
剩下三张是用户侧的,语义各不相同:user_favorites 是用户主动标记的收藏;learning_records 是系统维护的学习状态;revision_plans 是待执行的复习任务。
值得多说一句的是收藏和学习记录为什么不合并:两者语义和生命周期都不同。收藏是用户的意图表达,可以收藏一个还没学过的词;学习记录由学习行为触发,系统是唯一写入方。推荐、榜单这类下游统计依赖的是后者,混在一张表里,每种查询都得先按状态过滤,索引也难设计。
这里藏着整个设计里最关键的一个决策:把「学习记录」和「复习计划」拆开。学习记录是状态快照——这个词学到什么程度、记忆强度多少;复习计划是任务队列——未来哪个时点要复习一次。合成一张表也能跑,但「今日待复习」会变成对全量学习记录的扫描加现算;拆开之后,它只是一次带索引的范围查询。
learning_records 的关键字段:首次学习时间、上次复习时间、下次复习时间、复习次数、学习状态、记忆强度(0 到 100);revision_plans 记录计划复习时间、实际复习时间和状态(待复习、已复习、已跳过)。两张表都要对 (user_id, word_id) 建唯一索引,既是防重,也是查询主路径。
把遗忘曲线写成代码
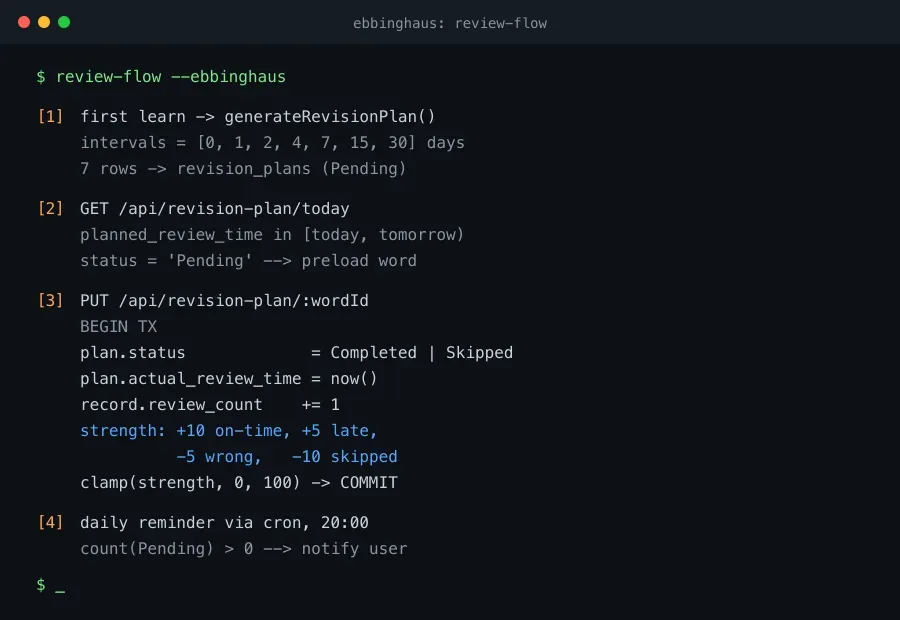
艾宾浩斯遗忘曲线的工程化,最直接的方案是一组固定间隔,按天取 0、1、2、4、7、15、30:学习当天复习一次,之后 1 天、2 天、4 天、7 天、15 天、30 天各一次,共七轮。首次学习一个单词时,一次性生成七条待复习计划:
var RevisionIntervals = []int{0, 1, 2, 4, 7, 15, 30}

func generateRevisionPlan(userID, wordID uint) error {
	var rec LearningRecord
	if err := DB.Where("user_id = ? AND word_id = ?",
		userID, wordID).First(&rec).Error; err != nil {
		return err
	}
	for _, interval := range RevisionIntervals {
		plan := RevisionPlan{
			UserID: userID, WordID: wordID,
			PlannedReviewTime: rec.FirstLearnTime.Add(
				time.Duration(interval) * 24 * time.Hour),
			Status: "Pending",
		}
		if err := DB.Create(&plan).Error; err != nil {
			return err
		}
	}
	return nil
}
另一种做法是 Anki 一系(SM-2 及其后续 FSRS)的思路:不预生成计划,每次复习完根据回忆质量动态算出下一次时间。预生成的好处是「今日待复习」退化成一次简单的范围查询,统计和提醒都很直接;代价是每学一个词多写六行,用户调整节奏时要改一组行。对多数从零起步的项目,固定间隔加记忆强度是性价比最高的起点。
记忆强度是个 0 到 100 的简化模型:按时复习且回答正确加 10,延迟复习但答对加 5,答错减 5,跳过减 10。它不够精巧,但足以把「这个词我快忘了」变成一个可排序、可筛选的数值。
一次复习状态更新里发生什么
「我复习完了」是典型的多表事务场景,四步必须同生共死:
整套接口按资源分成五组:/api/words、/api/users、/api/favorites、/api/learning-records、/api/revision-plan,统一挂在 JWT 中间件之后,用户身份从 token 里解出来,而不是信任请求参数。这是所有「按用户隔离数据」的应用都该守住的底线:userID 只能作为服务端注入的查询条件,绝不从入参来。
tx := DB.Begin()
// 1) 找到这条 Pending 计划
tx.Where("user_id = ? AND word_id = ? AND status = ?",
	userID, wordID, "Pending").First(&plan)
// 2) 写回复习结果
plan.Status = input.Status
plan.ActualReviewTime = time.Now()
tx.Save(&plan)
// 3) 更新学习记录
rec.LastReviewTime = time.Now()
rec.ReviewCount++
if input.Status == "Completed" {
	rec.MemoryStrength += 10
} else if input.Status == "Skipped" {
	rec.MemoryStrength -= 5
}
// 4) 边界夹取后保存
rec.MemoryStrength = int(math.Max(0,
	math.Min(float64(rec.MemoryStrength), 100)))
tx.Save(&rec)
tx.Commit()
任何一步 Save 失败都要 Rollback,不能让「计划已完成但强度没涨」的中间态落库。边界夹取最容易被忽略:不夹的话,连续跳过几次就会写出负强度这种脏数据。
「今日待复习」接口则是拆表红利的兑现处:查出计划时间落在今天且状态为 Pending 的行,预加载单词详情返回。完成率统计也是同一张表上的两次计数:已完成数除以总数。这里有个容易忽视的细节:所有返回计划或记录列表的接口都要记得预加载关联的单词详情,否则前端拿到的只有一串 word_id,还得再发一轮请求——这类 N+1 问题在拆表设计里尤其常见。
几个一定会踩的坑
时区。「今天」怎么算,比看上去难。示例实现里用 Truncate(24 * time.Hour) 截出零点,那是在服务器时区做的截断——处理不好,北京时间的用户会在早上八点前发现「今天」没到、或晚上的任务提前出现。正确姿势是把用户时区存下来,按当地日界生成 [today, tomorrow) 查询区间。
**计划表膨胀。**预生成意味着复习计划表的行数约是学习记录的七倍,再叠加调整产生的行。要提前想好归档策略,比如已完结超过 30 天的计划迁去冷表,别等查询慢了再补。
**缺省分页。**最顺手的 getWords 写法是一句 DB.Find(&words) 全量拉取,单词表上万行之后这就是事故。所有列表接口都强制带 page 和 limit。
**首学入口。**generateRevisionPlan 必须挂在首次学习的写入路径上。这个钩子一旦漏掉,该词永远不会再进复习队列,而且是静默失效——唯一约束加写入校验是最低成本的防御。
**并发。**同一账号在两个端同时提交同一词的复习,两个事务可能都读到 Pending 再先后写回。上乐观锁,或者 SELECT FOR UPDATE。
调度做对之后
调度之外,这套架构向外延伸都很顺:按全体用户的平均记忆强度反推单词难度,做成难度自适应;cron 定时任务每晚扫一遍 Pending 计划,给有待办的用户发提醒;成就系统和好友排行榜,本质都是这两张表上的聚合查询。整套 API 契约也和框架无关——同样的路由与调度逻辑可以换 Hono.js 跑在 Cloudflare Workers 上,提醒交给平台的定时触发器,适合不想自己养服务器的场景。
顺序不要反:先把「什么时候复习哪个词」做对,闪卡、填空、听写这些玩法才有意义。调度差一天,界面做得再精致,也是在漏水的桶上贴瓷砖。