字节笔记本
2026年10月7日 · 约 8 分钟读完
React 音标卡片复盘:高亮没生效、喇叭是空的、颜色在闪
很多开发者的练手清单里都有类似的项目:给英语启蒙做一个音标学习界面。听起来一小时收工——一个界面、一份数据、两个按钮。真动手走完一轮才发现,这个小项目把前端最容易出问题的几类环节全串了一遍:数据建模、状态设计、第三方能力接入、渲染纯函数,外加最玄学的设计尺度。本文复盘一次完整的实现与三轮改版过程,重点讲三个实际会踩到的坑。
先把音标变成一份数据
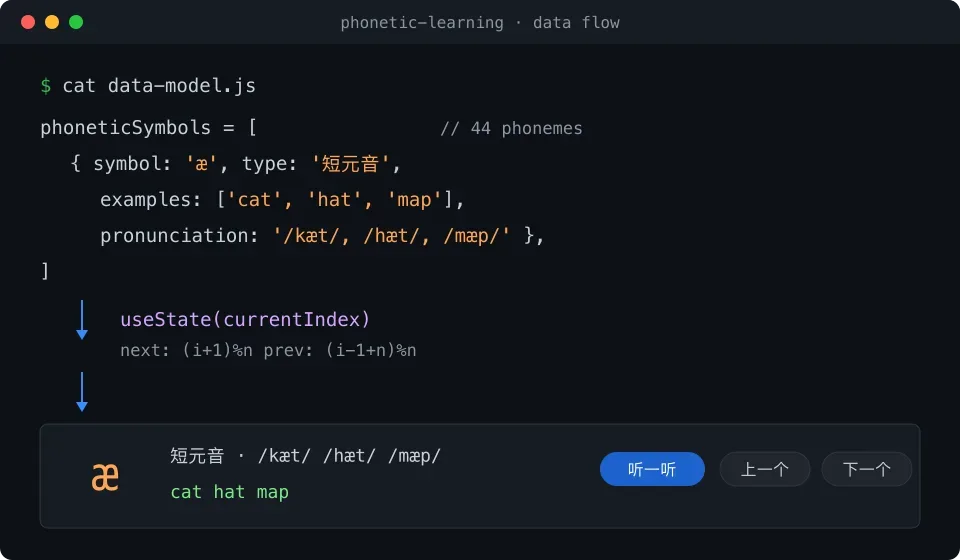
国际音标用于英语教学时,通常按 44 个音素组织:20 个元音加 24 个辅音。动手写界面之前,先把它们整理成结构化数组,这一步决定了后面所有功能的上限。每条记录四个字段就够:
{ symbol: 'æ', type: '短元音',
  examples: ['cat', 'hat', 'map'],
  pronunciation: '/kæt/, /hæt/, /mæp/' }
type 字段最容易被忽略,教学价值却最大:元音分长元音、短元音、双元音、中央元音,辅音分清浊,再细分鼻音、边音、半元音。初学者记不住术语没关系,分类本身就是记忆的挂钩。每个音标配三个示例词而不是一个,是因为单个例子容易让人把音和某个具体的词绑定死——靠 cat 记住 æ,遇到 hat 就反应不过来;三个例子才能归纳出音本身。
还有一个隐蔽但重要的问题:注音体系要统一。英语音标有英式 DJ 和美式 KK 两套传统,英式的 hot 标 /hɒt/,美式习惯标 /hɑːt/ 并带明显的卷舌 r。数据里一旦英式美式混着来——car 标 /kɑːr/,dog 又标 /dɒɡ/——后续做发音对比和高亮都会对不上号。建数据时先选定一套体系,比写界面本身更要紧。数据先行还有个好处:组件完全不关心音标有几个,换教材、扩词库都只改数组,界面一行不动。
交互骨架:一张卡片加取模轮播
界面不需要路由和复杂状态,一个 currentIndex 加两个按钮就够:
const next = () => setCurrentIndex(i => (i + 1) % symbols.length);
const prev = () => setCurrentIndex(i => (i - 1 + symbols.length) % symbols.length);
取模让导航天然循环,翻到最后再点一次回到开头。注意 prev 里要先加 length 再取模,否则从第 0 个往前翻会得到负下标。学习类界面宁可一次只给一张卡片,也不要一屏铺满几十个音标:认知负荷是真实存在的约束,一次一个、翻页成本极低,反而更符合记忆规律。顺手加一层键盘事件监听,左右方向键翻页,桌面端体验立刻上一个档次。
第一个坑:高亮函数其实一个词都没亮
为了让学习者看清目标音在单词里的位置,界面要把示例词中的音标符号换成醒目颜色。直觉写法是正则替换:
const highlight = (word, phoneme) =>
  word.replace(new RegExp(phoneme, 'g'),
    `<span class="text-blue-600 font-bold">${phoneme}</span>`);
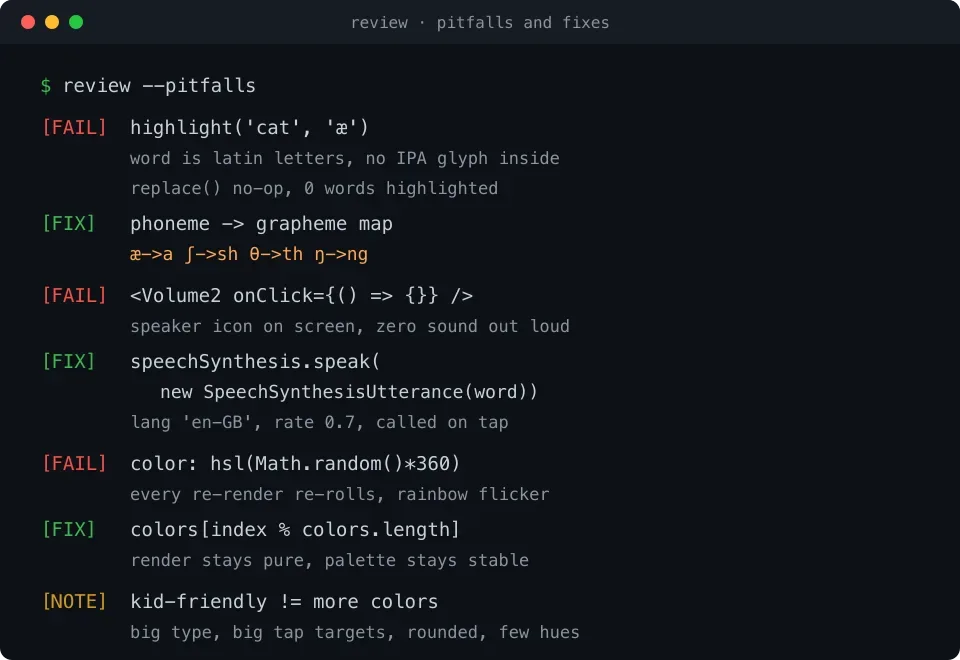
代码能跑,但一个词都不会亮。原因很基础:cat 由字母 c、a、t 组成,里面根本不存在 æ 这个字符。正则在找 IPA 符号,而英语单词是拉丁字母拼写,两者不在同一个字符集里,replace 永远空转。
正确做法是维护一张音素到字素的映射表:æ 对应 a,ʃ 对应 sh,θ 对应 th,ŋ 对应 ng。麻烦在于英语拼写不规则,同一个音常有多种写法——iː 可以是 ee(see)、ea(sea),也可以是词尾的 e(these);中央元音 ə 几乎不落在固定字母上,about 里是 a,pencil 里是 ci。所以映射表只能覆盖常见情形,剩余的老老实实按词标注高亮区间。这种「规则加例外」的数据结构在英语类工具里无处不在,早踩比晚踩好。
顺带一提:replace 出的字符串要靠 dangerouslySetInnerHTML 渲染。示例词是自己写的静态数据时风险可控;一旦词库来自用户输入或网络接口,必须先做 HTML 转义,否则就是标准的 XSS 入口。
第二个坑:喇叭图标是个空按钮
界面上摆好了 lucide 的 Volume2 图标和「听一听」按钮,看起来功能齐全,点下去没有任何声音——onClick 里是空函数。图标先行的做法在原型阶段没问题,但真要交付使用,发音恰恰是这个界面的灵魂。浏览器端最省事的方案是 Web Speech API,零依赖:
const speak = (text) => {
  const u = new SpeechSynthesisUtterance(text);
  u.lang = 'en-GB';
  u.rate = 0.7;   // 放慢语速,方便跟读
  speechSynthesis.speak(u);
};
注意 TTS 读的是单词而不是音标本身:cat 出来的是完整单词音,不是孤立的 æ。对学习场景这反而合理——音素脱离单词几乎无法示范,先听整词、再由预录的音素音频补足,是更现实的路径。若坚持纯音素发音,只能预录素材或找发音库,工作量会上一个台阶。两个细节:一是系统声音要靠 speechSynthesis.getVoices() 异步取,不同平台的音色差别很大,按 lang 前缀过滤出英语声音再挑一个清晰的;二是部分移动端浏览器要求用户手势触发语音,把调用放进点击回调里正合适。
第三个坑:颜色在渲染里掷骰子
为了让界面活泼,代码里给音标符号和示例词配了随机色:
style={{ color: `hsl(${Math.random() * 360}, 80%, 60%)` }}这行代码写在 JSX 里,每次重渲染都会重新执行:翻一页、父组件状态一动,颜色就集体换一轮,这秒是红的下一秒变绿。随机性应该发生在数据层而不是渲染层——要么用 useMemo 把配色固定下来,要么按索引做确定性取色,比如 colors[index % colors.length]。「渲染函数必须是纯函数」这条 React 基本功,恰恰最容易在这种小地方破功。
儿童风不是把颜色堆满
这个界面的视觉前后拉锯了三轮:第一版极简灰白,被评「太素」;改成粉紫渐变加随机彩色,被评「有点丑」;收敛成柔和蓝白,又被评「不太儿童」。几轮下来能提炼出几条硬结论:儿童友好感主要来自大字号、大点击区域、圆角和即时反馈(悬停放大、按钮变色),而不是高饱和度的配色轰炸;主色控制在两三种,亮色留给关键元素——音标符号本身和发音按钮;装饰元素一多,要学的东西反而被淹没。成人审美和儿童可用性之间有一条清晰的中间带:形式上克制,尺度上夸张。
设计拉锯的另一半:反馈怎么给
回头看这轮迭代,效率低的原因一半在反馈端。「有点丑」「不太儿童」这类感受式反馈,信息量几乎为零,每一轮都只能靠实现方自己猜方向,于是极简和花哨之间来回摆钟。更有效的做法是把感受翻译成可执行的约束:字号再大两档、颜色不超过三种、按钮直径不小于 48 像素、加一点悬停反馈。约束一旦具体,一轮就能收敛。这条经验不只适用于跟 AI 协作改界面——给设计师、给下属提意见时同样成立:描述问题,而不是给情绪。
收尾
最终成品只有一个组件文件,但它把小项目的完整生命周期过了一遍:先建数据,再搭交互,然后逐个补齐发音、高亮这些「看起来有、点起来没有」的功能。往延伸走还有不少顺手可加的:练习模式(放单词选音标)、听音辨位、把音标数据拆成独立 JSON 方便复用。如果想给自己或家人写个学习小工具,音标卡片是比 TodoList 有趣得多的起点——至少它真的会被用起来。