
字
字节笔记本
2026年11月7日 · 约 2 分钟读完
从 1.63 亿参数“养”到 131 亿:Riemann Computing 的生长实验
赞助API中转
¥120
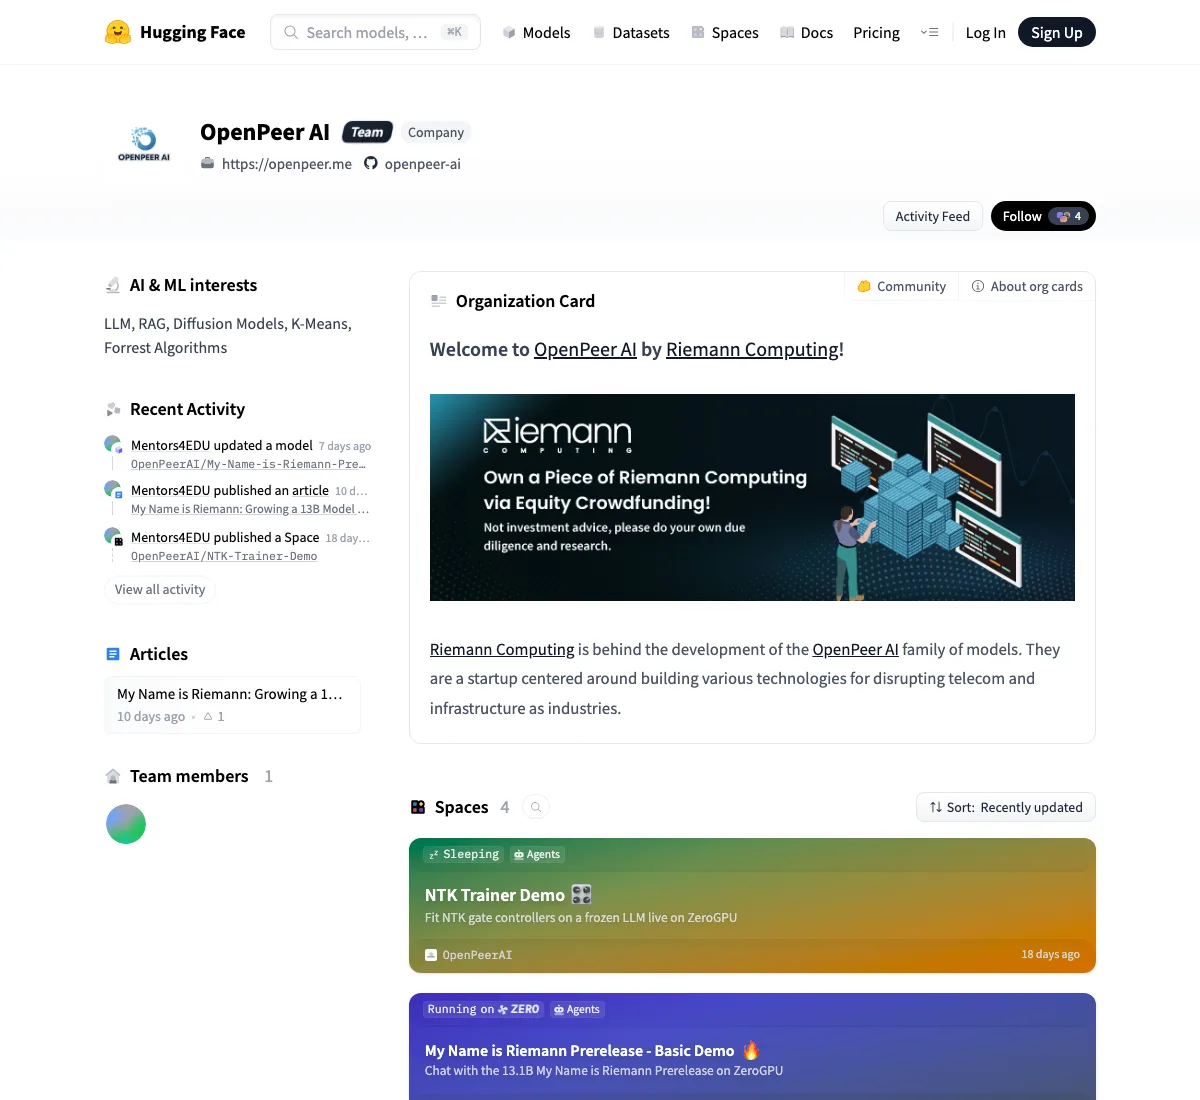
Riemann Computing 公司 11 月 6 日前后发布了 Riemann("My Name is Riemann")13.1B:从 163M 参数的种子模型出发,经 6 个阶段逐步"生长"到 13,110,702,080 参数,全程约 6.5B token 训练。项目主页与模型权重已公开(prerelease 状态;Riemann 是 Riemann Computing 公司发布的项目,不是个人项目)。
成本账(作者自报口径)
- 本地硬件约 $3,000 + 云算力约 $640;
- 终段用了 21 个节点小时、8×MI325X,约 2.16B token;
- FP32 权重约 52.4GB。
评估:提升小到作者自己都不当卖点
评估只有 1000 对提示的对比:NLL 从 1.323 降至 1.310,准确率从 67.73% 升至 67.84%——提升幅度 0.11 个百分点,作者自己也没宣称这是性能突破。没有标准基准成绩——别写"在某某基准上取得某某分",作者没跑。
这个实验真正的卖点
重点不在跑分,在**"生长"方法本身**:参数规模逐步扩大(从种子模型分阶段养大)这条路是否可行。3,640 美元的总账单对 13.1B 的终态参数,把"训一个大模型"的成本结构拍在桌面上——当然,评估提升极小这一点也诚实地说明:养大了不等于养强了。
判断
三点校准:① 成本、NLL、准确率全部为作者自报,未经独立复现,数字引用前建议按模型卡再核对一遍;② 别与任何"小模型超越大模型"的叙事混写——这篇是方法实验,不是 SOTA 宣言;③ 与价值观对齐类的模型发布(如本批 Arete-27B)也不是一回事:一个练"取向",一个练"长大"。
参考来源
- 项目主页 / Hugging Face 模型页(OpenPeer AI 组织):https://huggingface.co/OpenPeerAI
相关文章
分享: