字节笔记本
2026年11月8日 · 约 4 分钟读完
Science 调查:你的脑波数据,正在被头环厂商拿去训“大脑模型”
Science 调查:你的脑波数据,正在被头环厂商拿去训“大脑模型”
Science 杂志发布调查报道(作者 Jonathan Moens,与 Pulitzer Center AI Accountability Network 合作;11 月 8 日登上 HN 首页,72 分):消费级脑电头环厂商正在收集用户脑波数据训练 AI——而隐私政策没有明确告知。先定性:这是“隐私政策未披露的数据用途”问题,不是偷数据、不是黑客入侵;EEG 读的是注意力、睡眠、专注等粗粒度信号,也别写成“能读出你的想法”。
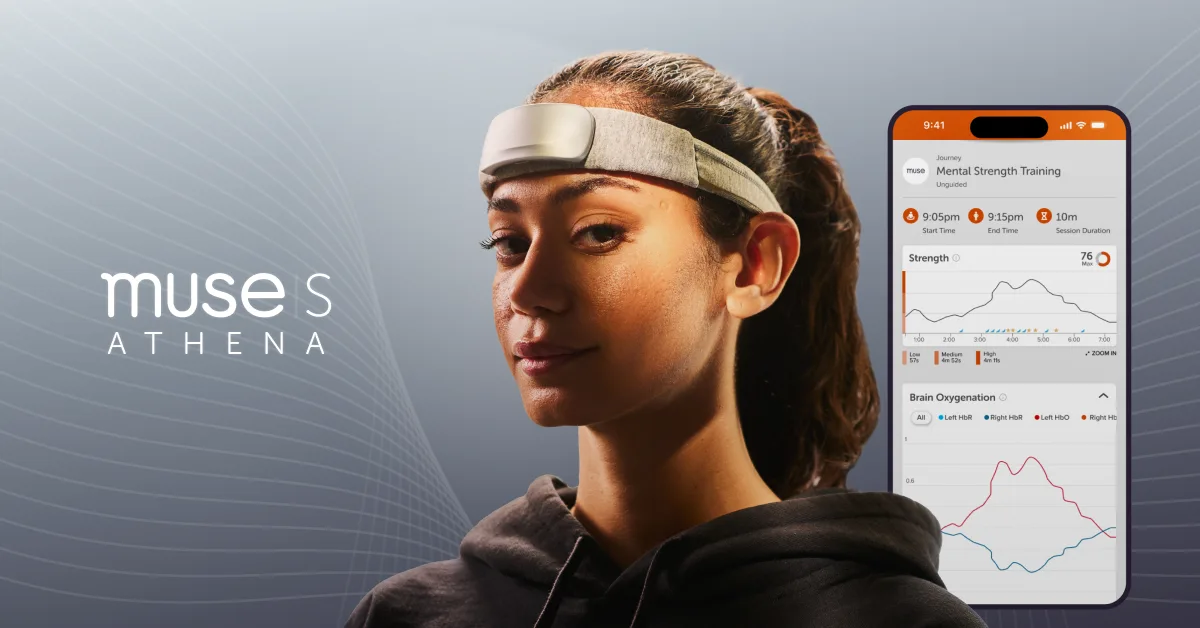
核心个案:Muse 头环与“脑基础模型”
Science 原文口径(可读文本核实):用户 Adnan Jinnah 睡前戴上 Muse 头环(加拿大消费级神经技术公司 Interaxon 的产品),不知道自己的头环数据可能正在喂给一个大脑 AI 模型;Interaxon 正在建“脑基础模型”(brain foundation model),用约 50,000 小时的用户 EEG 数据训练——数据去除了姓名、邮箱等个人信息,公司计划继续扩大这一数字。但 Interaxon 的隐私政策没有明确告知用户数据可能被用来训练 AI 脑模型;Science 指出后公司更新了政策,首席营销官 Nadia Kumentas 表示同意“应明确告知用户”。
行业总量与监管空白
同一调查(为期一年,访谈数十位神经技术专家、分析 50 多款设备的隐私政策)的行业级结论:全球消费级神经技术公司已收集数千万小时的 EEG 数据,整个生态基本不受监管;Science 审阅了 57 家收集 EEG 数据的消费级公司的隐私政策——其中 4 家完全没有隐私政策,11 家的政策只覆盖网站访客数据。另一家点名厂商:Emotiv(旧金山)告诉 Science,它训练“大型脑模型”时部分用了其高端设备用户的数据。监管侧的呼应:联合国人权事务助理秘书长 11 月初向联大提交神经技术报告,称神经数据为“独特敏感的个人数据”,GDPR 下神经数据地位不明、美国无全面联邦隐私法。
两个口径别混
约 50,000 小时是 Interaxon 一家的训练用量,“数千万小时”是全行业已收集总量——两者不可混写。另须交代核实边界:Science 原文在付费墙后(本文经多渠道直读尝试均未取得全文),以上数字以 Science 官网可读文本、作者自述与转述摘要交叉核对为据,未做任何加工。
判断
三点校准:① 厂商的逻辑闭环值得警惕:用户以为买的是“助眠/专注工具”,实际上持续贡献了训练语料——数据匿名化了,但“大脑数据的用途”这个知情同意环节被跳过了;Interaxon 在被指出后改政策,恰好说明此前的沉默是选择;② 与浏览器隐私报道(纽约时报告 Brave)不同层:脑数据是持续生理信号,退出成本远高于清 cookies;③ 监管空白是本篇真正的题眼——神经数据的敏感度被联合国点名,但 GDPR 的适用性与美国联邦立法都还没跟上,头部厂商先跑了。