字节笔记本
2026年10月7日 · 约 7 分钟读完
样本有两层数据前缀
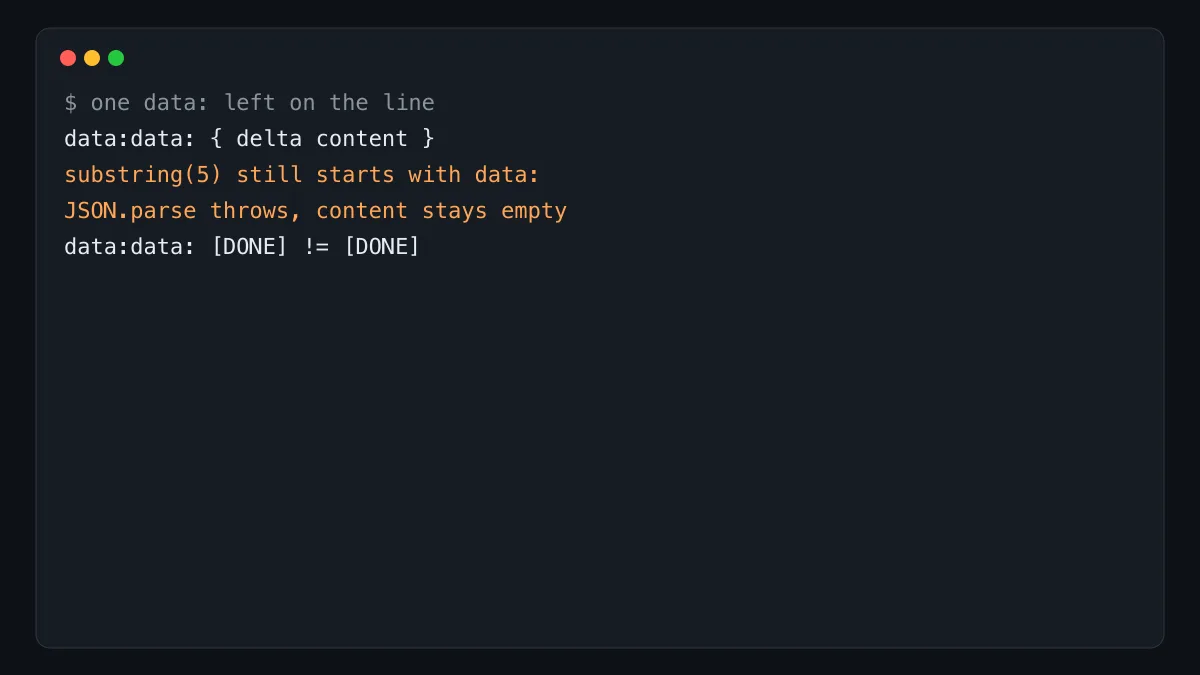
样本里每一行有效载荷都写成 data:data:,后面才是 JSON 或 [DONE]。给出的解析函数只调用一次 substring(5),剥掉开头的五个字符。剥完还剩一层 data:。注释里写的拼接结果和 done: true,按这段代码在这份样本上跑不到。
第一版按行找 data:
函数把文本按换行切开。行以 data: 开头才处理。去掉前五个字符并去掉两端空白。若剩下的字符串恰好是 [DONE],把 done 设为真。否则 JSON.parse,再取 choices[0].delta.content,拼进 content。解析抛错就跳过这一行。
样本里带“越南”的那一行,开头是 data:data:,不是单层 data:。前五个字符去掉之后,剩下的仍然以 data: 开头,后面才是花括号。JSON.parse 见到的不是对象,于是进了空的 catch。这一行的“越南”不会拼进去。下一行增量是“语”,同样被丢掉。结束前还有一行 data:data: [DONE]。去掉五个字符之后是 data: [DONE],和 [DONE] 不相等,done 仍是假。函数返回的是空内容和未完成。注释却写成内容是越南、done 为真。注释描述的是希望,不是这次剥离之后的结果。
空的 data: 行和 event:message 行本来就会被跳过,这没有问题。问题出在双层前缀。第一段增量的 content 是空字符串,停止那一段的 content 也是空字符串,同时 finish_reason 是 stop。即便前缀剥对了,空字符串也不该拼进正文。真正要拼的是“越南”和“语”,连起来是越南语。用量字段出现在停止那一段里,提示词四十九、完成两个、合计五十一。解析正文时可以不读用量。完成信号在原文里有两处:停止原因,以及后面的 [DONE]。
第二版仍只剥一层
用户接着说,实际得到的是把事件和数据原样粘在一起的文本,并要求停下来时输出内容为空、状态为 stop 的 JSON。第二版改成累积当前事件和当前数据,最后用换行拼成字符串。遇到 [DONE] 时推入停止对象。其余行仍然 substring(5) 再 JSON.parse。解析失败时,catch 把去掉五个字符之后的原文放进 currentData。
用第二版自己的例子走一遍。第一行是 event:message,记下事件。第二行是 data:data: 加上一段含 Hello 的 JSON。去掉五个字符后仍是 data: 开头,解析失败,当前数据变成这层没剥掉的文本。下一行又是 event:message,于是先把上一事件推出去。推出去的字符串是事件、空格、data:,再接上那份没剥干净的文本。于是出现两层 data:,而不是注释里的 {"content":"Hello"}。[DONE] 那一行同样对不上精确字符串,不会走停止对象那一支,而是落进 catch。注释里的两行输出,这段代码在它附带的例子上产生不出来。
先剥到能解析再取字段
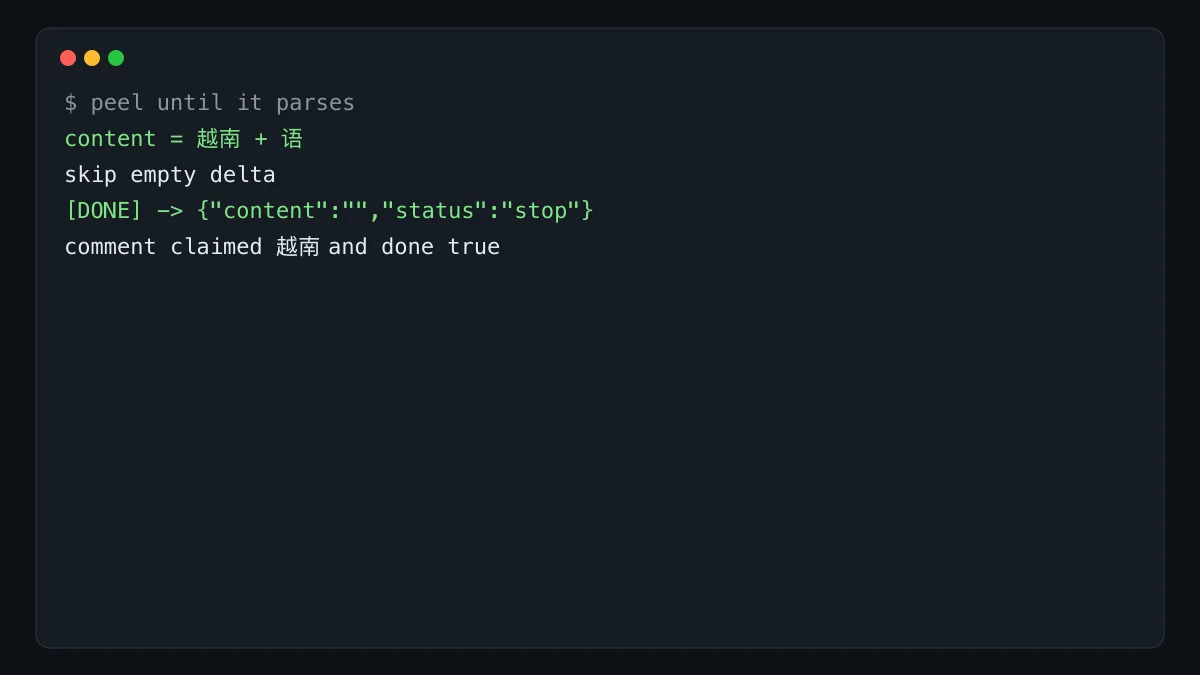
对以 data: 开头的行,循环去掉这个前缀,直到剩下的是 [DONE],或能被 JSON.parse 接受。不要只去一次。[DONE] 对应的输出按用户后来的要求,是内容为空、状态为 stop。能解析时只取增量里的 content。空字符串不要拼接。finish_reason 为 stop 可以作为结束的旁证,但用户要的停止标记写在 [DONE] 那一支。事件名保持 event:message。不要把整段原始 JSON 再嵌进输出。
标识、指纹和创建时间对拼接正文没有用,解析时丢弃。第一版返回对象,第二版返回字符串。两版不要混用同一种调用方。调用方若期待 { content, done },就不要改成多行文本还不改调用处。
把带“越南”的那一行单独拿出来。它以 data 加冒号开头,所以第一版会进入处理。去掉五个字符之后,剩余部分的开头仍是 data 加冒号,接着才是花括号。解析器把这段剩余交给 JSON 解析。解析器期望的是对象或数组,见到字母会失败。失败被吞掉,内容字符串保持为空。下一增量“语”走同一条路。所以两次增量都不会出现在结果里。注释里的越南,只有在第二次把前缀去掉、解析真正得到对象之后才会出现。
结束标记那一行同样以两层前缀开头。去掉一层之后,剩下的文本是 data、冒号、空格和方括号里的 DONE。它和单独的 DONE 不相等,因此不会把完成标记设为真。若有人把比较改成包含 DONE 四个字母就算完成,又会误伤正文里恰好出现这四个字母的增量。比较必须发生在前缀已经剥干净之后,并且是整段相等。
第二版在解析失败时保留去掉一层之后的原文。于是推入结果的是事件名、再加一层 data、再加没剥掉的那一层。用户看到的粘连文本就是这样来的。要得到内容字段,必须在解析成功的对象上取增量,而不是把原始行拼进结果。停止对象只在整段等于 DONE 时写入。解析失败不能当成停止。
用量数字只说明那一次停止片段带了统计,不参与正文。空的增量在停止片段和开头片段里都出现过。拼接时跳过空字符串,避免在越南语中间或前后多出无意义的空段。标识和指纹每个片段都重复,留下第一次就够,解析正文时可以不存。
再对着原始片段看完成的两处信号。开头一段增量的正文是空的,角色是助手。中间两段才分别是越南和语。再下一段正文又是空的,结束原因写成停止,并带上用量。再往后才是单独的结束标记。解析正文只拼接非空增量,结果应是越南语。结束标记才改成用户要的空内容和停止状态。结束原因可以用来核对,但不要把它误当成已经剥干净的结束标记。第一版把完成放在布尔字段上。第二版把完成放在一行文本里。调用方只能认一种。注释里的成功输出,要在剥掉两层前缀之后再断言。只剥一层就去比较注释,测试会一直红,问题却在前缀次数,不在字段名。
验收时用两行就够。一行是双层前缀加上含有一个字的对象,一行是双层前缀加上结束标记。期望是这个字进入正文,并且出现空内容和停止状态。若正文为空且没有停止状态,先数前缀被去掉几次,不要先改字段路径。字段路径在前缀正确之后才有意义。
样本里重复出现的标识和指纹可以忽略。创建时间对拼接也没有帮助。用量里的三个数只在停止那一段出现,用来对账可以,用来拼接不行。空正文出现了两次,一次在最前,一次在结束原因旁边。这两次都不要加进越南语。越南在前,语在后,顺序就是行的顺序。解析器按行从上到下走,拼接顺序应保持这个先后。不要按对象标识再排序,标识从头到尾是同一个。