字节笔记本
2026年10月7日 · 约 14 分钟读完
Tauri 调用 C++ DLL:Rust FFI 三层封装
桌面应用做到一半,经常会被塞过来一个头文件:这是一套现成的 C 接口库,界面你们自己包。本文的例子是一套管理磁盘镜像与快照的 DLL——建盘、建快照、预加载、挂载、提交,再加一个带进度回调的导出接口,十来个函数,纯 C ABI,扇区大小支持 4K 与 512 两种。这类库通常来自存储厂商或历史遗留的 C/C++ 工程,短期不可能重写,而界面又想用 Web 技术做,于是选了 Tauri。
选 Tauri 就要接受它的架构现实:前端跑在 WebView 里,Rust 才是宿主进程。DLL 只能由 Rust 加载,前端碰不到。所以整个问题可以收敛成一句话:怎么把一个 C 头文件,变成前端可以 await 的函数?
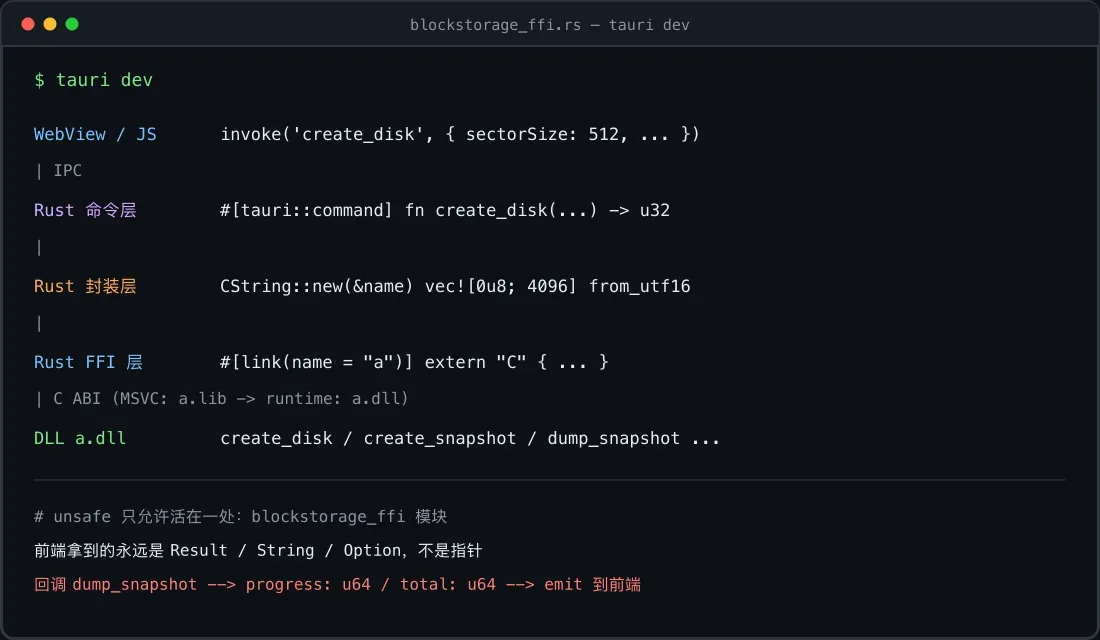
实践下来最顺手的结构是三层:FFI 声明层对齐 C ABI,安全封装层把 unsafe 关进笼子,Tauri 命令层把能力暴露给前端。逐层展开。
动手前:把接口形态分个类
这十来个函数看着杂,按签名形态其实只有四类,每类对应一套固定的封装手法:
值进值出。 load_config、create_disk、mount_snapshot 这一组长这样:参数是整数和字符串,返回 bool 或者一个当句柄用的 ID。最好处理,CString 包一层就能过。
缓冲区出参。 get_disk_list、get_snapshot_list 把 JSON 写进调用方给的缓冲区,返回有效长度。封装层负责分配缓冲区和按长度截取。
回调进。 dump_snapshot 接一个进度函数指针,C 侧在导出过程中异步往回调,传回已处理字节数和总字节数。
指针出。 get_mount_point 直接返回 const wchar_t*,指向 DLL 内部的内存,只读、不可释放,用完即弃。
分类的意义是工作量可控:四套手法各写一次,剩下的函数基本是复制粘贴。
为什么必须在 Rust 层动手
Tauri 的通信模型是前端 invoke 走 IPC,调用 Rust 侧带 #[tauri::command] 的函数,返回值序列化后回传。任何原生库的调用都被挡在这条 IPC 的 Rust 一侧——这不是限制,恰好是边界:DLL 的加载、指针、线程都收在 Rust 进程里,前端只见类型化数据。
链路因此固定为:JS invoke → Tauri command → Rust 安全封装 → extern "C" → a.dll。三层各管一段。
有人会问,为什么不让前端直接调 DLL?WebView 跑在浏览器沙箱里,既没有加载原生库的权限,JS 里也没有指针、回调、内存生命周期这些概念的对应物。让 Rust 当唯一的中间人,不是权宜之计,而是架构上唯一说得通的选择。
第一层:extern "C" 声明
对着头文件逐个翻译,先写裸声明:
use std::os::raw::{c_char, c_int, c_uint, c_ulonglong};

#[repr(C)]
pub struct DumpCallback(extern "C" fn(c_ulonglong, c_ulonglong));

#[link(name = "a")]
extern "C" {
    pub fn load_config(cfg_path: *const c_char) -> bool;
    pub fn create_disk(sector_size: c_uint, disk_size: c_ulonglong,
                       name: *const c_char, snap_name: *const c_char) -> c_uint;
    pub fn dump_snapshot(disk_id: c_uint, snap_id: c_uint,
                         save_path: *const c_char, process: DumpCallback) -> bool;
    pub fn get_disk_list(json_buffer: *mut c_char, size: c_uint) -> c_int;
    pub fn get_mount_point(disk_id: c_uint, snap_id: c_uint) -> *const u16;
    // 其余函数同理
}
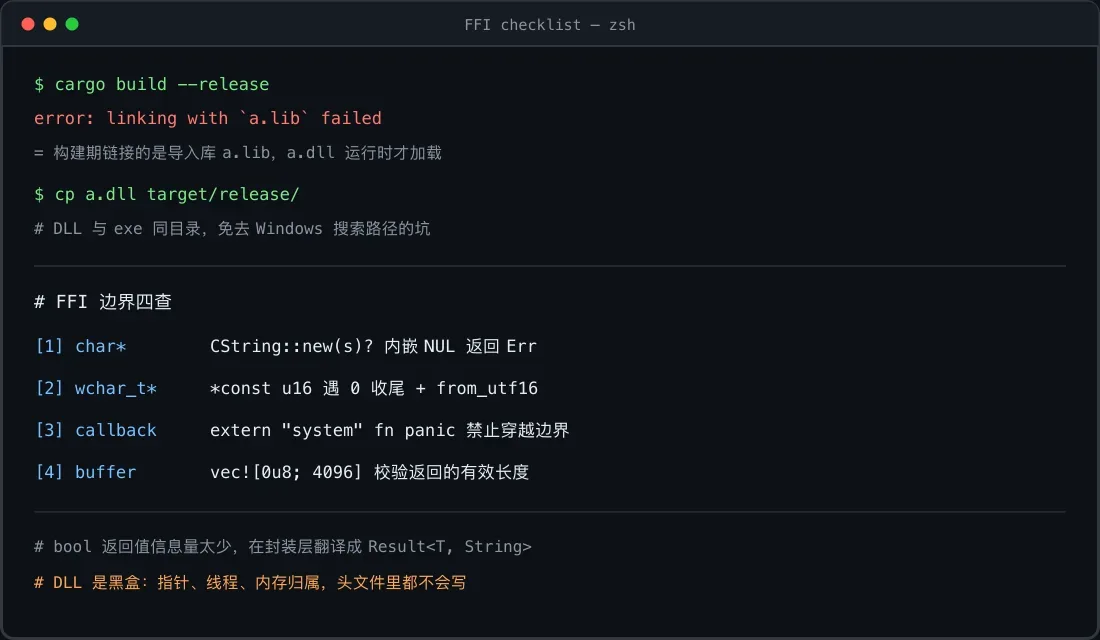
三个要点。其一,头文件把声明包在 extern "C" 里是为了关闭 C++ 的名字改写,Rust 侧的 extern "C" 与它对齐,一个字都不能少。其二,类型映射有固定对照:uint32_t 对 c_uint,uint64_t 对 c_ulonglong,别凭直觉写成 usize。其三,#[link(name = "a")] 在 MSVC 工具链下链接的是 a.lib 导入库,真正的 a.dll 到运行时才被加载——构建期需要厂商同时给 .lib 和 .dll 两个文件。返回 const wchar_t* 的接口在 Windows 上对应 *const u16,这个细节留到封装层处理。
第二层:把 unsafe 关进笼子
裸 FFI 全是指针和 unsafe,散落在业务代码里迟早出事。封装层的目标很明确:unsafe 只允许出现在这一个模块里,对外暴露的全是 Rust 类型。
字符串是最基本的翻译,&str 转 *const c_char 走 CString::new。这里有个容易忽略的坑:CString 不允许内嵌 0 字节,遇到就返回 Err,所以生产代码别无脑 unwrap,把错误往上抛;反向的 to_string_lossy 也值得记一笔——碰到非法 UTF-8 会替换成占位符,宁可丢几个字,也别让进程崩在编码上。
pub fn load_config(cfg_path: &str) -> bool {
    let c_path = CString::new(cfg_path).unwrap();
    unsafe { load_config(c_path.as_ptr()) }
}
缓冲区型接口是另一种形态。get_disk_list 的约定是调用方分配缓冲区、返回有效长度,Rust 侧用 Vec 分配、传指针、按返回值截取:
pub fn get_disk_list() -> String {
    let mut buffer = vec![0u8; 4096];
    let n = unsafe {
        get_disk_list(buffer.as_mut_ptr() as *mut c_char, buffer.len() as c_uint)
    };
    if n > 0 {
        unsafe { CStr::from_ptr(buffer.as_ptr() as *const c_char) }
            .to_string_lossy().into_owned()
    } else {
        String::new()
    }
}
最麻烦的是返回 wchar_t* 的 get_mount_point。C 侧塞回来一个 UTF-16 字符串指针,Rust 侧要自己数长度(遇到 0 停)、切 slice、String::from_utf16 转换,空指针返回 None。对外签名收敛成 Option,调用方不再接触任何指针。
这一层的价值是类型收敛:bool 换成 Result,裸指针换成 String 与 Option,魔法数字换成长度校验。从这往上的代码,再没有 unsafe。
第三层:Tauri command 与前端 invoke
封装就绪后,暴露给前端只是一层薄壳:
#[tauri::command]
fn create_disk(sector_size: u32, disk_size: u64,
               name: String, snap_name: String) -> u32 {
    blockstorage::create_disk(sector_size, disk_size, &name, &snap_name)
}

fn main() {
    tauri::Builder::default()
        .invoke_handler(tauri::generate_handler![load_config, create_disk, get_disk_list])
        .run(tauri::generate_context!())
        .expect("error while running tauri application");
}
命令函数要保持薄:只做参数转换和封装层调用,别把业务逻辑写进去,否则单测和复用都麻烦。前端一行调用:
import { invoke } from '@tauri-apps/api/tauri'

const diskId = await invoke('create_disk', {
  sectorSize: 512, diskSize: 1024 ** 3, name: 'disk01', snapName: 'init',
})
注意参数名:Rust 侧的 snake_case sector_size,到 JS 侧要写 camelCase 的 sectorSize,Tauri 自动转换;名字写错只会收到「找不到参数」的报错。命令返回 Result 的话,前端拿到的是带错误信息的 reject,比裸 bool 友好得多。另外,新增命令记得同步登记进 generate_handler,漏了只会在前端调用时报「命令不存在」,排查起来容易绕远路。
四个真正费时间的坑
三层是骨架,实战里吃掉时间的是四个细节。
回调与线程。 dump_snapshot 的进度回调是 C 在调 Rust,而且很可能发生在 DLL 自己的工作线程上,时机和频率都不受你控制。回调在 Windows 上建议声明成 extern "system" 以匹配调用约定;更要紧的是 panic 绝不能穿越 FFI 边界,否则整个进程直接 abort。回调体里只做最少的事:把进度写进通道或原子变量,回 Rust 侧再处理,要通知界面就走 Tauri 的 event 系统 emit 给前端。
链接与部署。 构建期缺 a.lib,链接直接失败;打包发布时 a.dll 必须进安装产物(tauri.conf.json 的 resources 或 externalBin),并且落在 Windows 的 DLL 搜索路径上——与 exe 同目录最省心,放别的目录就得先 SetDllDirectory,或者干脆用 libloading 拿绝对路径加载。厂商不给 .lib 时,libloading 在运行时按名解析导出函数也完全可行,还顺带解耦了编译期。
缓冲区大小。 示例里的 4096 是拍的,列表一长就会被截断。这类接口的标准问法是两次调用:第一次探需要的大小,第二次真正取数据;API 不支持探询,就把缓冲区分配得足够大,并严格校验返回的有效长度小于容量。
错误处理。 C API 的 bool 与 int 返回值信息量极少:load_config 返回 false,你不知道是文件不存在还是格式不对。在封装层把它们翻译成 Result<T, String>,至少把错误码带出来,别让前端对着一个裸 false 猜。
适用场景与替代方案
这套三层结构适用于一切「现成 C ABI 库加 Tauri」的组合:厂商 SDK、硬件驱动封装、性能敏感的算法库、历史遗留的 C++ 工程都算数。几条选型经验:函数多了(几百个)就别手写声明,用 bindgen 从头文件自动生成,改头文件后重新跑一遍即可;要在 Rust 侧直接用 C++ 类和继承,看 cxx;DLL 稳定性存疑、怕它把整个进程拖崩,就挪进 sidecar 子进程走 stdio 或本地 socket,代价是多一层序列化和部署两个可执行文件。
开工顺序也有讲究:先在纯 Rust 的单元测试里把 load_config 和 get_disk_list 跑通,确认链接、编码、缓冲区都没问题,再接前端界面。FFI 层的问题要离前端越远越好排查,等 WebView 里出现白屏再去查指针,成本完全是另一个量级。
最后一条经验:FFI 边界就是信任边界。DLL 是编译好的黑盒,指针会不会被它保存、回调会不会跨线程、字符串的内存归谁,头文件里一概不写。封装层收得越紧,这些未知就越没机会变成线上的崩溃。