字节笔记本
2026年10月9日 · 约 3 分钟读完
按 token 切模型,这套服务栈把调度拆成三步
按请求把流量分给不同模型,已经是常见做法。按 token 再切一次,理论上更能省,也更能抬质量,但现成推理栈默认「一个请求跟死一个模型」,切到一半就会打乱批处理和调度。清华 NICS 实验室的 TokenRouter 把这件事做成一套服务系统:每个模型一步之后,用 route()、send()、receive() 三个接口决定下一步去哪。
论文挂在 arXiv 2610.12242,HF 今日论文榜大约 76 到 78 票。官方代码在 thu-nics/TokenRouter,仓库 10 月 8 日才建,目前约 18 星、0 个 fork。热度在论文,不在星数。仓库快照里没有看到许可证文件,复用前要自己确认。
三个接口,而不是再写一套调度器
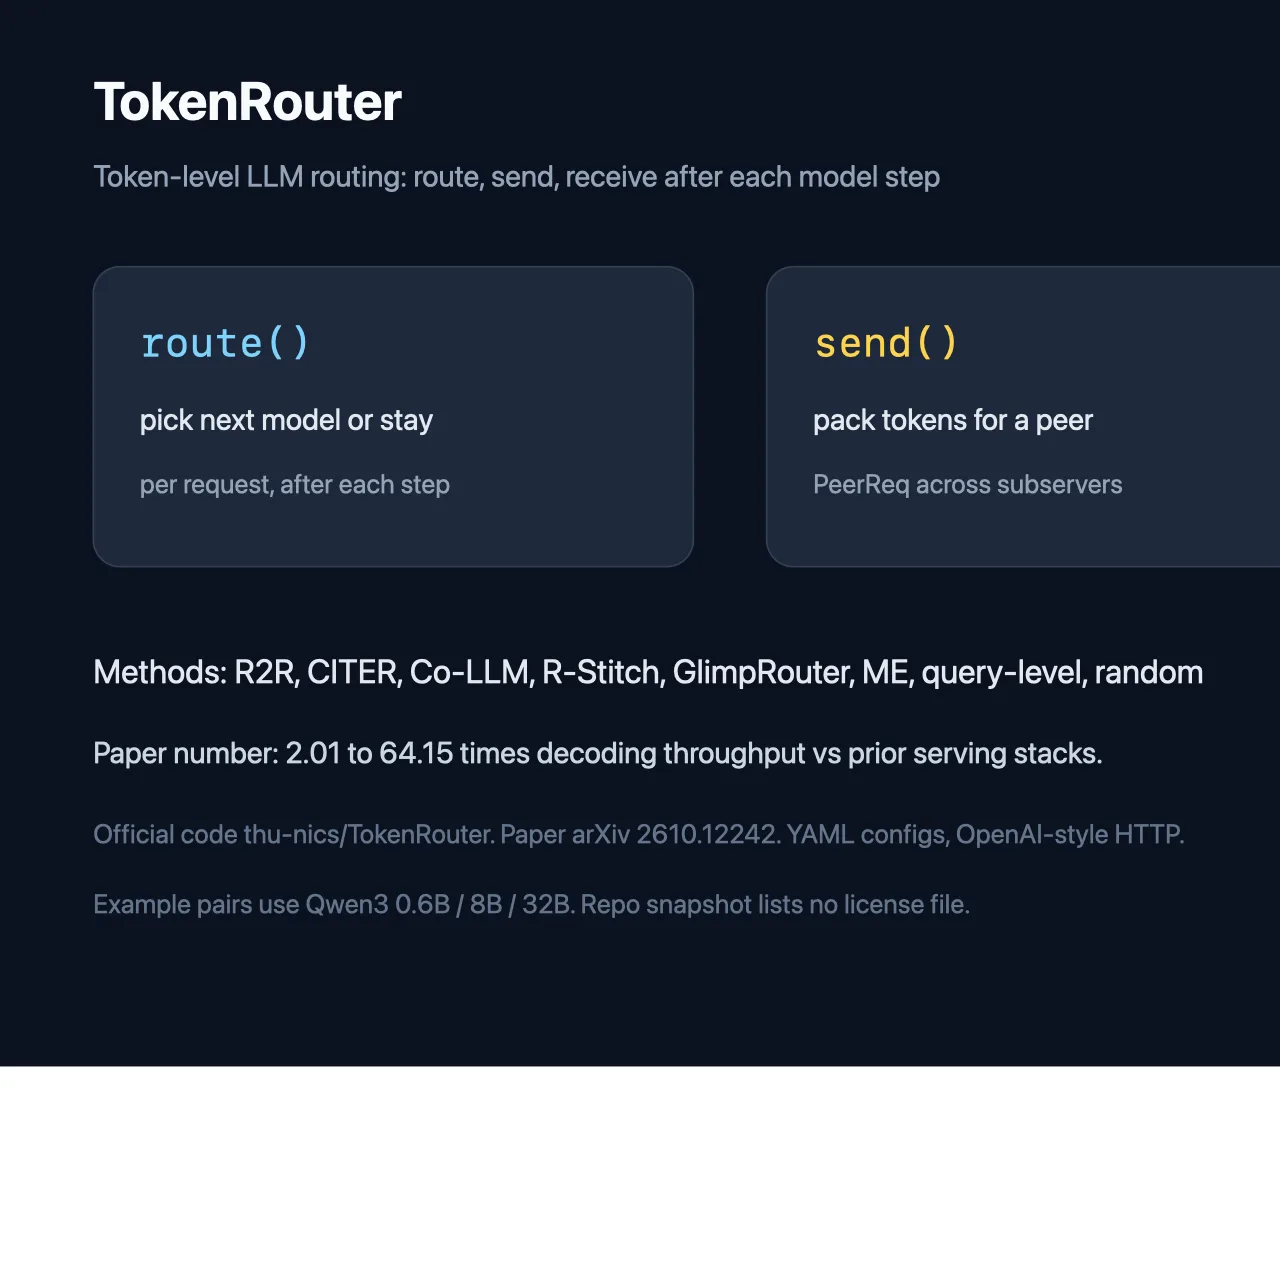
README 把开发面收成三步。route() 在每一步之后给每个请求返回下一个模型,或者继续留在本地。send() 把要交给对端的 token 打成 PeerReq。receive() 把收到的 token 合进来,合并逻辑可以自定义。方法用 YAML 切换,内置 R2R、CITER、Co-LLM、R-Stitch、GlimpRouter、ME,以及请求级路由和随机基线。对外可以走 OpenAI 风格 HTTP,也可以直接调 Python 引擎。
安装路径是 Python 3.10 的 conda 环境,再 pip install -e .,然后:
python -m tokenrouter.launch_server --config_path your.yaml目录按入口、每模型调度器、算法和执行器拆开,执行器带 CUDA Graph。多机用 peer_endpoints。同一张 GPU 上叠多个模型时,文档建议开 MPS。新方法就是继承 BaseTokenRoutingScheduler,实现那三个接口,注册,再加一份 YAML。
数字怎么读
论文写的解码吞吐是相对既有系统的 2.01 到 64.15 倍。跨度这么大,说明跟对照栈、模型和路由策略绑得很死,不宜当成「随便换就快几十倍」。示例里用 Qwen3 的 0.6B、8B、32B 配对,文档还出现过 6.0 和 27.9 这类延迟数字,以及延迟批处理脚本的 --M 2 和转移矩阵 P。这些是论文和仓库自己的对照,不是第三方复现。
适合谁
适合已经在跑多规格模型、想把「这个 token 交给小模型、下一个交给大模型」写成可插拔调度的人。仓库新、星少,接口还可能改。没有许可证文件的现状,也不适合直接塞进要审计的产品。如果你只是按请求在 8B 和 32B 之间切,现成网关就够,不必上 token 级。
和请求级路由比,它解决的是中途换模型时的批和时钟。和单模型 vLLM 比,它多了一层子服务和延迟批处理。论文数字好看,工程上先把它当研究型服务栈:能复现路由方法,再谈是不是能进线上。