字节笔记本
2026年10月9日 · 约 2 分钟读完
默认还在数 GPT-4?这条命令把分词器换成了 GPT-5
上下文窗口按 token 计费,编辑器里的字数帮不上忙。ttok 做的事很窄:把一段文本数成 token,必要时按长度截断。作者是 Simon Willison,仓库 simonw/ttok,协议 Apache-2.0,GitHub 约 401 星、21 个 fork。2026 年 10 月 9 日发了 1.0,PyPI 同一天跟上。
1.0 不是新功能堆砌。作者自己写:升到 0.4 之后,默认还是 GPT-4 的分词器,而它早该切到 GPT-5 / GPT-6 这一家。换默认,成了出 1.0 的理由。
怎么装,怎么数
安装可以走 pip、uv tool、Homebrew,或者直接 uvx。已经装过的人升一版:
uv tool upgrade ttok用法保持老样子:参数、标准输入、文件都能数;-t 截断;-m 换模型;还能把文本编成 token id 再解回去。--list-models 列出支持的名字。README 写明:This default changed in ttok 1.0。默认现在是 GPT-5 分词器。
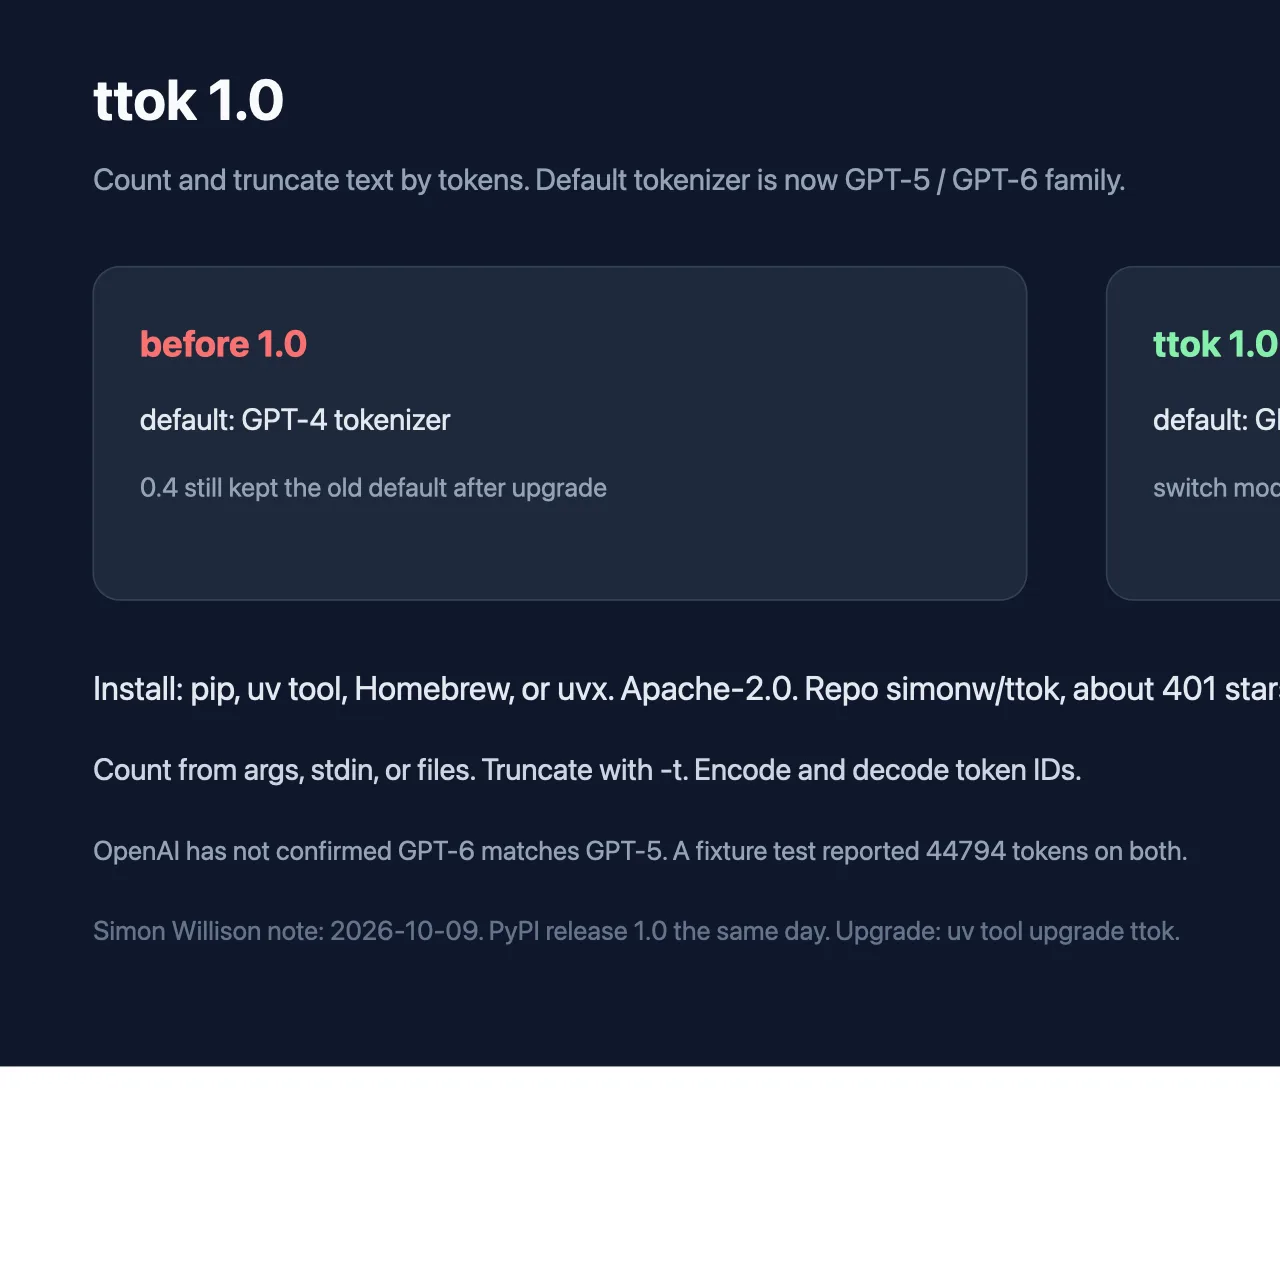
OpenAI 并没有公开确认 GPT-6 和 GPT-5 用同一套分词。作者转述一项对照:在同一组 31 个样例上,列出的七个模型(含 GPT-6 变体)都报 44794 个 token。这只能说明这份语料上看起来没变,不能写成官方保证。
适合谁
适合写提示词、截上下文、对账费用的人。它不调用模型,只做分词,所以能放进脚本和 CI。不适合当通用 NLP 库,也不该拿它估本地开源模型的长度,除非你明确换了对应的 -m。
和编辑器插件比,它能进管道。和自己引 tiktoken 比,它把默认值和模型列表收成一条命令。1.0 的实质是默认值跟上游对齐。升级之后,旧脚本如果依赖 GPT-4 计数,要自己把 -m 钉回去,避免账单对不上。