字节笔记本
2026年10月10日 · 约 2 分钟读完
模型没把握时,凭什么只看输出熵
推理轨迹越写越长,分数板却常把输出熵当成没把握的全部证据。这篇把残差流投到四个正交方向上,只在思考结束那个词上看锥体对齐,再乘上整段平均熵。方法写成 U-Space,读出头写成 U-Lens。论文号 2610.09087,本轮核到公开仓六星,协议页没有写许可证。数字以论文表为准,不是本轮复现。
四个方向,三分之二深处读一次
四个轴写成歧义、不完整、证据打架、一般不确定。词表从公开的确定和不确定用语对拉回来,再两极相减、正交化。读出层钉在网络三分之二:三百一十亿档第四十层,二百七十亿档第四十二层,小规模推理第二十七层。不另标标签,也不再采样一遍。
轨迹分写成思考结束词上的锥体对齐,乘整段下一步平均熵。类别之间用软加,不互相抵消。评测四套题,每套一千条,三颗种子。作者写明:这四类不是穷尽清单,也不是校准过的安全探测器。同一套锚点若只数关键词,既稀又矮。
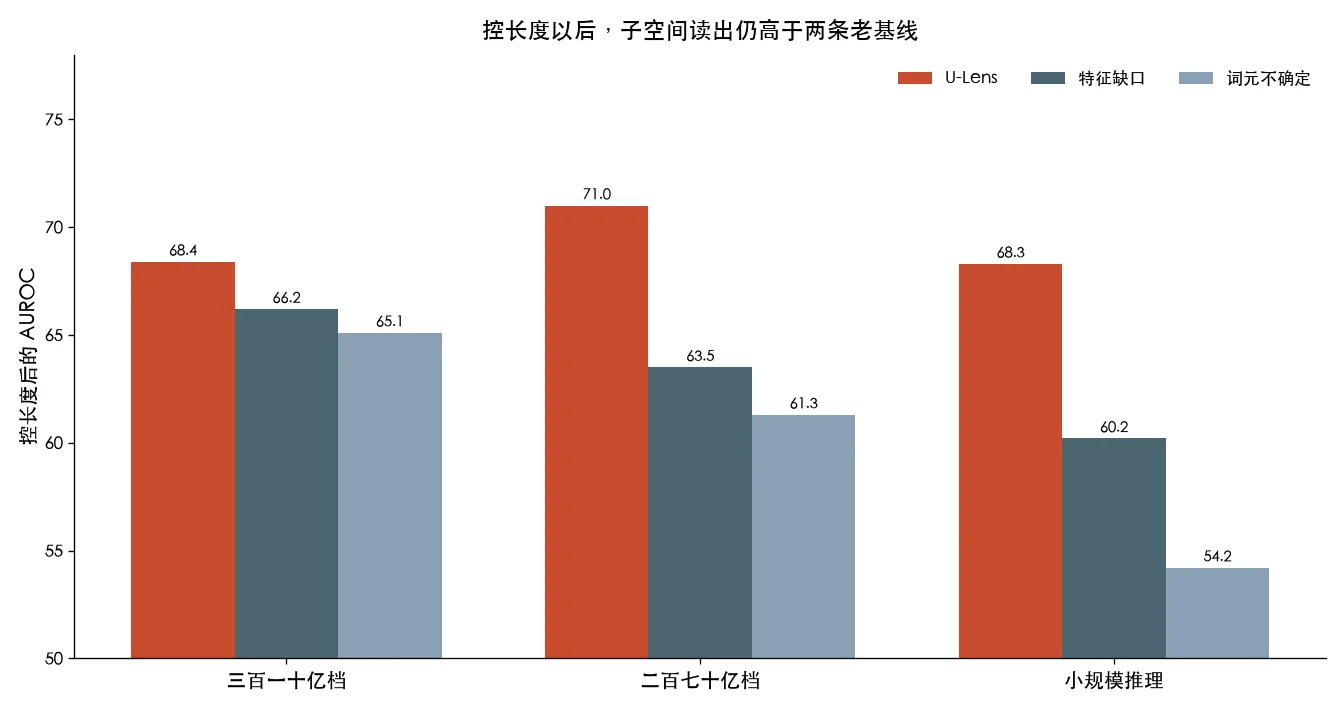
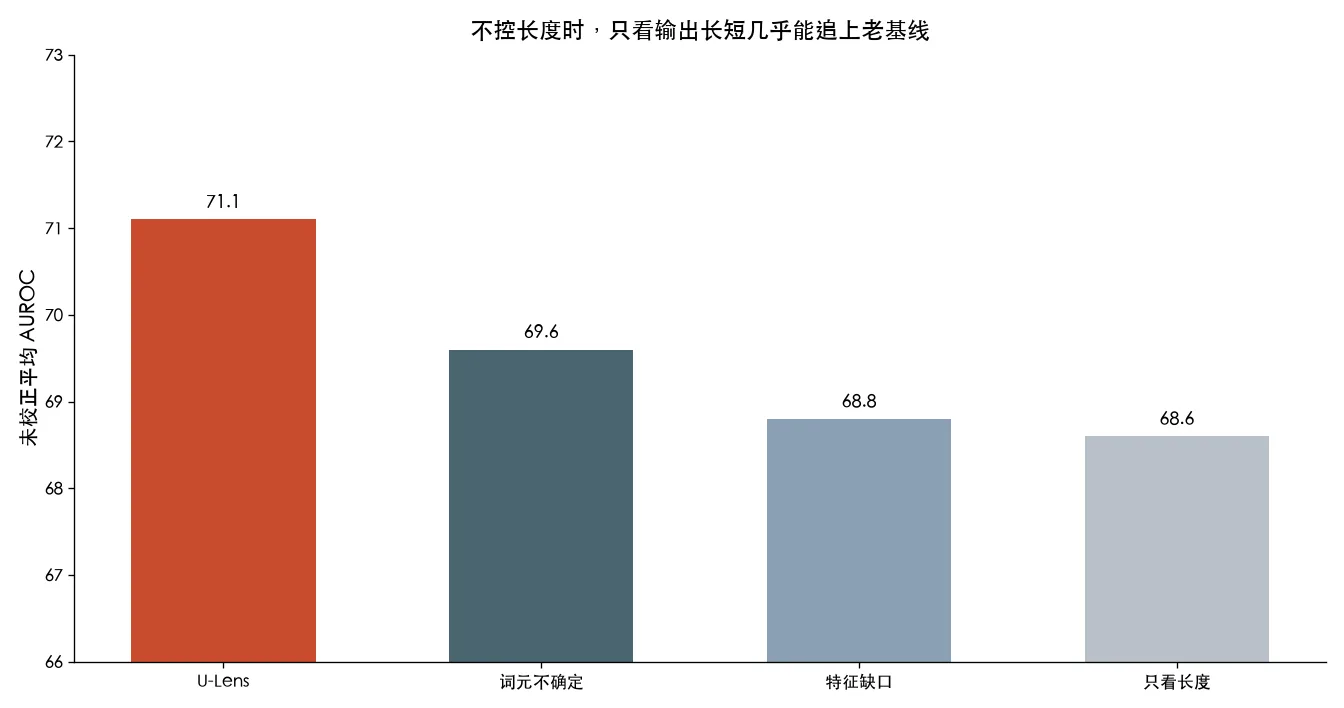
未校正平均曲线下面积:读出头 71.1 加减 4.7,词元不确定 69.6,特征缺口 68.8,只看长度 68.6。控长度分箱以后,只看长度掉到大约 52;读出头仍是 68.4、71.0、68.3,九个模型乘指标格子都高于两条老基线。拆开看:三百一十亿档 68.4,对特征缺口 66.2、词元不确定 65.1;二百七十亿档 71.0,对 63.5 和 61.3;小规模推理 68.3,对 60.2 和 54.2。只看锥体对齐、不乘熵,小规模推理仍能到 67.6,说明方向本身就在说话,不只是输出长短。
沿轴推一把,模型会犹豫
作者把读出方向加回提示或推理段,模型会放慢口气或丢掉自信,他们把这当成因果而不是只相关。同一套构造还能接到情绪和奖励作弊的读出,但正文没有把那两栏当成主表。每条样本只生成一次回复,种子写成 41 到 43。仓库写了依赖清单,论文链也在页上。六星说明复现材料还薄,但数字和读出位置都写死了。作者自己划了红线:这不是校准过的安全探测器,四类也不打算穷尽所有没把握的样子。若你要的是生产级不确定校准器,这篇还不满足;若你要看没把握是不是只等于输出熵,数字都在那一版里。本轮没有把作者花名册写进正文。