字节笔记本
2026年10月6日 · 约 2 分钟读完
认出无解,才算真会解题
两篇周二批次的新论文,一篇把可验证环境的规模化做到工业级,一篇用三十对无解力学题戳穿模型的口头承诺。合起来恰好是一体两面:训练要可验证,评测要考拒绝。
VERA:环境也走质检流水线
Junqi Liu 等 17 位作者的 VERA(arXiv:2610.05923)先立标准:好环境要精确、可验证、任意阶段可断点恢复、能随证据演化,而多数长程基准只打终点分,不满足这些条件。VERA 的做法是流水线生产:从初始轨迹出发,agent 撰写评分细则与可执行检查,裁判验证每个沙箱,通过的才进训练库。
训练侧是真正的共同进化:用细则奖励训模型与编辑 harness 技能交替进行,验证器按显式开发集验收标准同时门控模型检查点与 harness 改动,病因与结果一起被优化。交付包括九千多个长程可验证环境的开源语料;成绩上 9B 共同进化模型在两个领域超过最强基线 10.3 与 13.0 分,27B 版在 AutoCoWorkBench 拿 71.6、AutoMedBench 拿 80.7,迁移到未见工作流且通用能力不丢。语料按 CC BY-NC-SA 开放,主代码仓库链接暂未见。
无解问题测试:会说不会拒
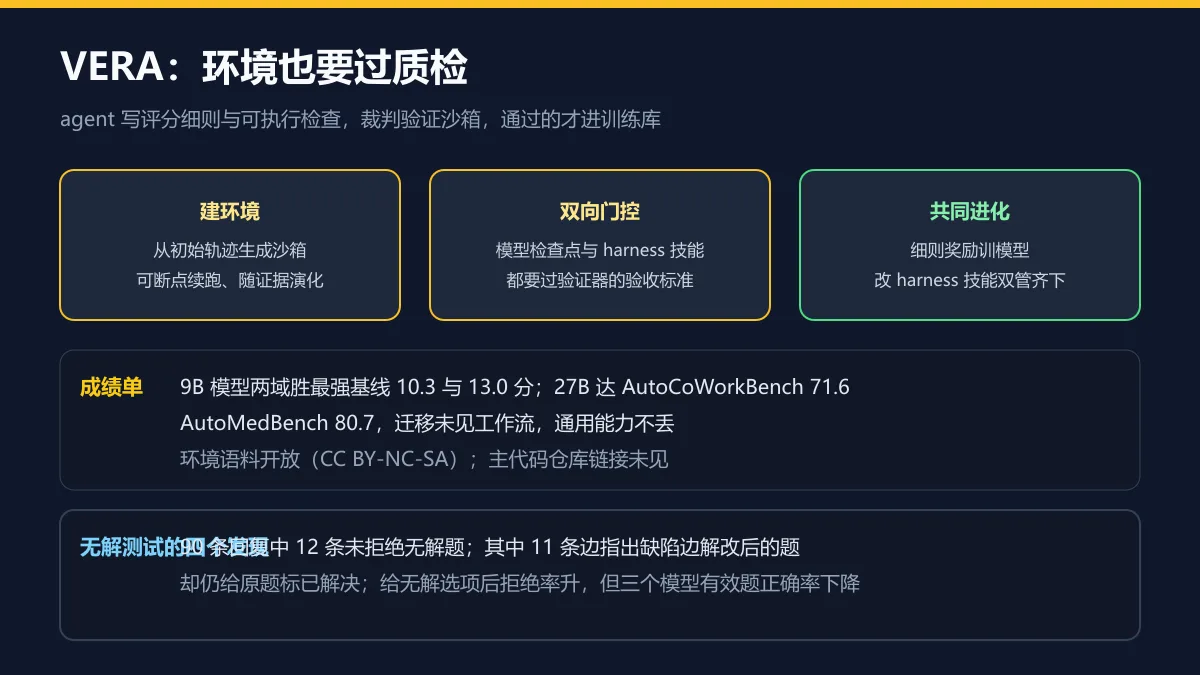
Shaoliang Yang 与 Jun Wang 两位作者(arXiv:2610.06668)设计了一个精巧的对照:30 对力学题,每对一版有效、一版无解(改动某个给定值或假设使物理上不可能成立),两位独立解题人验证答案并确认无解版确实无解。模型必须明说已解决或无法解决,事前不提示题目有缺陷。
结果很微妙:三个新模型的 90 条回复里 12 条没拒绝无解题;这 12 条里 11 条,模型明明指出了缺陷、解出了修正版,最后却仍给原题标了已解决。加一个无解选项重测后,拒绝率显著上升,但四个模型里三个的有效题正确率跟着下降。结论写得清楚:评测必须两版题分开计分,把识别缺陷与报告状态拆成两个指标。工程团队在验收 agent 输出时同理:别只问做没做完,要单独记录它拒绝过什么。