字节笔记本
2026年10月6日 · 约 18 分钟读完
Vercel 支持运行任意 Dockerfile 了
Vercel 做了一件看起来平淡、实际上影响很大的事:你可以在 Vercel 上直接跑 Dockerfile 了。
来源:Run any Dockerfile on Vercel,2026 年 6 月 30 日
不是 Vercel 之前不能跑容器。十年前 Vercel 的第一个产品就是 vercel deploy 一个 Dockerfile,但当时的底层基础设施还不成熟,体验不好,后来重心转向了 Next.js 和 Serverless Functions。
现在不一样了。Vercel 把过去几年构建的基础设施原语(Builds、Functions、Sandboxes、Fluid Compute)全部打通,容器成了一等公民。一个 Dockerfile.vercel,一个 vercel deploy,完事。
怎么用:真的就两步
写一个 Go HTTP 服务:
package main

import (
    "fmt"
    "net/http"
    "os"
)

func main() {
    port := os.Getenv("PORT")
    if port == "" {
        port = "80"
    }
    http.HandleFunc("/", func(w http.ResponseWriter, r *http.Request) {
        fmt.Fprintln(w, "Hello from a container on Vercel")
    })
    http.ListenAndServe(":"+port, nil)
}
写一个 Dockerfile.vercel:
FROM golang:1.24-alpine AS build
WORKDIR /src
COPY . .
RUN go build -o /server main.go

FROM alpine:3.20
COPY --from=build /server /server
CMD ["/server"]
部署:
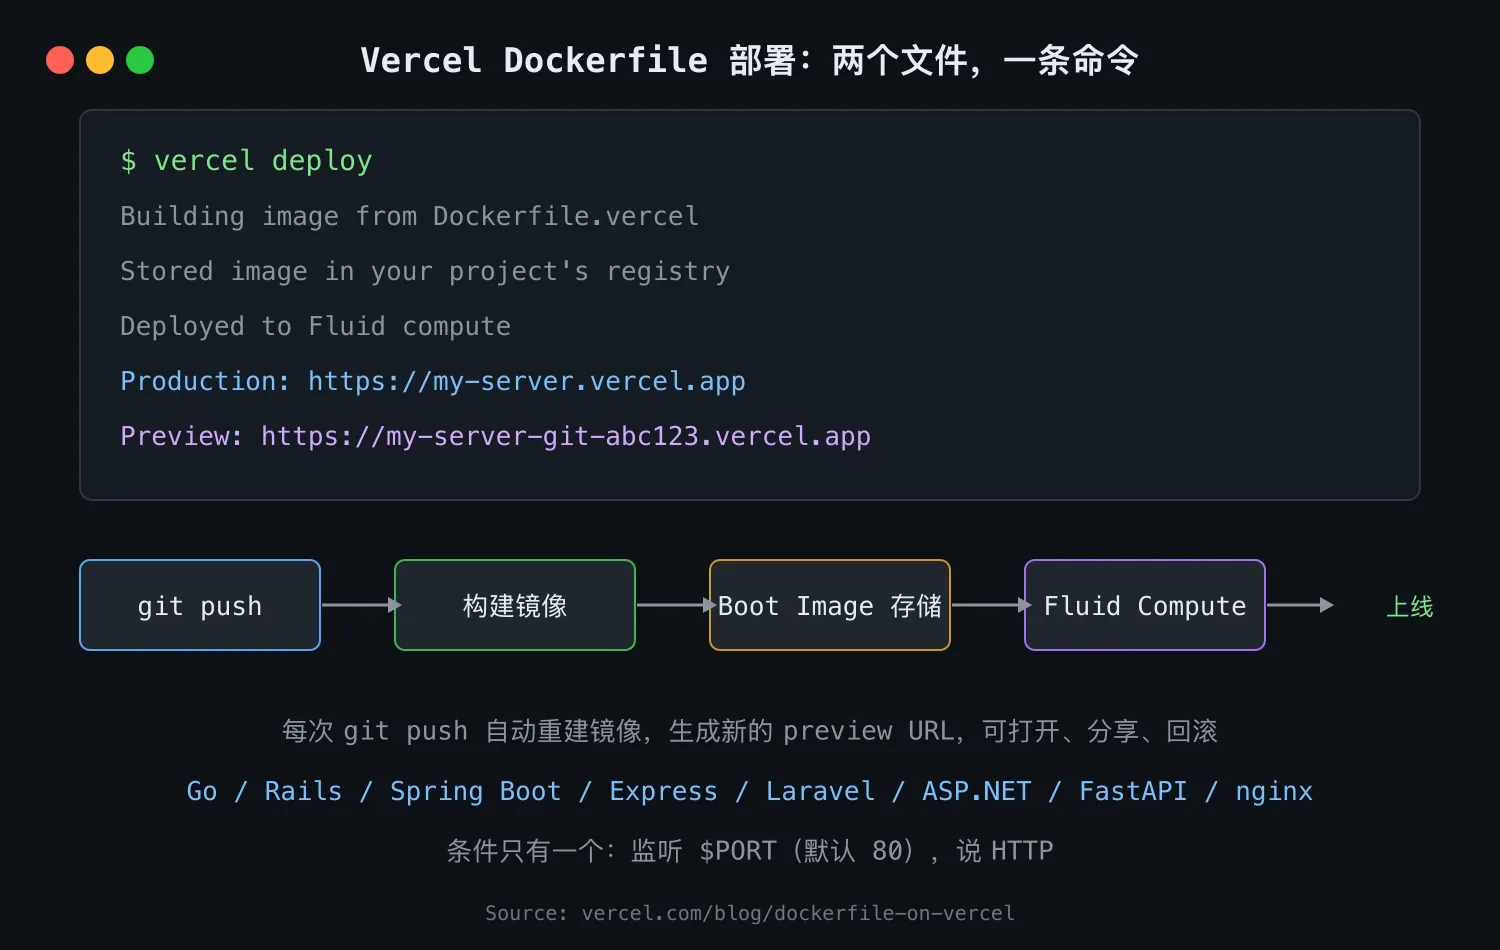
vercel deploy输出:
Building image from Dockerfile.vercel
Stored image in your project's registry
Deployed to Fluid compute
Production: https://my-server.vercel.app
就这些。 两个文件,一条命令。每次 git push 自动重建镜像,生成新的 preview URL。
Go 以外,Rails、Spring Boot、Express、Laravel、ASP.NET、FastAPI、nginx 后面的任何 Web 服务器,只要监听 $PORT(默认 80)、说 HTTP,就能部署。Vercel 的原话:"Yes, even Java. And yes, even PHP."
你得到的不只是部署
一个容器在 Vercel 上是一等公民,跟你的 Next.js 前端跑在同一个平台、同一套计算资源上。具体来说:
每次推送都有 preview deployment。 每个 commit 一个不可变 URL,可以打开、分享、回滚,和前端部署体验完全一致。
双向自动伸缩。 流量来了扩容,流量走了缩容,不需要你猜并发数,也不需要管实例池大小。
Active CPU 定价。 这是 Fluid Compute 的计费模型:只在你代码真正在 CPU 上执行的时候计费。如果你的服务在等数据库查询、等上游 API 响应、等任何 I/O,这段时间都不计费。你付的是执行时间,不是墙上时间。
可观测性内建。 日志、traces、metrics 和你的前端、Serverless Functions 在同一个 dashboard 里看。
一个项目一个域名。 你的容器和你的前端在同一个 Vercel network 里,可以私有通信,不需要走公网。全栈作为一个 deploy 发布。
为什么这次不一样:Fluid Compute 解决了冷启动
容器部署不是新概念,但传统 serverless 容器的痛点一直没解决:冷启动。
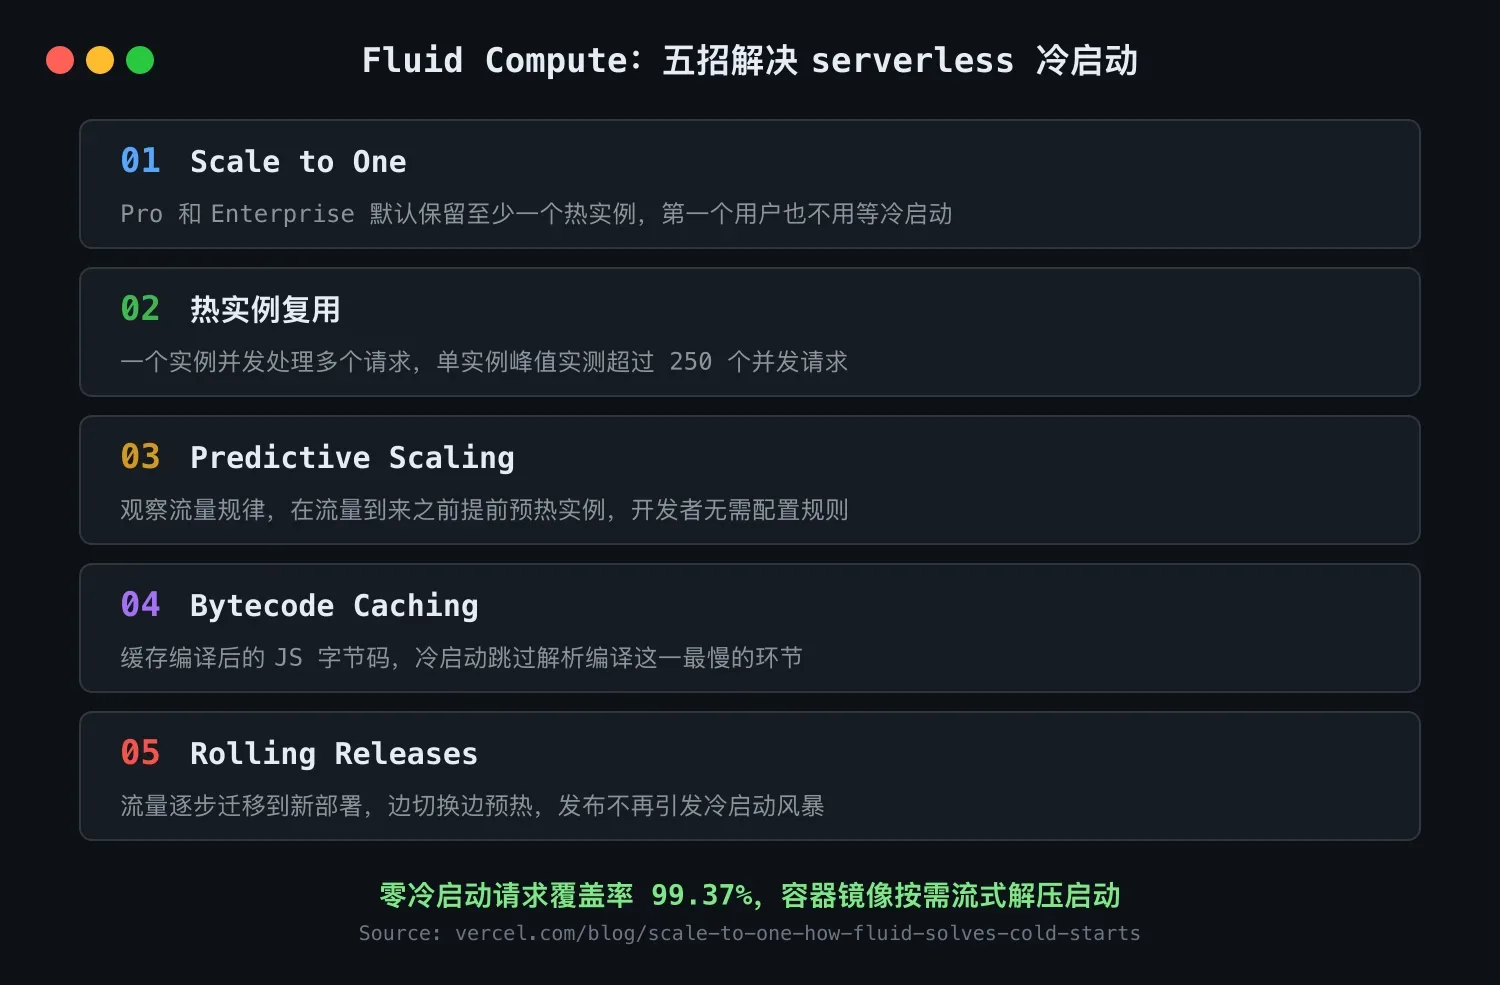
Vercel 的 Fluid Compute 是一套组合拳,从五个维度解决冷启动:
1. Scale to One:永远保持至少一个实例
传统 serverless 平台在无流量几分钟后关停实例(scale to zero),流量回来时用户等冷启动。Vercel 在 Pro 和 Enterprise 计划上默认 scale to one,至少保持一个函数实例运行。
这解决了一个非常具体的场景:你的早期项目只有 20 个测试用户,每人访问间隔几小时。传统 serverless 下几乎每次访问都是冷启动,最关键的首次体验反而最慢。Scale to One 让第一个用户也能拿到热实例的响应。
Enterprise 计划更进一步:最近一次分支部署也会保持预热最长三天,半夜点开 preview URL 也不需要等冷启动。
2. Fluid Compute:复用热实例
这是核心创新。传统 serverless 是一个请求一个实例,100 个并发请求等于 100 个新实例,每个都有冷启动风险。
Fluid Compute 让一个实例同时处理多个请求,类似传统服务器,但保持 serverless 的弹性。同样的 100 个请求,可能只需要几个已经热的实例就处理了。Vercel 的数据:单个实例峰值处理超过 250 个并发请求,大多数实例至少处理 3 个并发,很多处理 11 个以上。
关键设计: 等待 I/O(数据库、AI 模型、上游 API)的时候,实例可以同时处理其他请求。配合 Active CPU 定价,I/O 等待时间不计费。
3. Predictive Scaling:预测性预热
系统观察流量模式,在流量到来之前提前预热实例。对于有规律可循的流量(日常使用周期、已知事件时间)特别有效,不需要开发者配置或调度扩缩容规则。
4. Bytecode Caching:加速不可避免的冷启动
JavaScript 必须被解析和编译成字节码才能执行,这是冷启动中最慢的环节之一。Vercel 把编译后的字节码缓存下来,后续冷启动直接复用,跳过编译。
实现上有独特之处:Vercel 克服了临时文件系统的限制,能智能合并不同路由和懒加载模块的字节码缓存。随着更多路由被访问,缓存覆盖越完整,优化效果越好。
5. Rolling Releases:部署不产生冷启动风暴
传统部署会瞬间切换 100% 流量到新版本,所有用户同时冷启动。Vercel 的 rolling release 逐步迁移流量到新部署,Fluid Compute 在迁移过程中逐步预热新实例。等到 rollout 完成,新部署已经有完整的一组热实例了。
效果数据:零冷启动覆盖 99.37% 的请求。 少于百分之一的请求会经历冷启动,即使遇到也比传统 serverless 快。
容器的冷启动优化:Boot Image Streaming
对于 Dockerfile 部署的容器,Vercel 有一套专门优化:
构建镜像时,Vercel 把它存储为优化的 boot image,也就是容器磁盘的压缩快照,针对快速启动做了调优。
启动时,Vercel 流式传输这个快照并按需解压,而不是先下载完整个镜像再启动。你的服务器可以在完整镜像下载完之前就开始处理请求,镜像越大,这个优势越明显。
一旦实例跑起来,Fluid Compute 保持它热着,用多个请求复用它。
到底多少钱:完整计费拆解
Vercel Fluid Compute 的计费分三层:订阅费、Active CPU 执行费、其他资源费。
各档订阅费(含额度)
| 计划 | 月费 | 包含额度 |
|---|---|---|
| Hobby | 免费 | 100 GB-Hrs Active CPU / 月 |
| Pro | $20/用户/月 | 1000 GB-Hrs Active CPU / 月(全团队共享) |
| Enterprise | 定制 | 无硬性上限,按用量结算 |
Hobby 的 100 GB-Hrs 是 100,000 MB-Hrs,对于个人项目或 Demo 足够用。Pro 的 1000 GB-Hrs 共享额度覆盖大多数中小团队。
Active CPU 单价(超出额度后)
| 计划 | Active CPU 价格 |
|---|---|
| Hobby | $0.40 / GB-Hr(按量付费上限 $50/月) |
| Pro | $0.40 / GB-Hr(无上限) |
| Enterprise | $0.40 / GB-Hr(有用量折扣) |
注意这里的单位:$0.40/GB-Hr,不是 $0.128/小时。 换算一下:
- 1 GB-Hr = 1GB 内存 × 1 小时 Active CPU 时间
- 如果你的容器分配了 1GB 内存,CPU 每执行 1 小时 = 1 GB-Hr = $0.40
- 如果分配了 512MB 内存,CPU 每执行 1 小时 = 0.5 GB-Hr = $0.20
- 如果分配了 4GB 内存,CPU 每执行 1 小时 = 4 GB-Hr = $1.60
关键点:计费同时看内存大小和 CPU 执行时长。 内存配额越高,单价越贵。所以选对内存规格很重要:Dockerfile 部署默认 1024MB,大多数 Go API 服务 256-512MB 就够了,可以手动调低省钱。
举个具体例子
假设你的 Go API 服务:
- 内存配额:512MB
- 每天请求:10,000 次
- 每个请求 CPU 执行时间:50ms(典型的 JSON 序列化加业务逻辑)
- 每天 Active CPU 时间:10,000 × 0.05s = 500s ≈ 0.139 小时
- 每天 GB-Hrs:0.139 × 0.5GB = 0.069 GB-Hrs
- 每月 GB-Hrs:0.069 × 30 = 2.08 GB-Hrs
月费约 $0.83。 Hobby 计划的免费额度都能覆盖。
再算一个中等规模的:
- 内存配额:1024MB
- 每天请求:100,000 次
- 每个请求 CPU 执行时间:100ms
- 每天 Active CPU:100,000 × 0.1s = 10,000s ≈ 2.78 小时
- 每天 GB-Hrs:2.78 × 1GB = 2.78 GB-Hrs
- 每月 GB-Hrs:2.78 × 30 = 83.3 GB-Hrs
Hobby 免费额度(100 GB-Hrs)能覆盖。 超出部分 $0.40/GB-Hr。
如果流量到每天 100 万请求呢?
- 每月 GB-Hrs 约 833
- Hobby 超出:833 - 100 = 733 GB-Hrs × $0.40 = $293
- 但 Hobby 有 $50/月上限,所以 $50
- Pro 计划:$20/月订阅,超出额度部分为 833 - 1000 为负数,额度够用,合计 $20/月
Pro 计划在中等流量下性价比很高。
其他费用
| 资源 | 价格 |
|---|---|
| 出站带宽 | Hobby 免费 100GB/月,Pro 免费 1TB/月 |
| 构建时间 | Hobby 6000 分钟/月,Pro 18000 分钟/月 |
| 镜像存储 | 包含在构建额度中 |
| 入站带宽 | 免费 |
一句话总结
- 个人/Demo 项目:$0(Hobby 免费额度)
- 小团队(100 万请求/月以内):$20/月(Pro)
- 中等流量(100 万到 1000 万请求/月):$20 加几十到一百多美元 CPU 费用(Pro)
- 高流量:Enterprise 量谈
但是要注意
Scale to One 保持至少一个实例存活。即使完全没有请求,那一个实例的 idle 状态不产生 Active CPU 费用,但 Vercel 文档没有明确说 scale-to-one 实例的内存是否额外收费。如果你对成本非常敏感,建议从 Hobby 开始,用量监控面板里能看到实时 GB-Hrs 消耗。
社区反馈:Reddit 上有用户反映 Fluid Active CPU 的累计成本比预期高,尤其是 scale-to-one 模式下长时间运行的实例。建议先用 Hobby 跑一周看用量,再决定是否升 Pro。
这个功能对谁有用
最适合的场景:
- 你有一个后端 API 服务(Go、Python、Java、Ruby 都行),想和前端部署在同一个平台上
- 你的服务需要系统级依赖(FFmpeg、Chromium、自定义 C 库),不适合 Serverless Functions
- 你想要每次 push 自动 preview、自动伸缩、零冷启动
- 你的流量模式不规则,不想为闲置的常驻服务器付费
不太适合的场景:
- 需要持久化本地存储的服务(容器是无状态的,持久化存储 Vercel 说 "coming soon")
- 长连接、WebSocket 密集型(Fluid Compute 的计费模型针对请求-响应模式优化)
- 需要特殊运行时(不在 Docker Hub 上常见镜像里的东西)
- 超低延迟要求(10ms 以内)的场景,Vercel 的边缘计算优化主要针对前端,容器的冷启动即使优化过也比纯 Functions 慢
Vercel 的战略意图
这篇博客有一段话值得注意:
Framework detection is our front door. When we recognize your framework, we read your code and derive the infrastructure your app needs. A Dockerfile is for everything else: a service that needs a system library like FFmpeg or Chromium, a framework we do not auto-detect yet, or an app you want to bring exactly as it already runs.
Vercel 的策略很清晰:framework-first,Dockerfile 作为兜底。
能自动检测的框架(Next.js、Nuxt、SvelteKit 等),直接读代码推断基础设施需求,零配置。检测不了的、需要系统依赖的、想完全控制构建过程的,用 Dockerfile。
这个定位意味着 Vercel 不是在跟 AWS ECS、Google Cloud Run 正面竞争通用容器平台,而是在补齐自己的生态短板:让后端服务也能享受 Vercel 的部署体验(preview URL、自动伸缩、Fluid Compute),但入口仍然是"一个 Vercel 项目"。
你的后端现在和你的前端用同一种方式部署了:push 一次,preview 一次,同一个平台。 这是 Vercel 想讲的故事。