字节笔记本
2026年10月7日 · 约 2 分钟读完
谁给自进化的 agent 判卷?VeriFine 双循环解题
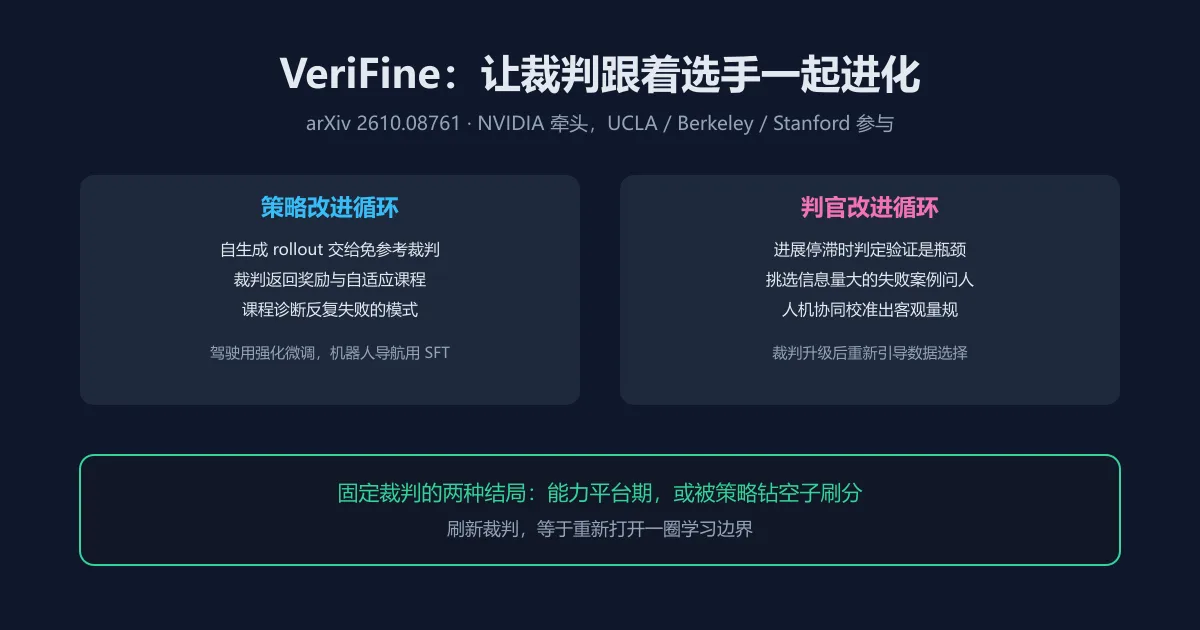
自改进 agent 的真实瓶颈,往往不在学得快不快,而在判得准不准。策略在不断进化,裁判却是训练时冻结的那一套,很快就会出现两种结局之一:要么策略能力停在裁判看得懂的地方上不去,要么策略学会钻裁判的空子刷高分。这个问题在具身推理里尤其尖锐:评价一次驾驶或导航,需要空间接地、因果推理和安全相关的判断,静态裁判根本接不住。NVIDIA 牵头、UCLA 与 Berkeley 和 Stanford 参与的 VeriFine(arXiv 2610.08761,一作为 NVIDIA 实习生 Zewei Zhou)针对这个问题给出的答案是:裁判本身也要进循环。
双循环怎么转
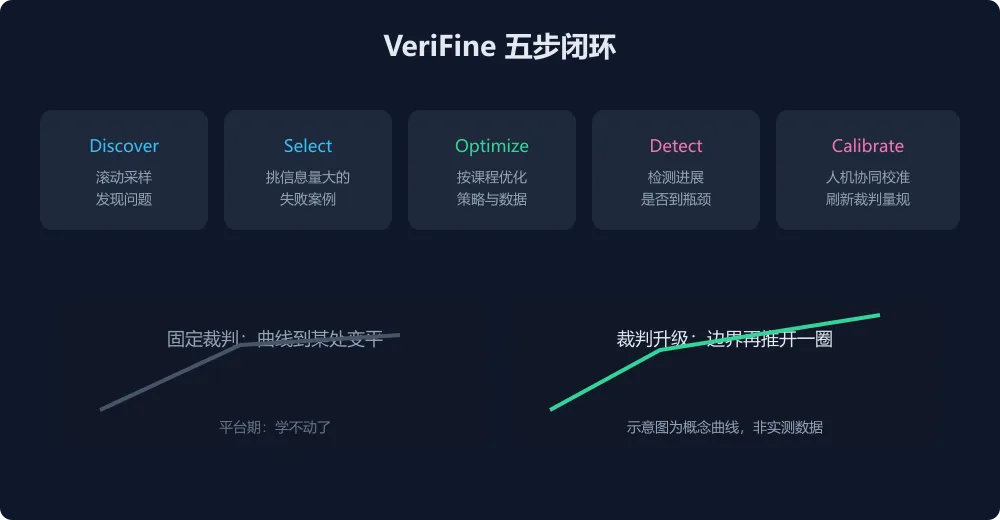
框架由两个咬合的循环构成。策略改进循环里,agent 把自生成的 rollout 交给一个免参考裁判,这里免参考是关键设计:裁判不依赖人工标注的标准答案,因此能扩到没有评测集的开放任务上。裁判返回两样东西:奖励信号,和一份自适应课程。课程负责诊断反复出现的失败模式,把训练火力集中到真正卡住的地方。判官改进循环在进展停滞时启动:系统先判定瓶颈出在验证而不是策略,然后挑选信息量最大的失败案例去问人,通过所谓协同校准,人和系统在分歧案例上各自给出判断再对齐,最终收敛到一份关于物理推理的客观量规,升级后的裁判再接手后续的数据选择与策略优化。人在这个流程里不是全程监督,只在最值得看的地方出手。整个闭环拆成五步:发现、选择、优化、探边界、校准,验证分析则覆盖多样化场景、新兴失败、裁判精修、人类对齐与测试时扩展五个阶段。
实验与诚实的边界
实验覆盖两个具身领域:驾驶任务用强化微调,机器人导航用监督微调,两个域都观察到策略与裁判的交替提升,裁判每刷新一次,策略的学习边界就被重新推开一圈。值得表扬的是项目页的诚实:曲线明确标注为概念示意而非实测数据,正文不堆砌没有出处的百分比,模型权重标注为即将发布。这在自改进这个容易被吹上天的方向上反而增加了可信度。具身场景的验证难点也交代得清楚:空间接地、因果推理、安全相关的决策,都是静态裁判接不住的活。
对做 agent 训练管线的团队,这份工作的可迁移思路有三条:把裁判当一等公民设计,而不是训练脚本的固定配件;人的反馈要花在刀刃上,挑信息量大的失败案例而不是随机抽检;检测到平台期时,先怀疑裁判再怀疑策略。顺序反了,算力就烧在错误的方向上。